紧急生产修复后,谁负责把改动同步回Git?
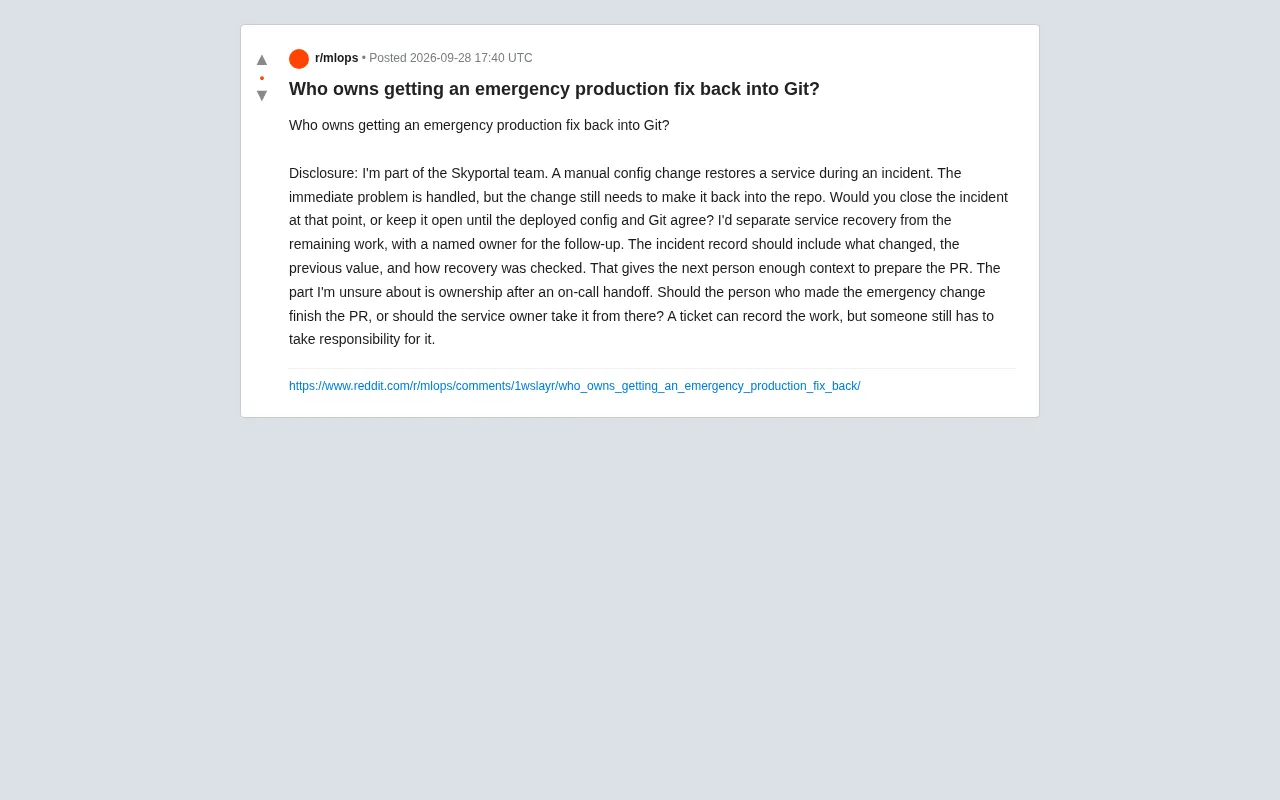
生产事故中手动修改配置让服务恢复后,如何确保改动回流Git并明确责任归属,是DevOps实践中常被忽视的闭环难题。
文章围绕一个真实运维场景展开:生产事故中工程师手动修改配置使服务恢复,但由谁负责将这个临时改动同步回Git仓库?作者认为服务恢复只是止血,配置漂移的闭环才是事故真正结束的标志。文章建议事故记录必须包含"改了什么、原始值、恢复验证方式"三要素,并将事故分为"已恢复"和"待同步"两个阶段。核心难题在于PR所有权归属:由做出改动的值班工程师收尾,能最大保留现场上下文,但影响其休息;由服务长期Owner接手,质量更有保障,但缺乏第一手信息。文章强调,无论选择哪种模式,都必须在交接时明确指定具名负责人并设定完成时限,否则这项工作极易在团队忙碌中沦为无人认领的"三不管地带",最终让配置漂移长期存在,埋下下次故障的隐患。
在生产事故处理中,运维工程师常常会手动修改配置以快速恢复服务。服务恢复了,但一个关键问题浮出水面:这个临时改动如何、由谁负责同步回代码仓库?Skyportal 团队成员在 Reddit 上抛出的这个问题,触及了 DevOps 与 SRE 实践中一个容易被忽视却至关重要的环节——配置漂移(configuration drift)的闭环治理。
服务恢复不等于事故结束
一次典型的事故场景是这样的:服务中断,值班工程师通过手动修改配置让服务恢复运行。眼前的火灭了,但部署环境中的配置与 Git 仓库里的版本已经出现分歧。此时是否应该关闭事故单?
原帖作者的观点很明确:应该把服务恢复与剩余工作分离开来。服务恢复是止血,是即时目标;而让配置与代码达成一致,则是防止问题复发、避免技术债累积的后续工作。如果在服务一恢复就关闭事故,那么这个手动改动很可能永远停留在生产环境,从未进入版本控制。
这种「配置漂移」是运维中的隐性风险。当部署的实际配置与仓库不一致时,下一次基于仓库的部署可能会覆盖掉救命的手动修改,导致故障重现——而且往往在最不该发生的时候。
配置漂移(Configuration Drift) 是指运行环境中的实际配置随时间推移逐渐偏离其"期望状态"(通常是代码仓库中声明的版本)的现象。在 IaC(Infrastructure as Code)和 GitOps 实践中,Git 仓库被视为单一可信来源(Single Source of Truth),任何绕过版本控制的手动变更都会在两者之间制造裂缝。配置漂移的危险在于它的累积性和隐蔽性:单次手动改动可能微不足道,但多次累积后,生产环境可能已与仓库相差甚远,团队对"线上跑的究竟是什么"失去准确认知。当灾难恢复(DR)演练或蓝绿部署触发一次全量重新部署时,所有未回流 Git 的手动修改都会被静默覆盖,这往往是故障循环重演的根本原因。工具层面,Puppet、Chef、Ansible 等配置管理工具以及 Flux、ArgoCD 等 GitOps 控制器均内置了"配置对账"(reconciliation)机制,会周期性检测并强制纠正漂移,但前提是团队必须先把正确配置写回 Git。
事故记录里应该写清什么
作者建议,事故记录不应只是「已恢复」三个字,而应包含足够的上下文,让下一个接手的人能够准备出准确的 PR。具体应记录三类信息:
- 改了什么:具体修改的配置项与新值
- 原来的值是什么:便于对比、回溯,也为回滚提供依据
- 恢复是如何验证的:确认服务确实恢复的检查方式
这三点看似基础,却是很多团队事故复盘时最容易缺失的。没有「原值」,后续做 PR 的人无法判断改动的真正意图;没有验证方式,就无法确认修复是否真的有效,还是只是暂时掩盖了症状。清晰的事故记录,本质上是把值班时刻脑中的隐性知识固化为团队可复用的显性资产。
真正的难题:所有权归属
帖子里作者坦言自己也不确定的部分,恰恰是最有价值的讨论点——在值班交接之后,谁来完成这个 PR?
这里存在两种合理但相互竞争的观点:
观点一:由做出紧急改动的人收尾
做出改动的值班工程师最了解当时的情境:为什么这么改、试过哪些方案、有哪些边界条件。让他们完成 PR,能最大程度保留改动的原始意图,减少信息在交接中的损耗。缺点是,值班结束后这些人可能已经下班、轮岗,强行让他们收尾会打乱作息节奏,也不利于长期可持续的值班文化。
观点二:由服务负责人接手
服务的长期 owner 对代码库整体结构、代码规范、长期演进方向更熟悉,由他们把临时改动转化为符合规范的正式提交,质量往往更有保障。缺点是他们缺少事故现场的第一手上下文,如果事故记录不够详尽,很容易做出偏离原意的 PR。
作者点出了问题的核心:「工单可以记录这项工作,但终究得有人对它负责。」流程和工具只能承载信息,无法替代明确的责任归属。一个没有指定负责人(named owner)的后续任务,在忙碌的团队里最容易沦为「三不管地带」,最终不了了之。
这一所有权困境在 SRE 领域有一个对应的制度参照:Google SRE 体系中的 Postmortem 文化要求,每一项事故后续行动(action item)必须有且仅有一个具名负责人(single owner)与截止日期,而非笼统地归属于某个团队。没有具名负责人的 action item 在统计上几乎等价于"不会被完成"。类似地,ITIL 框架将事故(Incident)与问题(Problem)管理明确分离:事故管理的目标是最快恢复服务,问题管理的目标是找到根因并永久修复——将配置漂移回流 Git 本质上属于问题管理的范畴,理应在事故单关闭后由独立的问题单跟踪,并绑定明确的负责人。这种制度层面的分离,正是许多成熟工程团队避免"责任真空"的关键设计。
从这场讨论中提炼的实践建议
综合原帖的思路,一套更完整的处理框架可以是这样的:
- 事故分两阶段:服务恢复后不直接关闭,而是转入「待同步」状态,明确剩余工作。
- 强制记录三要素:改了什么、原值、验证方式,作为事故单关闭的前置条件。
- 指定明确负责人:无论是原值班人还是服务 owner,都要在交接时白纸黑字写清由谁负责 PR,避免责任真空。
- 设定完成时限:给同步工作一个 SLA,防止配置漂移长期存在。
值得深思的是,这个问题没有放之四海皆准的答案。团队规模、值班制度、服务复杂度都会影响最优选择。小团队可能默认由改动者收尾更高效;成熟的大型工程组织则更可能通过明确的 owner 制度和自动化工具(如配置即代码的持续对账)来兜底。
归根结底,紧急修复回流 Git 的所有权问题,考验的不是工具,而是团队的责任文化与流程设计。谁按下了那个临时修改的按钮固然重要,但更重要的是——有没有人愿意、并且被明确要求,去为闭环负责。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。