旧结论遇新模型:LLM复现研究的启示

模型快速迭代使LLM旧结论悄然失效,大规模复现将其变为可观测事实。
文章从 Hacker News 上一则关于用新模型大规模复现 LLM 旧研究结论的讨论帖出发,指出模型版本以月为单位迭代,使大量「LLM 会 X」式论断在换代后既未被证伪也未被证实,只是悄然失效。复现的真正难点不在跑通脚本,而在提示词与解码参数的敏感性、评测集污染与模型静默更新、以及结论表述粒度过粗三点。文章进一步提出大规模复现的三重影响:凸显结论时效性、改变文献引用方式、提供低门槛研究切入点,并强调公开可追踪的结果库对论文可信度与工程选型的价值。
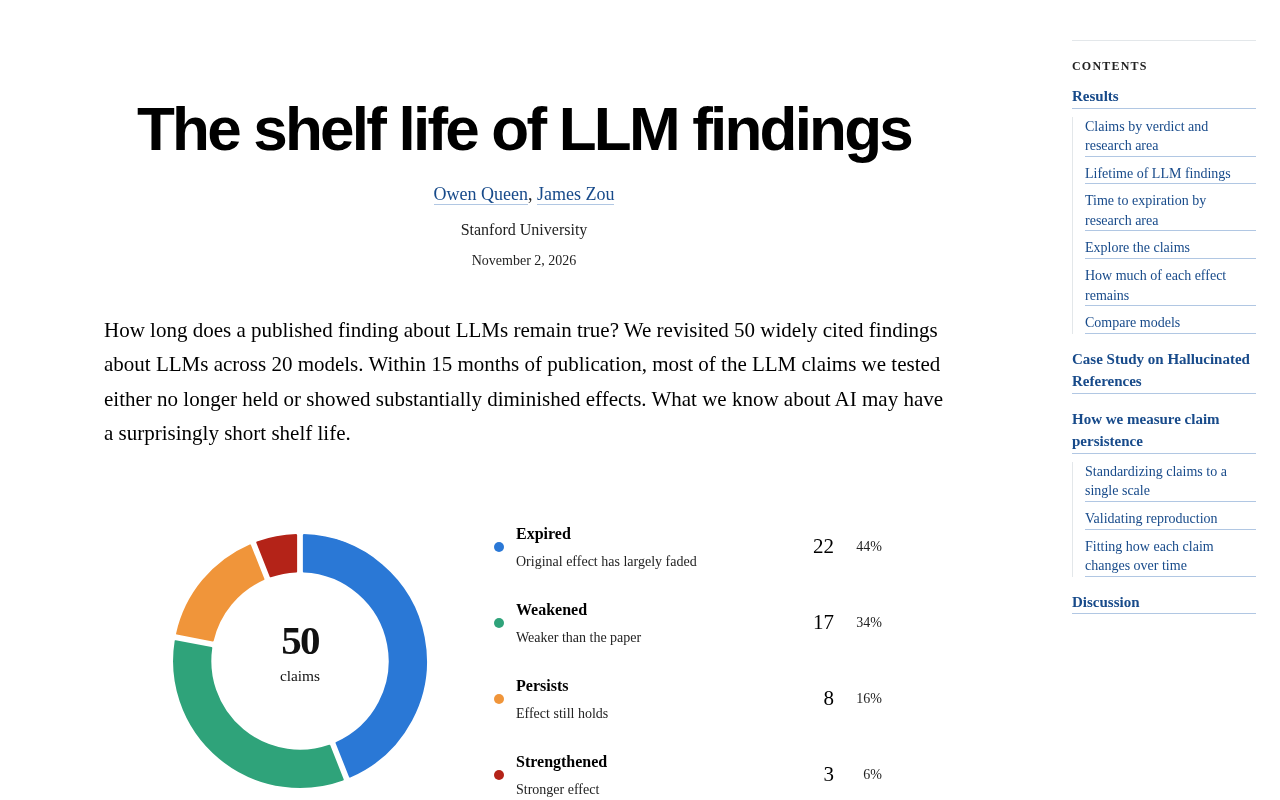
Hacker News 上出现了一个标题颇为直白的讨论帖:「Mass attempted replication of old findings of LLMs with new models」——用新一代模型大规模复现关于大语言模型的旧研究结论。帖子本身只有 5 分、0 条评论,信息量有限,但它指向的问题在当下的 AI 研究生态中越来越尖锐:当模型版本以月为单位迭代,那些写进论文、被反复引用的「LLM 会 X」式结论,还站得住吗?
为什么「复现」在 LLM 时代变得棘手
传统实验科学里,复现是检验结论可靠性的基本动作。但 LLM 研究的复现面临一个特殊困难:研究对象本身在漂移。同一段提示词、同一套评测流程,换成新版本模型,输出分布可能已经明显不同——旧论文观察到「模型在推理任务上倾向走捷径」或者「对某类指令存在系统性偏差」,未必能在新模型上重现。
这带来一个尴尬的处境:大量论文的结论其实是「某个时间点的某个模型表现出某种行为」,却常被表述为关于「LLM」的一般性论断。当模型换代,这些论断既没有被证伪,也没有被证实,只是悄悄失效。大规模复现尝试的价值,就在于把这种「悄悄失效」变成可观测、可讨论的事实。
可复现性(reproducibility)在计算科学中通常指他人依据论文描述能够重跑实验并得到一致结果。机器学习领域近年进一步区分了若干层次:repeat 指同一作者用同一代码重跑,replicate 指他人用新实现在新数据上检验结论,reproduce 则介于两者之间。三者对一致性的要求依次放宽。
对于 LLM,最严格的问题在于实验对象不可冻结:闭源模型无法固定权重,开源模型也会因推理框架、量化精度和硬件差异产生数值级偏差。因此社区更强调可复现性报告规范,例如在论文中标注模型名称与快照标识、API 访问日期、完整提示词和解码配置。这类规范的意义不在于保证结果完全一致,而在于让后来者能判断差异究竟源自方法还是环境。
复现实验真正的难点不在跑通脚本
从工程角度看,复现一篇 LLM 论文远比复现一个经典机器学习实验麻烦。
提示词与解码参数的敏感性
很多结论依赖特定的提示模板、few-shot 示例数量、temperature 设置。原文未必完整记录这些细节,而复现者稍作调整就可能得到不同结果。于是「复现失败」本身也变得难以归因:是结论不成立,还是复现方式不走运?
提示模板(prompt template)是围绕任务指令组织的固定文本骨架,通常包含角色设定、任务描述、输入占位符和输出格式要求。few-shot 示例是在提示中给出若干输入—输出示范,让模型通过上下文学习模仿格式与风格,示例的数量、选取和排列顺序都会显著影响输出。
temperature 是控制采样随机性的解码参数:取值趋近 0 时模型倾向选择概率最高的 token,输出更确定;取值升高则采样分布更平坦,多样性增加但稳定性下降。与之相关的还有 top-p(核采样)与 top-k,它们共同决定候选 token 的截断范围。
这些参数之所以成为复现障碍,是因为它们常常未被完整报告,而 LLM 的输出对它们高度敏感——同一个结论可能在 temperature=0 时成立、在默认采样下消失。复现研究的规范做法是公开完整提示文本、示例集合与全部解码参数,并对关键结论做参数扫描而非单点验证。
评测集污染与版本漂移
公开评测集在训练数据中的出现概率随模型更新而变化,旧评测的分数因此失去可比性。同时,API 模型存在静默更新,同一模型名在不同时间可能对应不同权重。这两点叠加,使得跨版本对比的结论需要格外谨慎的解读。
评测集污染(benchmark contamination)指公开评测集的题目或答案以某种形式进入了模型的训练语料,使模型在评测上的表现无法反映其真实泛化能力。随着模型训练数据规模扩大、抓取范围变广,一条评测题目从发布到被「记住」的时间窗口越来越短。复现旧论文时,如果新旧模型对同一评测集的污染程度不同,分数差异就可能来自记忆而非能力提升。因此严谨的做法是区分「闭卷」与「开卷」场景,或使用发布时间晚于模型训练截止日期的评测集(contamination-free benchmark)。
版本漂移则包含两层含义。一层是模型本身的迭代:同一 API 名称下,服务方可能在不通知的情况下替换底层权重、调整系统提示或安全策略。另一层是评测环境的漂移:库版本、默认解码参数、分词器细节都可能变化。两者叠加意味着「同名模型」并不等于「同一实验条件」,复现记录中必须标注访问时间戳,否则跨版本比较缺乏可比性。
结论表述的粒度问题
「LLM 具备某种能力」这种粗粒度断言,在新模型上往往既对又不对——在特定任务格式下成立,换一种问法就失效。复现研究因此需要把结论拆细,明确它成立的边界条件,而不是简单地打勾或打叉。
大规模复现对研究实践的三个影响
第一,它把「结论的时效性」推到台前。论文写作中或许需要更明确地标注模型版本、访问时间和评测配置,把结论锚定在具体条件下,而不是泛化为关于智能体的一般规律。
第二,它改变了文献引用的方式。当旧结论的可复现性存疑,后续研究直接引用其论断作为前提就存在风险,更稳妥的做法是重新验证关键基线。
第三,它为研究者提供了低成本的切入点。相比提出全新方法,系统性的复现与边界刻画同样产生知识增量,而且对社区的价值往往被低估。
一个值得关注的信号
这条帖子热度不高,却折射出研究社区正在形成的共识:LLM 领域的知识积累不能只靠不断叠加新结论,还需要有人回头检查旧结论是否依然成立。大规模复现尝试如果能够形成公开的、可追踪的结果库,对论文可信度和工程选型都有实际意义。
原文提供的信息仅限于标题本身,缺乏具体实验范围、涉及的模型代际和复现成功率的细节。要评估这项工作的方法严谨性,仍需等待更完整的材料。但问题意识本身已经足够清晰:在一个模型快速迭代的领域里,「当时成立」和「现在仍成立」是两件事,而后者需要被持续检验。
常见疑问
复现失败是否意味着原论文有错? 不一定。更常见的情况是结论依赖的模型行为发生了变化,或复现配置与原文存在差异。需要区分「结论错误」与「结论不再适用」。
普通开发者能从复现研究里获得什么? 主要是对模型行为稳定性的判断。了解哪些能力或偏差容易随版本漂移,有助于在工程中设计更稳健的提示与兜底策略。
这类研究应该关注哪些指标? 相比单一成功率,结论在不同提示变体、不同模型版本下的一致性更有参考价值。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。