开发者实测Opus 5.5:从弃用Claude到重度依赖的转变

开发者因Opus 5.5的能力与成本优势,从Codex彻底回归Claude生态。
一位曾因失望而弃用Claude、转投OpenAI Codex的重度开发者,在Opus 5.5发布后发生了彻底转变,此后再未使用过Codex。他对Opus 5.5的核心赞誉集中在三点:任务自主性强(几乎无需人工反复引导)、设计与后端策略能力出色,以及成本优势惊人——同等预算下,其产出效能较Fable 5.1提升约一个数量级。不足之处在于多账户连接器和计算机操作等基础设施层面仍落后于Codex,但他认为这些均非致命缺陷。文章同时指出,该用户对模型后续可能被"量化或缩水"的担忧,折射出当前闭源AI服务普遍存在的信任问题。
一位开发者的真实转变
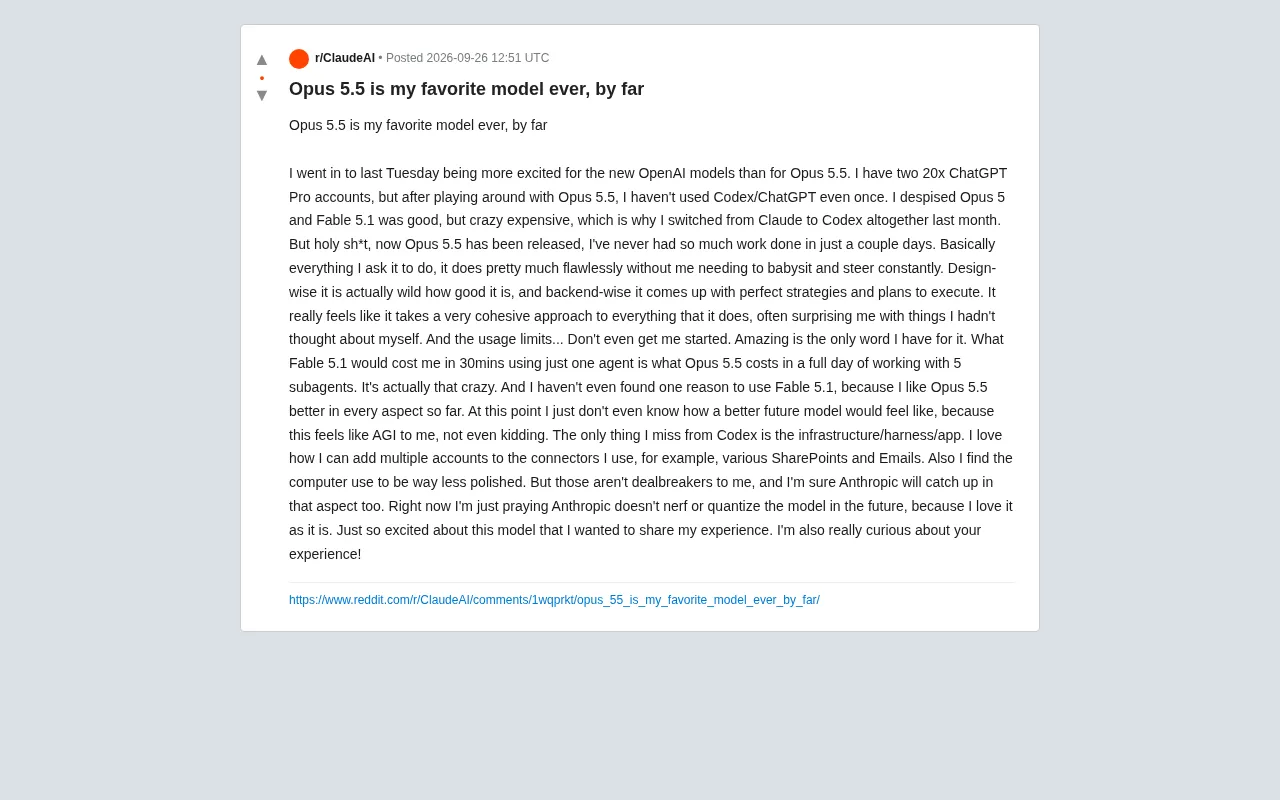
在AI编程模型的选择上,很多重度用户的忠诚度往往只维系于最新一次的实际体验。一位Reddit用户分享的经历就颇具代表性:他原本手握两个ChatGPT Pro账户(20x套餐),甚至在上个月因为对Opus 5的失望而彻底从Claude转投OpenAI的Codex阵营。然而Opus 5.5发布后,情况发生了戏剧性反转——他坦言自那以后再没打开过Codex/ChatGPT一次。
这种态度的急转直下值得玩味。他明确表示自己「讨厌Opus 5」,而对Fable 5.1的评价则是「好用但贵得离谱」,正是高昂的成本促使他放弃了Claude生态。这说明模型能力和性价比在专业用户的决策中占据同等重要的地位。
能力评价:设计与后端的双重突破
这位用户对Opus 5.5的核心赞誉集中在「自主性」上。他描述几乎所有交给模型的任务都能「近乎完美地完成,无需时刻盯着和反复引导」——这一点对于实际生产环境中的开发者尤为关键,因为频繁的人工纠偏本身就是效率杀手。
在具体能力维度上,他给出了两方面的评价:
设计层面
他用「wild(离谱地好)」来形容模型的设计能力,认为其在UI/前端设计上的表现远超预期。
后端策略
后端方面,模型能够拿出「完美的策略和执行计划」。更让他印象深刻的是模型展现出的整体协调性——它对任务采取一种连贯一致的处理方式,甚至能提出用户自己没有想到的思路。这种「主动补位」的能力,是许多用户认定一个模型「好用」的隐性标准。
成本对比:数量级的差异
如果说能力提升还属于渐进式改善,那么成本表现则被这位用户形容为「amazing」。他给出了一组极具冲击力的对比数据:
Fable 5.1 用单个agent工作30分钟所消耗的成本,相当于 Opus 5.5 用5个子agent(subagents)工作一整天的花费。
这意味着在同等预算下,Opus 5.5的实际产出能力提升了一个数量级。对于依赖多agent并行工作的重度开发者而言,这种成本结构的改变直接决定了工作流的可行性。也正因如此,他表示已经找不到任何继续使用Fable 5.1的理由——在他看来Opus 5.5在各个方面都更胜一筹。
多Agent(Multi-Agent)工作流是指将一个复杂任务拆分后,由多个AI实例并行或协作完成,以提升处理速度和覆盖广度。Subagent(子代理)是其中承担具体子任务的独立执行单元,常见于代码生成、测试、文档撰写等可并行化的开发场景。这种模式对Token消耗极为敏感:单次会话的成本会随并发代理数量线性甚至超线性增长。因此,模型定价对采用多Agent架构的重度用户而言影响远超普通用户——当并发5个子代理跑满一整天的成本仅相当于竞品单代理运行30分钟时,这种差异直接决定了某类工作流在经济上是否可行,而不只是「更划算」的问题。
仍存在的短板:生态与基础设施
即便是如此高的评价,这位用户依然指出了Opus 5.5相较Codex的不足,主要集中在基础设施和应用层面(infrastructure/harness/app):
- 多账户连接器:他很欣赏Codex能够为连接器添加多个账户,比如接入多个SharePoint和邮箱,这对企业级工作流很有价值。
- 计算机操作(computer use):他认为Opus 5.5的电脑操作能力打磨得不够精细。
不过他强调这些都不是「dealbreaker(致命缺陷)」,并相信Anthropic会在这些方面逐步追赶。这一评价客观呈现了模型能力与产品工程化之间的差距——强大的底层模型未必等同于完善的产品体验。
**Computer Use(计算机操作)**是指AI模型直接控制桌面环境,通过截图感知屏幕状态、模拟鼠标点击和键盘输入来完成任务,本质上是把AI变成一个能操作GUI的自动化代理。Anthropic于2024年底率先将该能力集成进Claude模型,OpenAI的Codex也提供类似的代码执行沙箱与环境操作能力。这类功能对企业场景价值显著——例如自动填写Web表单、操作本地IDE或跨系统搬运数据——但因其需要精细的视觉定位与动作序列规划,容错率低,实际可用性远比纯文本生成任务更难打磨到生产级水准,这也正是该用户批评Opus 5.5在此维度「不够精细」的背景所在。
「感觉像AGI」背后的冷思考
这位用户在文中激动地表示「这感觉就像AGI,我不是开玩笑」,甚至坦言想象不出更好的未来模型会是什么样子。这类表述在模型发布初期的社区讨论中并不罕见,往往反映的是使用者在特定工作流下的主观峰值体验,而非严格意义上的能力评估。
值得留意的是他文末的一句「祈祷」:希望Anthropic未来不要对模型进行「nerf或量化(quantize)」。这道出了许多用户的共同焦虑——发布初期的模型表现有时会在后续版本迭代或推理成本优化中出现下滑。这种对「模型缩水」的担忧,本身也是当前闭源AI服务信任问题的一个缩影。
用户担心的「nerf或量化」现象有其技术背景。**模型量化(Quantization)**是指将模型权重从高精度浮点数(如FP32/BF16)压缩为低位整数(如INT8、INT4),以换取更低的推理成本和更快的响应速度,但通常会带来细微的能力损失。Nerf(来自游戏术语"削弱")在AI社区则泛指厂商通过调整系统提示、安全过滤策略或RLHF微调来限制模型的某些行为,导致用户感知到的「聪明程度」或「执行力」下降。由于闭源模型的版本变更对外不透明,用户往往难以区分性能下滑是源于量化、策略调整还是服务端负载问题,这种信息不对称正是社区对「模型缩水」形成集体焦虑的根本原因。
结语:单一体验的价值与局限
这篇分享虽然是单一用户的主观感受,但其价值在于提供了一个从「弃用」到「重度依赖」的完整心路历程,涵盖了能力、成本、生态三个维度的横向对比。对于正在Claude、Codex、Fable等方案之间摇摆的开发者,这样的一手体验具有参考意义。
当然,作为社区个人反馈,其结论仍需更多用户的交叉验证。模型的实际表现会因任务类型、使用习惯和预算规模而异,「最爱的模型」终究是一个高度个人化的判断。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。