开放权重AI被禁了吗?一场关于AI监管的争论
开放权重AI尚未被全面禁止,但围绕安全、国家战略与创新自由的监管争论正在加剧。
「开放权重AI被禁了吗?」这一问题折射出当前AI治理的核心张力。开放权重模型(如Meta Llama系列)允许任何人下载、本地部署并自由修改模型参数,与依赖云端API的封闭模型形成根本区别,是当前AI创业生态繁荣的重要基础。围绕其监管的担忧主要来自两个方向:一是安全护栏可被低成本移除、模型发布后无法召回;二是地缘政治竞争背景下对技术优势外泄的忧虑。支持开放的一方则认为,透明度本身是安全保障,限制开放会将AI能力集中于少数巨头。目前,全面禁令尚不存在,但高能力模型的评估义务和潜在限制正成为各国政策讨论的焦点,监管边界仍处于动态博弈之中。
一个尖锐的提问
近日,一个名为「Is open-weight AI banned yet?」(开放权重AI被禁了吗?)的话题出现在Hacker News社区,尽管热度尚不高,却触及了当前AI治理领域最具争议的核心议题之一——开放权重模型(open-weight AI)的监管与生存空间。
这个看似简单的疑问背后,隐藏着技术开放性、国家安全、商业利益与创新自由之间的深层张力。它反映出开源AI社区的一种普遍焦虑:随着大模型能力不断增强,监管的达摩克利斯之剑是否正悬在开放权重模型头顶?
什么是开放权重AI
理解这个问题,首先要厘清「开放权重」的含义。所谓开放权重模型,是指模型的训练参数(权重)对公众公开、可下载、可本地部署的AI模型。Meta的Llama系列、Mistral、以及国内的一些模型都属于这一范畴。
需要区分的是,「开放权重」与「完全开源」并不完全等同。开源通常意味着训练代码、数据集与权重全部公开,而开放权重往往只公开模型参数,训练数据和完整流程可能仍是封闭的。即便如此,开放权重已经赋予了开发者极大的自由度:可以本地运行、微调、二次开发,不依赖任何厂商的API和云服务。
这种开放性是当前AI生态繁荣的重要基础。大量创业公司、研究机构和独立开发者正是站在开放权重模型的肩膀上,才得以低成本地构建应用。
从实际影响来看,开放权重模型的出现从根本上改变了AI的权力结构。在此之前,运行一个高性能语言模型意味着必须调用OpenAI、Anthropic或Google的付费API,数据会经过第三方服务器,使用条款由平台单方面制定。2023年Meta发布Llama系列后,开发者第一次可以将一个接近GPT-3.5水平的模型完整运行在本地机器甚至消费级显卡上。这一转变的意义不仅是「免费」,更在于数据主权、离线可用性和不受平台政策约束的自由度。正因如此,开放权重模型在医疗、法律、政府等数据敏感行业获得了封闭API难以企及的渗透率,也成为全球南方国家和资源有限的研究机构进入AI领域的重要通道。
监管的担忧从何而来
围绕开放权重AI的监管讨论,主要源于几个层面的担忧。
安全与滥用风险
监管方最常提及的理由是安全问题。一旦模型权重公开,任何人都可以下载并移除其中的安全护栏(safety guardrails),用于生成有害内容、协助网络攻击,甚至涉及生物、化学等敏感领域的信息辅助。与封闭的API模型不同,开放权重模型一经发布便无法「召回」,厂商也无法通过后端干预来阻止滥用。
「移除安全护栏」在技术上的门槛远比想象中低。主流方法包括:对开放权重模型进行针对性微调(用少量有害样本覆盖原有对齐训练),或直接使用系统提示工程绕过输出过滤。2023年多项学术研究表明,针对Llama等模型的「越狱微调」只需数百条样本和数小时的消费级GPU时间即可完成。这一现实使得「发布即失控」的担忧并非危言耸听。然而,反方同样有有力的数据支撑:针对生物武器合成等极端场景的研究显示,开放权重模型提供的信息增益极为有限,远低于专业教科书或现有网络资源,真正的「双重用途」风险集中在极少数能力边界处的前沿模型,而非当前已广泛流通的主流开放权重版本。
国家安全视角
在地缘政治背景下,一些政策制定者担心先进模型权重的公开会削弱本国的技术领先优势,或被竞争对手直接利用。这使得开放权重问题超越了单纯的技术讨论,进入国家战略层面。
这一视角在美国政策层面已产生实质性影响。2024年美国商务部针对先进AI芯片出口的管控(主要针对H100等训练硬件)与开放权重监管讨论形成了政策组合拳——前者试图从算力源头限制他国训练能力,后者则讨论是否应限制权重本身的传播。部分政策研究者援引的类比是「核技术扩散」框架,认为超过某一能力阈值的模型权重应被视为需要管控的「战略资产」。批评者则指出这一类比存在根本性缺陷:核材料是物理稀缺的,而模型权重是可无限复制的数字文件,一旦泄露或公开便不可能通过监管手段实现真正的访问控制,过度的管控反而可能使监管成本转嫁给合规的本国企业,而对实际的恶意行为者毫无约束力。
创新与开放的辩护
另一方则坚定捍卫开放权重的价值。他们认为,开放是安全的助推器而非敌人——公开的模型能被全球研究者审查、发现漏洞、共同改进,这种「阳光下的透明」比黑箱式的封闭系统更可信。同时,限制开放权重将扼杀中小开发者的创新空间,把AI能力垄断在少数巨头手中。
现状:尚未被全面禁止
回到最初的问题:开放权重AI被禁了吗?就目前的公开情况而言,答案是否定的——尚不存在对开放权重模型的全面禁令。主流的开放权重模型仍在正常发布和迭代,开发者社区依然活跃。
不过,监管的边界正在被反复讨论和试探。各国和地区对AI的监管框架仍处于成型阶段,针对高能力模型(frontier models)的评估、报告义务和潜在限制,是政策辩论的焦点。开放权重是否会在未来面临针对性约束,仍是一个开放的问题。
这场争论的意义
这条Hacker News帖子本身热度有限、评论为零,但它所抛出的问题极具代表性。它提醒我们,AI的发展不只是技术竞赛,更是一场关于「开放还是封闭」的价值观博弈。
开放权重模型代表的是一种去中心化、协作式的技术演进路径;而监管压力则体现了社会对失控风险的本能防御。这两股力量的拉锯,将在相当长的时间里塑造AI生态的走向。
对于开发者和企业而言,持续关注监管动向、理解开放权重的合规边界,已经成为一项必要功课。而对于整个行业,如何在保障安全的前提下守护开放创新的火种,则是一道尚无标准答案的难题。
相关推荐
Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。
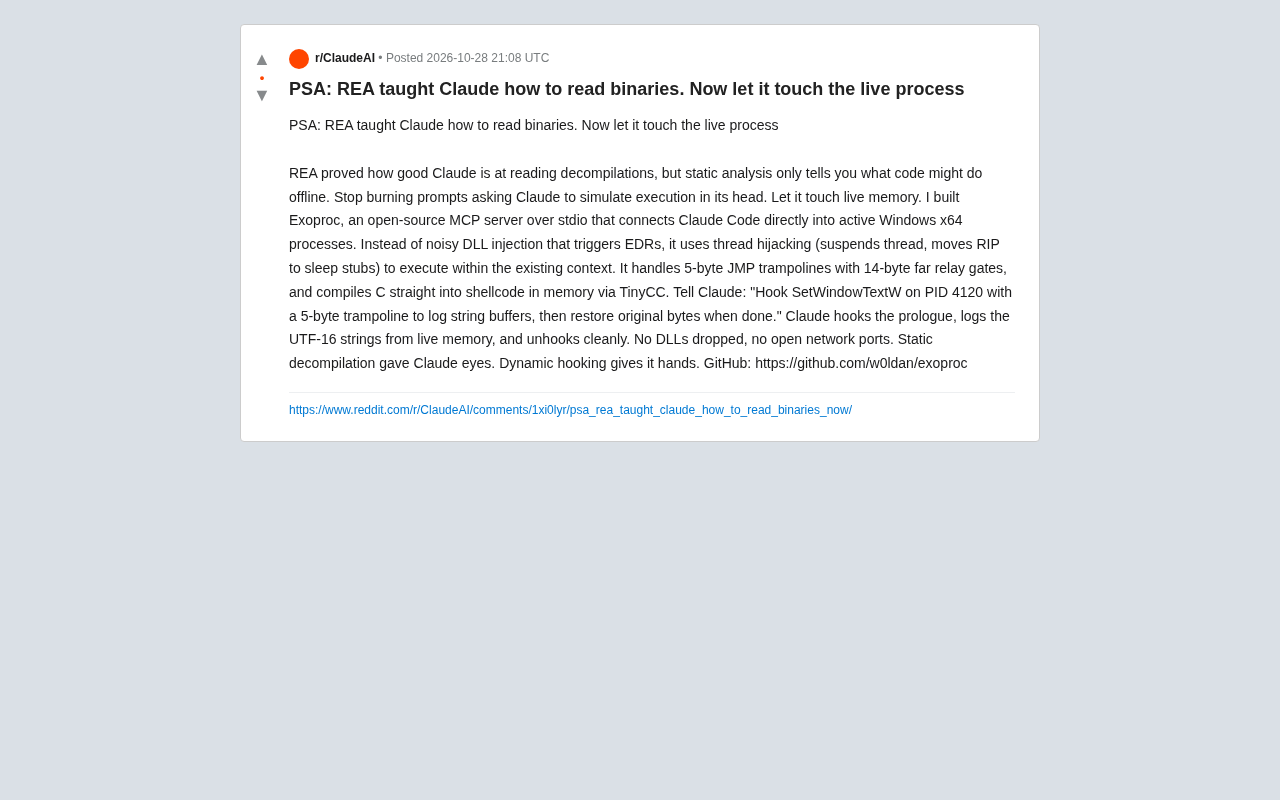
给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。