开源AI的真相:你拿到的只是蛋糕,不是配方
从"开放权重"到"真正开源"之间,隔着训练数据、食谱和一条按营收划定的商业界线。
本文系统拆解了AI领域"开放权重"与"真正开源"之间被刻意模糊的界线。开放权重只提供冻结的模型数字,不含训练数据和训练代码,用户能运行却无法复现;而OSI对开源AI的定义要求使用、研究、修改、分享四项自由,其中"研究"一项始终缺席。实验室送出模型的核心动机是商业逻辑——把模型压向免费,让利润滑向云算力层。2026年夏天,多家实验室开始在许可证中写入营收门槛,美中欧三方政府也各自用不同机制把开放边界划在"能力"这条线上。作者的最终判断是:开源AI并非死于今日,而是早在业界将"下载"等同于"开源"的那天就已名存实亡;真正正在消亡的是"前沿开放",而且是按商业利益而非哲学原则设定的时间表在消亡。
一个正在浏览器里打开的真实页面,托管着 DeepSeek 迄今发布的最大模型:865GB 的权重,采用 MIT 许可证,无需注册、无需排队、不用密钥。但把文件列表拉到底,你会发现少了些东西——没有训练数据,也没有训练脚本。只有一个 2KB 的配置文件和 64 个已经算好的数字分片。你能运行这个模型,却无法重建它。这是两份截然不同的礼物。
过去三年,我们一直把这种发布叫做"开源"。但许可证说的其实要窄得多。这篇文章要拆解的,正是"开放权重"(open weights)与真正的"开源"之间那道被刻意模糊的界线。
权重文件里到底有什么
一个模型本质上是一大堆数字,这些数字就是权重。训练是设定这些数字的过程,而训练需要三样东西:数据、从数据中学习的代码,以及庞大的算力。当实验室对外发布时,它可以给你这三者的任意组合。但绝大多数实验室只给你第三样的产物——被冻结的、已经算完的数字。
用蛋糕来打比方最贴切:开放权重就是那块蛋糕;而真正做对了的开源,是蛋糕加上食谱,再加上购物清单。两种方式你都能吃到蛋糕,但只有一种能让你自己再烤一个出来。
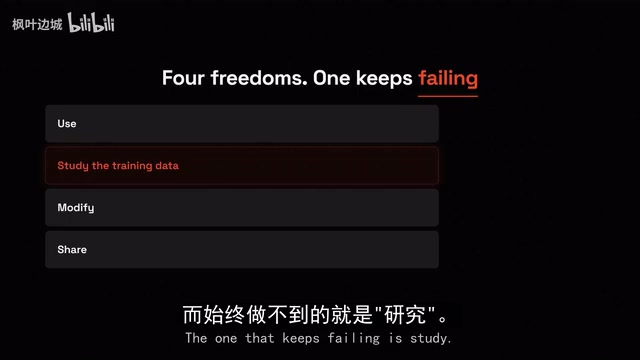
开源促进会(OSI)从 1998 年就在定义"开源"的含义。它现在专门发布了一个页面,标题毫不含糊:开放权重并不是你以为的那回事。OSI 对开源 AI 的定义要求四项自由——使用、研究、修改、分享。而反复失守的正是"研究"这一项:你无法真正研究一个连训练数据都没见过的系统。你可以戳它、测它,却无法把一个错误回答追溯到造成它的根源。如果某个基准测试的答案泄漏进了训练集,权重不会告诉你,论文也不会。
值得补充的是,"蒸馏"(distillation)这一技术正是让"送蛋糕"策略得以精确执行的工具。知识蒸馏的核心思路是:用一个大模型(教师模型)的输出概率分布来训练一个小模型(学生模型),使后者学会模仿前者的行为,而非从原始数据从头学习。这意味着小模型间接继承了大模型的"知识",但训练成本大幅降低。对实验室来说,这套机制允许它们对外释放一个功能相当不错的小版本,同时把真正的核心资产——大模型的权重、训练数据和训练代码——全部锁在内部。被下载的小模型越好用,外界对大模型的依赖反而越深,因为蒸馏本身就制造了一种结构性的不对称:你能用小模型完成大多数任务,但只要需要提升上限,就必须回到大模型的 API 接口。
G7 画出的四级阶梯
今年五月出现了一个安静但关键的时刻。G7 数字部长们不再纠结于"开源"这个词的定义,而是和 OSI 花了三个月,搭出了一把四级阶梯。
最底层是"权重可获取"(weights available),往上是"开放权重"(open weights),再往上是"开源 AI"(open source AI),最顶端是"开源加开放数据"——连训练集都给你。
你听说过的几乎所有模型,都停在第一级或第二级。最顶端那一级几乎是空的,而停在那里的模型(比如艾伦研究所的 Olmo)恰恰不是基准测试常谈论的那些。换句话说,"食谱"从一开始就不在桌上。
艾伦人工智能研究所(Allen Institute for AI,简称 AI2)发布的 OLMo 系列是目前学术界公认最接近"真正开源"定义的大型语言模型项目。它不仅公开模型权重,还完整发布了训练数据集(Dolma)、数据处理流程、训练代码以及训练过程中各阶段的检查点(checkpoints)。这使研究者第一次可以从数据清洗、采样比例到模型收敛曲线,对一个十亿参数量级的语言模型做端到端的复现和审计。然而 OLMo 的参数量和能力上限远低于商业实验室的旗舰模型,这本身就说明了一个结构性困境:完全开放所需的资源投入(存储、带宽、法律审查、数据授权谈判)对非营利机构来说已接近极限,而对于动辄耗资数亿美元的前沿训练来说,完整开源的成本与商业回报之间的张力几乎无解。
实验室为什么愿意送你蛋糕
既然如此,真正有趣的问题不是它们为什么开始收手,而是它们当初为什么愿意把蛋糕送出去。2026 年一次前沿模型的训练成本在 2 亿到 5 亿美元之间——这显然不是慈善预算,背后必须有一个能通过董事会审议的理由。
这个理由有 24 岁了。它来自 Joel Spolsky 在 2002 年写的一篇文章《战略信第五封》。他写道:聪明的公司会努力把自己的"互补品"商品化。互补品是人们买你产品时不得不一起买的东西,把它的价格压向零,你产品的需求就会上升。谷歌免费送出 Android,却留下了在上面运行的每一次搜索。这就是"剃须刀与刀片"的形状——免费送刀架,靠刀片赚钱。
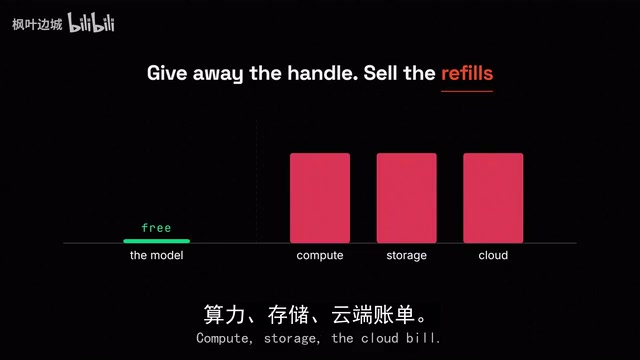
在 AI 里,模型就是刀架。如果一个能免费下载的模型已经足够好,就没人能为一个平庸模型收取溢价,钱就顺势滑向了下一层:算力、存储、云账单。
Meta 几乎是把这套逻辑写在了脸上。四月它发布了 Muse Spark,第一个前沿模型,也是第一个不放权重的模型。四个月后它发布 Muse Glimmer,300 亿参数,Apache 许可证,免费下载。模型卡上直接写着:这是"蒸馏"(distilled)而来的——意思是被训练来模仿更大模型的答案,所以免费的这个其实是付费模型的压缩版。你拿到小副本,他们留着原件。
阿里巴巴的同一笔交易出现在财报里:其 AI 云收入上季度增长 45%,其中 AI 产品线已经连续 12 个季度实现三位数增长。模型跑得最好的那朵云,正是它自己的。
追赶者的分发策略
还有第二个理由,与其说是战略,不如说是位置。中国的实验室起初并不慷慨,它们只是落后。当你落后时,把模型送出去是最便宜的分发方式:先省下销售团队,再省下自建服务能力,之后全世界还会免费帮你测试成果。北京把同样的思路写进了国家政策,公布了模型数量的目标。
但这里埋着一个陷阱:追赶时,开放是绝好的分发理由;一旦追上了,这个理由就不再成立。整个行业都在绕着一个问题打转——当免费模型和付费模型一样好的那一天,会发生什么?
许可证里被写进的数字
今年夏天,我们开始看到答案。
7 月 26 日,Moonshot 发布了 Kimi K3,2.8 万亿参数。许可证的前 15 行读起来和 MIT 一模一样,直到第二条款出现:如果你以模型服务为业,且任意连续 12 个月内营收超过 2000 万美元,就必须先和 Moonshot 签一份单独协议才能商用。
17 天后,阿里发布 3.8 Max,2.4 万亿参数,同样形状的许可证,门槛更高——5000 万美元,超过就得联系其商务团队。这份许可证还更进一步,定义了它要保护的品类:"AI 工作助手"指主要用于 AI 辅助编程或办公生产力的产品,然后点名两个例子,而这两个都属于阿里自己。许可证用产品名保护了它作者自己的产品——模型免费,直到你开始和写条款的人竞争的那一刻。
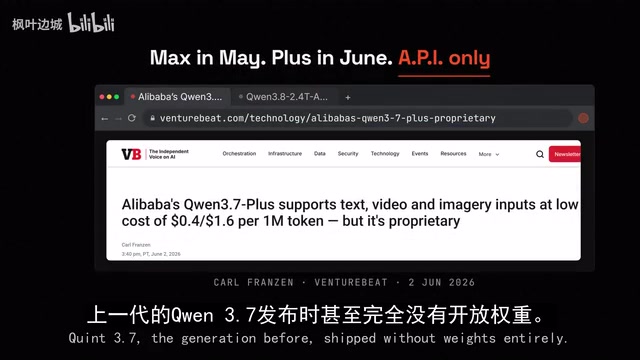
这也不是最早的信号。前一代 3.7 干脆完全不放权重:五月的 Max、六月的 Plus 都只提供 API——出自那个曾经在开源叙事上声量最大的实验室。
不过并非所有实验室都在转向。DeepSeek 八月用纯 MIT 许可证发布了 1.6 万亿参数模型,而且不是孤例。所以这道裂痕并非中美对立,而是横在"卖云的实验室"和"买声誉的实验室"之间。
这类附加商业条款的许可证在法律上通常被称为"源码可用许可证"(Source Available License)或"商业限制许可证"(Business Source License,BSL),与 OSI 认证的开源许可证(如 MIT、Apache 2.0)存在本质区别。OSI 认证要求许可证不得歧视任何人或使用场景,包括商业竞争对手。一旦许可证写入"营收超过 X 须另签协议"或"不得用于与发布方竞争的产品",它在 OSI 标准下就不再是开源许可证,尽管它的条文结构可能和 MIT 前十几行几乎相同。这种"伪装成 MIT 的商业许可证"在数据库和基础软件领域已有先例——HashiCorp(Terraform)和 Elastic 都走过同样的路径,从真正的开源许可证切换到附加商业限制的版本,并由此引发了社区分叉(fork)。AI 模型领域正在经历类似的许可证漂移,只是由于权重本身的不透明性,这道裂缝更难被普通用户察觉。
政府开始介入
更安静的一半,是决定权已经不只在实验室手里。
6 月 2 日,白宫签署了关于前沿 AI 的行政令,创设了一个叫"受管辖前沿模型"的类别,而判定标准是保密的。开发者可以在发布前最多 30 天向政府提供访问权限。这是自愿的,行政令白纸黑字这么写,也不设许可要求。但一旦一份保密清单和一个 30 天窗口存在了,发布一个模型头一次有了附带程序。
五周后,路透社报道中国商务部已与阿里、字节和 Z.AI 坐下来讨论限制其最强模型的海外访问,通义千问被点名在列。会上浮现的方案是三级制:基础工具简单备案、更强模型安全审查、最敏感的模型仅限国内使用。但什么都还没定,没有草案也没有日期,路透社明说这只是讨论而非命令。
有意思的是,这一切发生在官方政治口径指向相反方向的时候。七月,习近平在一次会议上表示中国必须鼓励开源与开放,而他的商务部同时在研究如何限制它。
欧洲则已经把这个思路写成了法律。欧盟 AI 法案给免费开源模型豁免部分文书义务,但在训练算力超过 10 的 25 次方浮点运算这道门槛之上收回豁免。翻译过来就是:小而开放没问题,大而开放需要谈一谈。
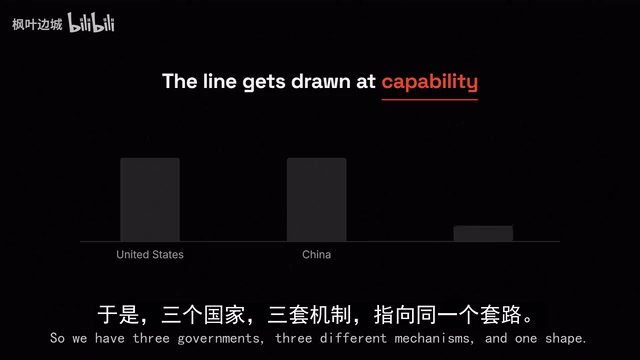
于是我们有了三个政府、三种不同机制、同一种形状——开放在某条线以下受欢迎,而这条线画在"能力"上。
欧盟 AI 法案中提到的 10²⁵ FLOP(浮点运算次数)这一算力门槛,是目前监管框架中少有的将"能力"量化为可执行标准的尝试。为便于理解其量级:GPT-4 的训练算力估算约在 2×10²⁴ 到 10²⁵ FLOP 之间,这意味着该门槛大致划定在当前前沿模型的训练规模附近。超过此门槛的模型被欧盟归类为"通用人工智能模型(GPAI)中的系统性风险模型",须履行对抗性测试、严重事故报告、网络安全措施等额外义务,开源豁免随之失效。这一设计的政策意图是:把监管成本集中在真正可能造成系统性影响的大模型上,而不是阻碍小型开放模型的生态发展。但批评者指出,FLOP 是一个可被绕过的代理指标——高效训练算法(如 DeepSeek 使用的混合专家架构)可以用更少算力达到同等能力,而算力门槛并不能捕捉这种情况。
开源 AI 真的要死了吗
面对恐慌,我要反过来说:原始供给给出的信号恰恰相反。2026 年发布的开放权重模型比以往任何一年都多。Thinking Machines 用 Apache 发布了 9750 亿参数模型,谷歌发布 Gemma 4,Meta 带回 Glimmer,中国实验室不止一次用 MIT 突破万亿参数。
再看人们真正下载的是什么——这才是最要紧的数字。上个月在模型平台上,Meta 300 亿参数的 Glimmer 被下载 66.5 万次,阿里 2.4 万亿的旗舰只有 5.2 万次。做一下硬件算术就明白这道鸿沟:那 865GB 的权重光是装下就需要大约七块数据中心显卡,还没开始生成一个 token。极少有团队具备这样的条件,我们大多数人只有一块 GPU 和一个 deadline。
所以我的判断是:开源 AI 不会在明年死去。它其实早在业界同意把"下载"叫做"开源"的那天就已经死了,而这个错误至今没有被纠正。现在正在死去的是"前沿开放",而且它是按营收门槛而非某种哲学设定的时间表在死。
对绝大多数在做东西的人来说,开放权重依然完胜,而且差距悬殊——你能真正跑起来的,是那个 300 亿参数的蒸馏版,授权免费,下载量是前沿模型的 12 倍。但它失守的那部分是真实存在的:如果你需要审计一个模型、复现一个结果、或证明里面到底放了什么,被承诺的东西根本没到货。
真正值得被恼火的不是某家公司,而是"开放"这个词。它替许可证做了三年许可证本不愿做的工作,赢得了大量它并未付费换取的信任。
最后留给你一个念头:现在每一份许可证里都写进了一个数字——2000 万、5000 万、10 的 25 次方。而每年都有人重新挑选这些数字。当它们变小的那一年,你的计划是什么?
相关推荐
Vercel智能体进化史:从翻车到翻倍的文件系统实战
Vercel首席软件官Andrew复盘数据科学智能体D0从多智能体架构翻车到文件系统Agent评分翻倍的全过程,揭示Claude Code式文件系统、技能沉淀的关键作用,并解析新开源Agent框架EVE的设计理念。
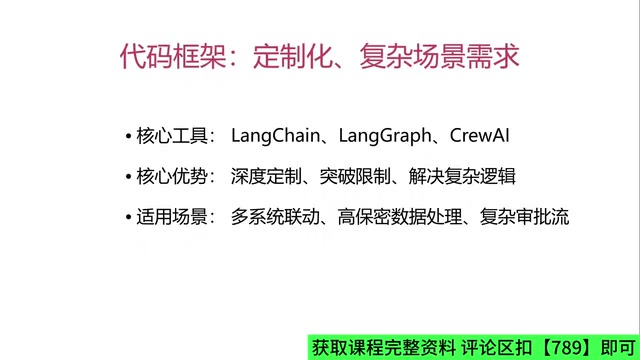
企业级AI Agent实战:低代码与硬核框架双线打法解析
解析企业级 AI Agent 实战课程框架:低代码平台(Coze/Dify/n8n)与代码框架(LangChain/LangGraph/CrewAI)双线并行,涵盖 MCP 协议、九大智能岗位与四大实战项目,助你构建能落地的企业数字员工。
OpenSpec实战:用SDD规范驱动开发驯服AI写代码
AI写代码前30分钟开挂后3小时救火?本文解析OpenSpec如何通过SDD规范驱动开发,让AI写的代码可追踪、可验证、可交付,并对比OpenSpec与SpecHit的选型场景。