开源版Claude Project:让你重掌AI上下文所有权
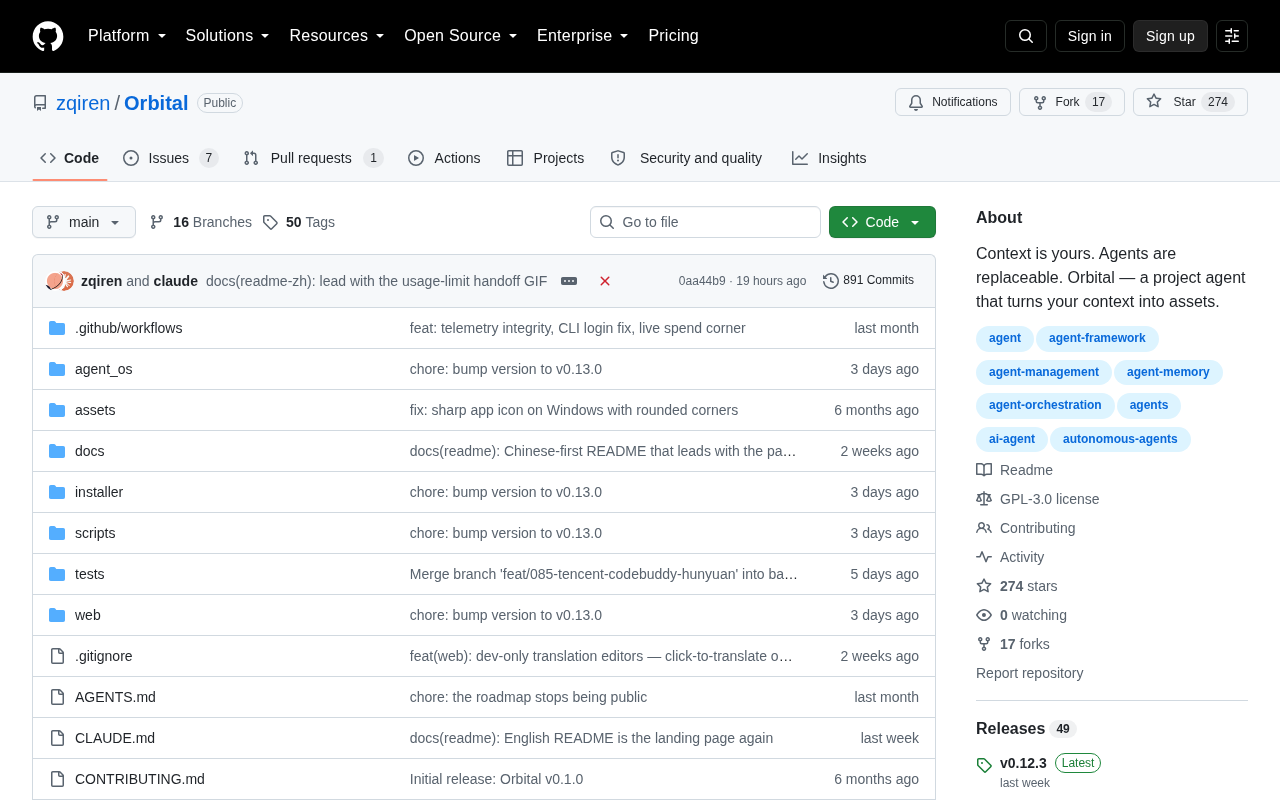
一个开源项目尝试替代Claude Projects,将AI对话上下文的控制权交还用户,但尚处早期阶段。
这篇文章介绍了一个出现在Hacker News上的开源项目,定位为Anthropic Claude Projects功能的替代方案,核心主张是"上下文所有权"——让用户将AI对话历史、知识库等数据存储在自己可控的环境中,而非托管于厂商云端。文章梳理了这一需求的合理性:数据自主、跨模型可移植性、透明可审计,三者共同指向对"厂商锁定"的规避。同时,作者也保持了冷静:该项目目前关注度有限、技术细节不明,开源自托管方案在易用性和稳定性上普遍与成熟商业产品存在差距,更适合有技术能力的开发者。文章最终将这一具体项目置于更广泛的趋势背景下——社区正在自下而上地将AI能力与数据从闭源平台解耦,上下文所有权可能是AI应用层未来演进的重要方向。
一个值得关注的开源尝试
在AI助手日益融入日常工作流的当下,上下文(Context)管理正成为决定使用体验的关键因素。近期在Hacker News上出现的一个项目,主打"Claude Project的开源替代方案",核心卖点是让用户重新掌握对上下文的所有权(context ownership)。
对于长期依赖Anthropic的Claude、OpenAI的ChatGPT等闭源产品的用户而言,这类项目触及了一个真实痛点:你与AI之间积累的对话历史、项目背景、知识库,究竟归谁所有?又存在何处?
什么是"上下文所有权"
Claude的Projects功能允许用户为特定任务创建独立的工作空间,上传文档、设定自定义指令,让AI在一个持续的知识背景下工作。这极大提升了处理复杂长期任务的效率。
但问题在于,这些上下文数据托管在服务商的服务器上。你无法自由导出、迁移,也难以完全掌控其存储与使用方式。所谓"上下文所有权",指的正是把这部分数据的控制权交还给用户——存在自己的环境里,可自由迁移、可跨模型复用、可完全掌握隐私边界。
为什么这件事重要
随着企业和开发者对数据合规、隐私保护的要求日益提高,将敏感的项目上下文交给第三方闭源平台,本身就是一种风险。开源方案理论上能提供三点价值:
- 数据自主:上下文存储在用户可控的位置,而非厂商云端
- 可移植性:不被单一模型或厂商锁定,可在不同大模型间切换
- 透明可审计:开源代码意味着数据流向公开可查
开源替代品的趋势
这个项目并非孤例。近一年来,围绕大模型应用层的开源工具呈爆发式增长——从开源的对话前端(如LibreChat、Open WebUI),到本地知识库检索(RAG)框架,再到各类Agent编排工具。它们共同指向一个方向:把AI能力的"外壳"和"数据"从闭源平台中解耦出来。
这类项目的兴起,反映出社区对"厂商锁定"(vendor lock-in)的警惕。当核心的推理能力可以通过API灵活调用,甚至用本地开源模型替代时,真正稀缺且有价值的资产,反而是长期积累的上下文与知识组织方式。
RAG(检索增强生成,Retrieval-Augmented Generation)是当前本地知识库工具的核心技术范式。它的工作原理是:将用户的文档、笔记等拆分成向量存入本地数据库,每次与AI对话时先检索出相关片段,再作为上下文注入提示词,从而让模型"读懂"私有知识库,而无需将全部数据上传云端或进行昂贵的模型微调。LlamaIndex、LangChain、AnythingLLM等开源框架都是此类方案的代表。理解RAG有助于判断一个声称"本地化上下文管理"的工具,其数据隔离到底做到了哪一层——是仅存储在本地磁盘,还是连向量化检索也在本地完成,两者的隐私保障力度差异显著。
冷静看待:早期项目的现实
补充一点,从目前公开信息看,该项目在Hacker News上的关注度仍然有限(5个点赞、暂无评论),属于早期阶段的探索。原始素材中并未提供技术架构、支持的模型、部署方式等具体细节。
因此,对这类项目应保持理性预期。开源方案通常在易用性、稳定性上与成熟商业产品存在差距,需要一定的技术门槛来部署和维护。它更适合有明确数据自主需求、且具备动手能力的开发者与团队。
值得思考的几个问题
如果你在评估此类工具,可以从以下角度考察:
- 它如何存储和组织上下文?是否真正做到本地化/自托管?
- 是否支持多种大模型后端,避免新的锁定?
- 社区活跃度与维护情况如何?
- 迁移现有Claude Project数据的成本有多高?
自托管(self-hosting)在实践中的成本往往被低估。除了初次部署的技术门槛,还涉及持续的运维负担:服务器资源、依赖库的版本维护、安全补丁更新,以及当上游大模型API发生变更时的适配工作。对于企业用户而言,还需评估自托管方案能否满足SOC 2、GDPR等合规审计要求——有时自建反而带来更高的合规举证责任。因此,"开源自托管"并不等于零成本的隐私保护,它本质上是将风险从厂商数据泄露,转移到了自身的运维与安全能力上,两者都需要审慎管理。
结语
"给你上下文所有权"的口号,抓住了当前AI应用生态的一个核心矛盾——能力的便捷性与数据的自主性之间的张力。开源版Claude Project这类项目,代表了社区自下而上重构AI工具链的努力。
尽管当前这个具体项目尚处早期、信息有限,但它所指向的方向——让用户真正拥有自己的AI上下文——很可能是未来AI应用层的重要演进路径之一。对关注数据主权的用户来说,持续留意这一赛道的成熟产品,是值得的。
相关推荐
Superpowers Skill 实测:一句话让 AI 编程助手跑完整个开发流程
Superpowers 是一套用于 Claude Code、Cursor 等 AI 编程助手的 14 个 Skill 集合,通过完整开发流程方法论让 AI 从需求审问到代码交付全程自主完成。本文详解其安装配置与图书管理系统实战演示。
WorkBuddy零基础实战:让AI从聊天工具变成办公员工
WorkBuddy零基础实战教程:一款支持飞书钉钉腾讯文档、装好即用的桌面AI智能体。本文解析它与Codex的核心差异、使用成本、常见认知误区及Excel、Word文件自动化办公场景,助你从AI提问者进化为AI管理者。
AI Agent零基础入门指南:从概念到项目实战的学习路径
AI Agent零基础入门到精通的系统学习路径:从环境配置、提示词工程、工具调用等基础概念,到ReAct、RAG、多智能体协同架构,再到私人助手、自动化办公等项目实战,帮你构建清晰的智能体开发知识框架。