开源大模型集体爆发:Kimi K3.1权重开放与电脑操作新突破

开源权重密集发布,小模型效率逼近前沿,闭源阵营以降价回应。
本周开源模型迎来密集发布:Moonshot 开放 3 万亿参数的 Kimi K3.1 Pro 权重,多项基准仅次于 Opus 5.5;Bipo AI 的 North Kua 系列以 90 亿到 3970 亿参数覆盖电脑操作,小模型与大模型分差仅约 10 分;Pruna AI 将 Minimax H3 改造成 8 步生成的 PH3 Image,体积小七倍;Pika H3 Flex 登顶开源文生视频榜,支持 4K 与多素材输入。此外还有 Sarvam Prism、MIT Hydrogen 1.0、Perplexity Embed V2、Clover 扩散模型、LFM 3、Unlimited OCR 等多点开花。闭源阵营中 GPT 6.1 Tera 价格降 50% 却更强,以性价比回应开源冲击。
本周开源模型圈迎来密集发布,从 Moonshot 的 Kimi K3.1 权重开放,到 Bipo AI 的 North Kua 电脑操作模型,再到 Pika H3 Flex 视频生成模型,几乎每个方向都有重量级选手登场。开源模型与闭源前沿的差距正在肉眼可见地缩小,而效率和成本的优化让本地部署变得前所未有的现实。
Kimi K3.1 Pro:开源权重中的前沿选手
Moonshot 兑现了承诺,正式在 Hugging Face 上放出 Kimi K3.1 Pro 的模型权重。这是一个 3 万亿参数规模的模型,共包含 96 个分片,每个分片约 17GB。官方定位很明确:它可能还不是 Anthropic 和 OpenAI 闭源实验室绝对前沿的水平,但差距已经只有半步之遥,而且完全开源开放权重。
想本地跑起来并不容易,粗略估算至少需要 1.2TB 显存。但社区拿到权重后很快会推出量化版本,届时消费级硬件也有机会尝鲜。基准测试的表现足以说明问题:在 Terminal Bench 上它击败了 Astra,仅次于当前公认最强的 Opus 5.5;在 Agent's Last Exam 上它拿到第一名,压过 Opus 和 Astra;在 GDPVal 这一考察真实世界知识工作的基准上,它的 ELO 分数排名第二,同样紧随 Opus 5.5。
混合专家架构(Mixture of Experts, MoE)是理解当前大模型参数规模的关键。它把模型拆成多个“专家”子网络,每次前向传播只激活其中一小部分,因此总参数量可以做得极大,而实际计算量远低于同等参数量的稠密模型。Kimi K3.1 Pro 的 3 万亿参数、North Kua 的 3970 亿总参数/170 亿激活参数,都是这一思路的体现。这也解释了为什么“总参数”与“激活参数”常被并列给出:前者决定存储与显存需求,后者决定推理速度与成本。
North Kua:把电脑操作做成开源能力
Bipo AI 推出的 North Kua 是一个中等规模的电脑操作模型,总参数 3970 亿,激活参数 170 亿,采用混合专家架构。这个家族还有两个更小的版本:North Kua Mini 总参数 350 亿,North Kua Nano 仅 90 亿。三者都附带自研的 harness,并且同样开源。
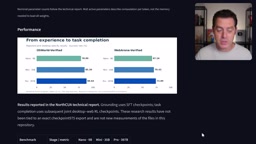
在 OS World Verified 这一权威电脑控制基准上,Nano 得分为 78.9,Mini 为 85,Pro 为 88。Nano 和 Pro 之间只差约 10 分,意味着 90 亿参数的模型在大多数硬件甚至手机上就能运行,却能提供接近前沿的操作能力。Web Arena Verified 上也呈现同样的趋势,小模型与大模型的分数非常接近。它的工作方式是一个观察、思考、行动的循环:截屏理解当前界面,规划下一步,执行操作,然后重复。
图像与视频模型的效率革命
Pruna AI 做了一件有意思的事:把 Minimax H3 这个视频模型改造成了图像生成与编辑模型 PH3 Image,并开源了权重。核心卖点是效率——生成或编辑图像只需 8 步而非 50 步,速度快了五倍,一张四百万像素图像耗时 2.6 秒而非 12.4 秒。模型体积比 H3 小七倍,高分辨率图像的下载和运行对 GPU 的要求都大幅降低。
它的强项集中在照片级真实感、纪实与编辑摄影、电影剧照以及带短引文的图形风格。官方给出的对比示例显示,在多个提示词下 PH3 Image 与 Minimax H3 的输出几乎难以区分,但步数少得多。手写体图像的表现尤其亮眼,甚至能还原咖啡渍这样的细节。
Pika Labs 的 Pika H3 Flex 则直接冲上了设计竞技场文生视频榜的开源权重第一名。它同样基于 Minimax H3 训练,但更快也更强,支持最高 4K 分辨率、可导出音频分轨、生成速度快于实时。它能用约 7 秒产出一段带配乐的 15 秒片段,定价从每秒一美分起步,60 秒视频的成本约 60 美分。多素材输入是它的另一个亮点:可以同时喂入多张图片、纹理、图案和一个音频文件,迅速生成带有丰富镜头运动的视频,并支持继续编辑。
文生视频与图像生成中的“步数”指扩散采样迭代次数。传统扩散模型需要几十步去噪才能得到清晰结果,步数越多质量越好但耗时越长。蒸馏、对抗训练或一致性模型等技术可以把采样压缩到个位数步数,PH3 Image 的 8 步生成正是这一路线的产物。步数减少不仅提速,还降低了对显存和算力的要求,使高分辨率生成在消费级 GPU 上变得可行。Pika H3 Flex 的“快于实时”同样依赖这类采样效率优化。
小模型与专用模型的多点开花
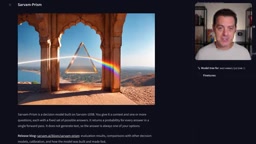
Sarvam 的 Prism 是一款开源权重的决策模型,建立在 Sarvam 105B 之上。你给它一段上下文和若干带有固定选项的问题,它在单次前向传播中返回每个答案的概率。它不生成文本,答案一定落在你给定的选项里,这与 Jeff 这类决策模型的思路一致。官方建议使用 B200 或 H200,权重需要 106GB 磁盘空间,但足够强劲的消费级硬件也有机会跑起来。
MIT 的 Hydrogen 1.0 则把 GLM 5.3 做了后训练,专攻科学发现。在前沿科学基准上它超越了包括 GPT-6 Astra Max 在内的所有对比模型,同时成本低于几乎所有对手,每个问题约 25 美分,而 Astra 为 88 美分。演示中它能自动编写代码,在三维空间模拟聚乙烯熔融的分子过程,并可旋转观察。
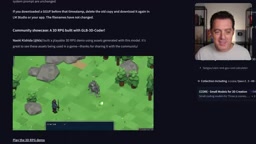
Perplexity 开源了 Embed V2 Context,一款视觉语言嵌入模型,提供 90 亿参数和 6 亿参数两个版本,专门用于在文本、图像和 PDF 等视觉文档上做检索。它足够小,可以在本地运行。社区微调的 Qwen 3.5 四 B 版本则专精 3D 编码,能生成独立的 Three.js、HTML、JavaScript 场景并支持 GLB 导出,对 Godot 等编辑器也很友好。
扩散语言模型与设备端新架构
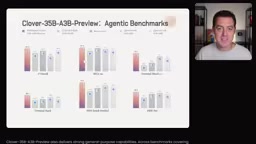
Diffuse Space AI 的 Clover 是一个 35 亿参数、3 亿激活参数的混合专家扩散文本模型。扩散架构带来的速度优势非常直观:一个从 CMU 匹兹堡校区导航到最近 Wendy's 的电脑操作任务,它用了 28 步、169 秒完成,而 Qwen 3.6 Flash 跑了 578 秒、达到 30 步上限仍未完成。
Liquid AI 的 LFM 3 走的是另一条路线。1.7B 版本在参数更少的情况下超过了上一代 2.6B 版本,四比特量化后体积约 1GB,几乎任何设备包括手机都能装下。它支持 256K 上下文窗口,具备视频、文本、空间感知和逐步推理能力,还能在单张 GPU 上微调。
百度研究院的 Unlimited OCR 针对图像文档读取,宣称没有页数限制、注意力成本不随长度增长,在单次处理中解析几乎无限长的文档并保持精度。实测中它在 5000 页文档上表现稳定,在多数 OCR 基准上成绩优异,权重已开放下载。
ServiceNow 的 Aprile Voice 27B 出人意料地采用了开源策略。这个语音 AI 模型可同时接收文本、图像和语音输入,经由语音编码器、token 嵌入和冻结的视觉接口汇入混合专家主干,最终不仅能理解任务,还能输出语音。
扩散语言模型(Diffusion Language Model)与传统自回归模型的工作方式不同。自回归模型逐 token 从左到右生成,每个 token 都要一次前向传播;扩散模型则从噪声出发,经过若干步去噪同时细化整段文本,步数固定且可并行。这正是 Clover 在电脑操作任务中用 28 步、169 秒完成而自回归模型跑满步数仍未完成的原因。代价是扩散模型在长文本连贯性和精确控制上仍有挑战,因此目前多用于对延迟敏感、输出结构相对固定的 agent 场景。
闭源阵营的性价比之战
本批发布中唯一的闭源模型是 OpenAI 的 GPT 6.1 Tera,但它的定价策略值得关注。相比上一代 GPT 5.6 Tera,标准 API 价格降低了 50%,能力反而更强。在 Agent's Last Exam 的帕累托曲线上,它几乎贴着零成本一侧;在最低思考预算下,它的智能水平相比同价位的 GPT 6 Luna 有明显提升。更关键的是,它在每 token 价格仅为 GPT 6 Astra 十分之一的情况下达到了相近表现,任务完成速度平均比 Astra 和 GPT 6.1 Sol 快三倍以上。对于需要跑大规模工作流的团队,这是一个值得认真评估的选项。
整体来看,这一周的主线非常清晰:开源权重正在从追赶者变成并跑者,效率优化让小模型在特定任务上逼近大模型,而闭源阵营则用价格战回应。对开发者和研究者而言,选择从未如此丰富。
帕累托曲线(Pareto curve)在模型评测中用来刻画“智能水平—成本”的权衡边界:曲线上的点表示在给定成本下无法再提升智能、或在给定智能下无法再降低成本的最优组合。GPT 6.1 Tera 在 Agent's Last Exam 的帕累托曲线上贴近零成本一侧,意味着它以极低价格提供了接近前沿的智能,属于帕累托改进。对团队选型而言,关注帕累托前沿比单看某一项 benchmark 分数更能反映实际性价比。
相关推荐

Harness 才是 Agent 的核心:工业级多 Agent 落地的三个关键
从 B 站实战演示出发,剖析 Harness 为何是 Agent 的核心:Master 与 Worker 双 Agent 架构、心智一致性约束、三遍自主迭代开发,以及工业级多 Agent 落地的可复用框架要点。

零成本用Claude Code:ModelScope免费API配置指南
B站UP主分享如何通过ModelScope魔搭社区免费API额度,配合VS Code和SystemService协议转换工具,零成本在Claude Code中调用DeepSeek等国产大模型写代码。含五步配置流程、模型选择技巧及三个常见坑点规避方法。

Pi Agent:极简开源编码智能体实战指南
Pi Agent 是对标 Codex、Claude Code 的极简开源编码智能体,GitHub Star 持续增长。本文梳理其崛起轨迹、极简设计思路与从原理配置到扩展开发的实战学习路径,帮助开发者快速上手。