开源DeepSeek技能包:用29个技能逼近Claude Opus

开源技能包 DeepSeek Stack 用规划验证循环,让廉价模型逼近昂贵模型八成水平。
文章介绍开发者开源的 DeepSeek Stack:29 个 MIT 协议技能,一条命令安装,通过规划、验证、评审等循环弥补 DeepSeek V4.1 Flash 在编程习惯上的缺陷,使其日常表现从 Opus 5.5 的六成提升到约八成。核心前提是两者价格差一个数量级以上,因此可以多跑尝试、多轮评审来换取质量。技能分核心、循环、构建、交付、理解五组,配合 thinking effort 开到 max 和 KleinPass 多模型评审效果最佳。作者也坦承该方案无法真正替代 Opus,在超大规模代码库调试与强创造性任务上仍有明显差距。
为什么便宜的模型需要"技能包"
据B站UP主搬运的视频内容,一位长期使用 DeepSeek广告 的开发者发现,DeepSeek V4.1 Flash 在日常编程任务中能做到约 Opus 5.5 八成的水平,速度快、价格低到不在一个量级。但刚上手时,这个比例只有六成左右,差距几乎从来不是模型不够聪明,而是"习惯"问题:不写计划就直接写代码,没跑测试就说修好了,同一个错误思路连试四次,长任务里渐渐忘了目标。
文件不能让模型变聪明,但能让它学会规划、检查工作、卡住时停下。这位开发者把近期流行的几个技能包拆开,丢掉绑定特定工具的部分,重写得更短更清晰,再加入自己与 DeepSeek 协作的循环,以及针对 DeepSeek 默认前端设计偏弱的改进,最终形成 DeepSeek Stack:29 个技能,MIT 协议开源,一条命令即可安装。
价格差决定了使用思路
原文给出的对比是:Opus 5.5 为每百万输入 token 4 美元、输出 20 美元;DeepSeek V4.1 Flash 在非高峰时段为每百万输入 15 美分、输出 60 美分,缓存输入约三十分之一美分每百万。高峰期价格翻倍,但输入仍比 Opus 便宜 13 倍以上,输出便宜 16 倍以上。
这个价差改变了 token 的使用哲学。用 Opus 时你会精打细算每一个 token;用 DeepSeek 时,多花 token 换质量几乎不增加成本——同一任务跑三次而不是一次、在新上下文里再做一次评审、把测试再跑一遍。技能包里很多设计正是建立在"多花一点便宜 token 换更接近昂贵模型的结果"这一前提上。
安装与运行环境
在项目目录中执行 npx skills add ai-coking/deepseek-stack 即可安装,工具会列出技能清单并询问你使用哪些 agent(Claude Code、Codex、Klein、OpenCode 等)。加 -g 参数可全局安装到所有项目,加 --skill 指定单个技能(例如 --skill ds-verify-loop)。所有技能以 ds 开头避免命名冲突,本质都是 skill.md 文件,理论上任何支持 skills 的 agent 都能用。
作者日常在 PandaCode(他的编程 agent 桌面应用)中运行这套组合,通过 DeepSeek 自有的 ds8 harness 直接接入:npm install -g @deepseek-ai/dsh,然后在设置里粘贴 API Key,新建任务时选择 V4.1 Flash,并把 thinking effort 调到 max。他特别强调这一步不能跳过——关闭 thinking 后测试分数下降近 30 分,影响超过包里任何单个技能。
KleinPass 是 Klein 团队每月 9.99 美元的订阅,提供包括 DeepSeek V4.1 Flash、Kimi K3.1 Pro、GLM 5.3 等在内的开放模型集合,额度宽松。在 PandaCode 中可以让 DeepSeek 主任务把部分工作分发给 Klein worker,这在评审类技能中尤其有用。
skills 机制:Anthropic 在 Claude Code 中引入的 Agent Skills,本质上是一个包含 SKILL.md 的目录,文件以 YAML frontmatter 声明技能名称、描述与触发条件,正文则是给模型的指令。模型在会话中根据描述判断何时加载对应技能,加载后指令进入上下文,相当于给 agent 临时加装一套行为准则。技能不含可执行代码,纯靠自然语言约束模型行为,因此跨 agent 可移植——只要宿主支持读取 SKILL.md 并注入上下文即可运行,这也是 deepseek-stack 能同时用于 Claude Code、Codex 等不同 agent 的原因。
thinking effort(推理强度):指模型在生成回答前进行内部推理的预算档位,通常分为 low/medium/high/max 等。档位越高,模型在给出最终输出前消耗的思维 token 越多,多步推理、自我检查的能力越强,但延迟和成本也随之上升。对 DeepSeek V4.1 Flash 这类廉价模型,把该档位开到最大能以极低成本换取接近昂贵模型的推理质量;反之关闭 thinking 相当于让模型跳过思考直接作答,在需要规划与验证的编程任务中退化明显。
五个技能组:核心、循环、构建、交付、理解
核心三件套
/ds mode 是常驻工作风格,如果只装一个技能就装它。它要求模型行动前用一行复述任务、改代码前先读代码、做最小改动、每次改完跑真实命令、不在同一条消息里展示输出就不说"完成"。其中一条规则很关键:同一个修复失败两次就必须停下,不再尝试同一思路的第三个版本。
/ds principles 是 21 条工程经验法则,每条配一个触发场景,如"修根因而非症状""先删代码再加代码"。它不常被直接调用,而是被其他技能引用。/ds help 则在你不知道该用哪个技能时,根据任务描述替你选一个并说明理由。
harness(智能体外壳):指包裹大模型的运行时框架,负责工具调用、文件读写、命令执行、上下文管理与多轮循环调度。模型本身只负责生成 token,真正让它能读代码、跑测试、开 PR 的是 harness。文中提到的 ds8 harness 即 DeepSeek 官方提供的这类运行时,PandaCode 通过它接入模型。harness 的能力直接决定技能包的上限——技能里的“跑真实命令”“截图对比”等要求,都需要 harness 提供相应的工具接口才能落地。
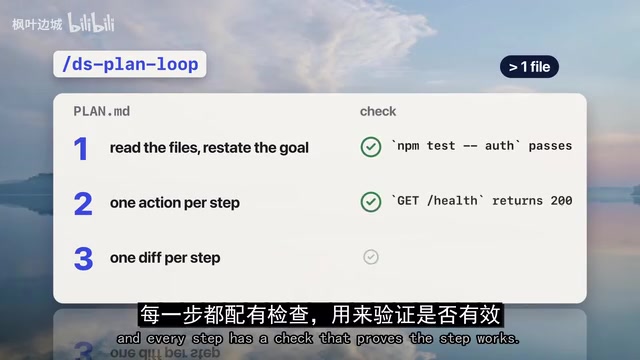
plan loop 与 verify loop 的分工:两者常被混淆。plan loop 作用于动手之前,产出的是带检查项的编号计划并经自查修订,解决“做对的事”;verify loop 作用于动手之后,以真实命令输出为准反复修复直至通过,解决“把事做对”。前者防止方向性遗漏,后者防止虚假完成声明。二者串联构成“先想清楚再改、改完必须证明”的闭环,是文中差距从六成提升到八成的关键结构。
循环组:差距缩小的关键
/ds plan loop 面向涉及多个文件的改动:先写编号计划,每步都带可验证的检查项,再在新一轮里自查计划是否漏步、假设是否冒险,修完计划才动手,一次一步。示例中模型计划给设置页加深色模式开关,自查时发现自己忘了处理首次加载时尚未读取保存值的情况——这正是 DeepSeek 直接动手时容易漏掉的问题。
/ds verify loop 是作者用得最多的技能:改代码、跑真实检查、读真实报错、找根因、修复、再跑,最多五轮后必须停下汇报,且必须粘贴最终通过的输出,不允许为了让测试通过而弱化或跳过测试。仅这一条就挡住了大部分"我修好了"的谎言。
/ds unstick 针对模型原地打转的情况:同一个错误在两次修复后复发时,停止编辑,写下所有失败修复共有的假设,直接验证这个假设。若假设成立,列出三种不同方案,选一种从干净状态重来。/ds context reset 应对长任务:模型维护 progress.md 记录目标、已完成项及证据、下一步和关键事实,上下文变长或开始重复时切换到读取该文件的新会话——对新上下文友好正是 DeepSeek 的强项。/ds ledger 在无人值守的长任务中为每个决策记一行日志(做了什么、为什么、证据),每步前重读避免偏离目标。
/ds review loop 把改动交给新上下文的评审者,作者修到双方一致,最多四轮。/ds jury 是加强版,从两三个不同模型收集评审并循环至一致——这正是 KleinPass 的用武之地:PandaCode 中 DeepSeek 做主导,把评审作为只读任务分发给跑在 Kimi K3.1 Pro 和 GLM 5.3 上的 Klein worker。不同模型犯不同错误,也就能抓到不同问题,而在 10 美元套餐加廉价 token 的成本下,每个 PR 都跑一遍也不心疼。
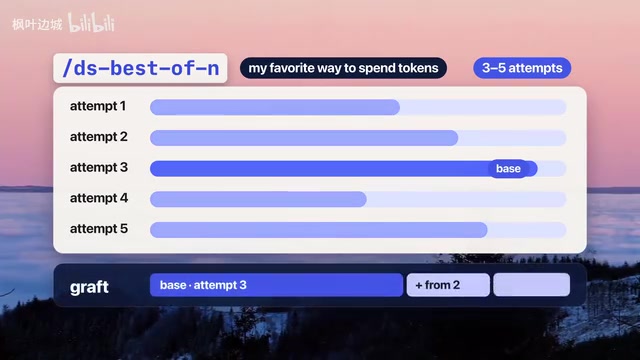
/ds best of n 是作者最喜欢的"花便宜 token"方式:并行跑三到五次同一任务,选最强的一次为基底,再吸收其他次的最佳片段。Opus 跑五次代价很大,DeepSeek 跑五次仍比一次 Opus 便宜。/ds swarm 面向宽任务,比如审计 API 的每条路由、检查应用的每个页面,再合并成带证据的统一报告。
构建组与设计技能
/ds sharpen 处理模糊需求:重述你真正想要的,把任务做深而不是做大。/ds blueprint 先设计类型、函数签名、模块布局,确认形状后再填代码。/ds tdd 针对 bug:先写一个以正确理由失败的测试,再做最小改动使其通过。/ds radius 检查改动对自身 diff 之外的影响面——其他调用方、配置、持久化数据、其他服务,并用真实运行证明关键安全事实,而不是写一段话声称安全。
设计技能被认为是包里最强的部分之一。/ds design 要求模型写代码前先给出简短设计方向:目的、受众、调性、希望被记住的那一点;然后定字体、颜色、间距,并用"我会不会对任何类似提示都做出同样的方案"来审视计划,还维护一份"俗套清单"(紫蓝渐变、Inter 当标题字体、用 emoji 当图标、居中 hero 加三张相同卡片)。它会在桌面与移动尺寸截图并修正所见问题。示例中,给小咖啡烘焙商做落地页时,它给出暖色纸张纹理、复古展示字体、围绕产品行的布局,远胜 DeepSeek 默认输出。/ds design audit 则针对已有 UI:两种尺寸截图,就层级、字体、颜色、间距、状态、可访问性、文案逐项打分并附证据,然后修前三到五个问题再截图对比。
交付组
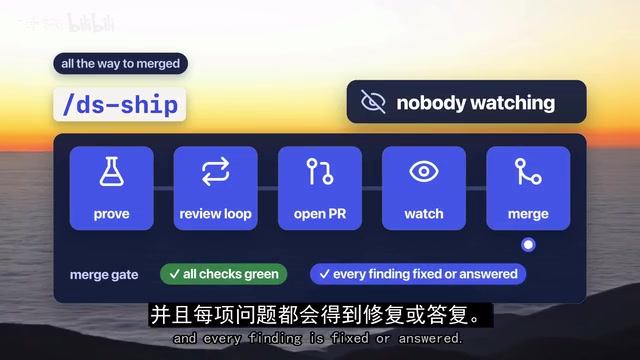
这组依赖 GitHub CLI。/ds pr 以问题开头撰写简短 PR 并附两侧截图;/ds watchpr 盯着 CI 与评审机器人,修真实问题并推送,直到就绪、合并或被阻塞;/ds ship 走完从改动到无人值守合并的全流程,只在所有检查通过且每个发现都已修复或答复后才合并,从不使用管理员绕过,遇到不可撤销操作会先停下来问你;/ds ready 做同样的事但停在 PR 就绪处,由你手动完成最后合并,这是作者最常用的一个。
/ds adopt 接手他人的 PR、分支或 agent 线程,完成原目标同时保留原作者署名;/ds revive 更新旧 PR,但先检查想法在当前代码下是否仍成立——有时正确答案就是关掉它;/ds pr comments 确保 agent 代发的评论明确标注来自 agent,且不泄露不该泄露的内容。
理解组
/ds explain 用平实语言解释一段代码如何工作、为何这样构建;/ds catch up 总结你离开期间的变化和等待你决定的每个决策,适合一长串 worker 跑完之后;/ds lessons 找出 agent 在你仓库里反复犯的错误,把每个错误固化成类型、lint 规则或测试,让它不能再犯;/ds unslop 清除文档、PR 描述和代码注释里的 AI 腔,比如填充短语和虚假热情。
日常组合方式与需要坦白的局限
作者的日常用法很直接:ds mode 常开;普通任务从 ds plan loop 开始,由 ds verify loop 推进,卡住时依据 mode 的规则切换到 ds unstick;合并前跑 ds review loop,重要改动跑 ds jury 并配 KleinPass worker,最后 ds ready 开 PR 并跑绿。UI 工作用 ds design 替代 plan loop;大任务用 ds best of n 或 ds swarm,因为 token 足够便宜。
需要如实说明的是,这套东西不能把 DeepSeek V4.1 Flash 变成 Opus 5.5。面对超大代码库的难缠 bug 调试、需要大量创造性思考的问题,Opus 仍然胜出,有时胜出很多。八成这个数字是作者基于自己日常工作的体感,不是基准测试,需谨慎看待。技能会让每个任务消耗更多 token,因为要多检查、多评审、有时多尝试,但在 DeepSeek 的价格下这点额外成本很小——宁可为一个真的会跑测试的模型付费,也不要一个声称跑过测试的模型。此外,使用 DeepSeek 意味着代码会发送到其服务器,公司私有项目需先确认是否允许;跑大任务尽量选非高峰时段,价格减半。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。