开源鲁棒性测试框架SIRFEX:失败驱动的PPO重训为何拖累正常性能?
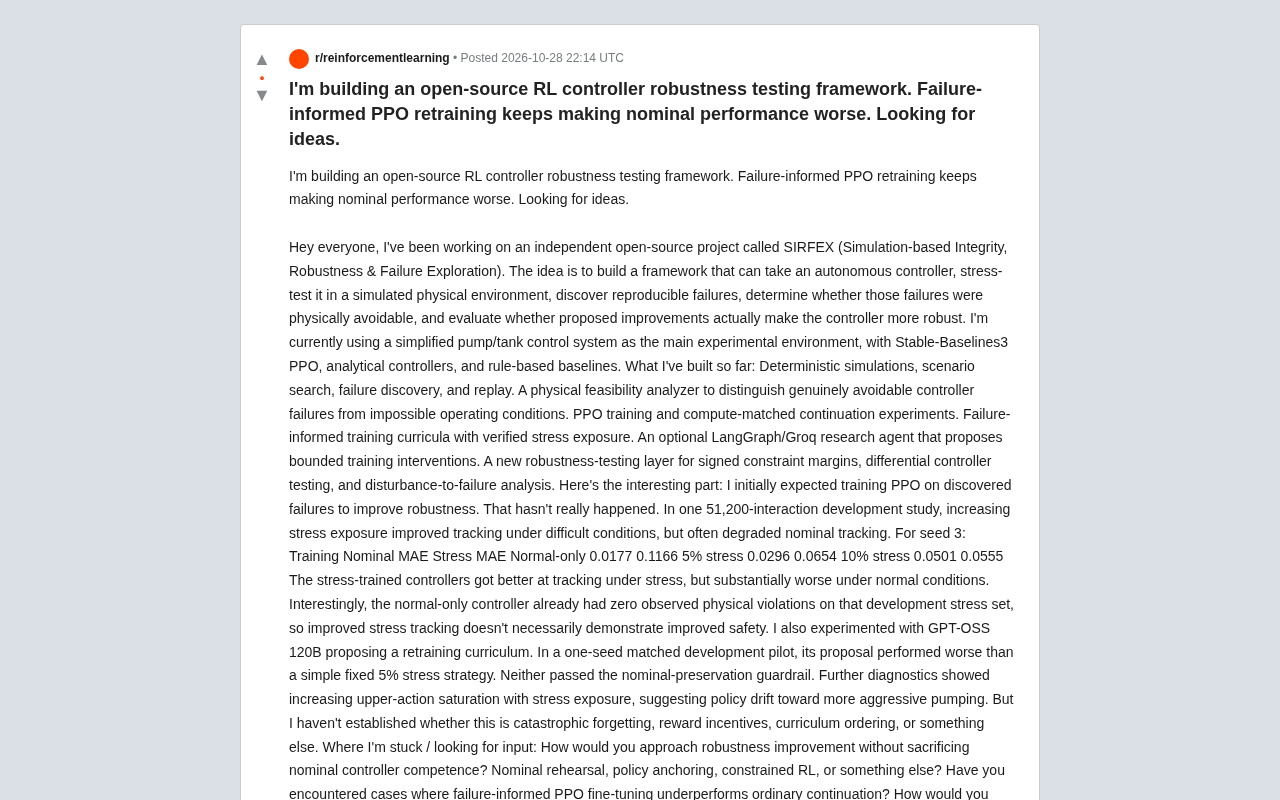
开源框架SIRFEX发现失败驱动PPO重训改善压力性能却恶化标称性能,揭示鲁棒性训练权衡。
SIRFEX是一个开源仿真测试框架,用于对自主控制器进行压力测试、发现可复现失败并评估改进方案。开发者用PPO在泵/罐控制任务上实验,发现增加压力场景训练比例能改善困难条件下的跟踪性能,却显著恶化正常工况的标称性能,形成明显权衡。仅正常数据训练的控制器在开发压力集上已实现零物理违规,说明压力跟踪改善不等于安全性提升。GPT-OSS 120B提出的重训练课程在试点中不如固定5%压力策略,且两者均未通过标称性能护栏。开发者正转向定量鲁棒性裕度和差分测试,以在违规频率饱和后继续衡量鲁棒性。该负结果为RL鲁棒性研究提供了可复现的参考。
开源鲁棒性测试框架SIRFEX:失败驱动的PPO重训为何拖累正常性能?
一位开发者正在构建名为 SIRFEX(Simulation-based Integrity, Robustness & Failure Exploration)的开源框架,旨在对自主控制器进行仿真压力测试、发现可复现的失败,并评估改进方案是否真正提升了鲁棒性。然而,他在 Reddit 上分享的初步实验揭示了一个反直觉的现象:用发现的失败场景去微调 PPO 策略,反而让控制器在正常工况下的表现变差了。 这位开发者选择公开负结果,并寻求社区建议,为 RL 控制领域提供了一个值得深挖的案例。
SIRFEX 框架:从失败发现到鲁棒性验证
SIRFEX 的定位是一个完整的仿真测试闭环。根据原帖描述,它已经实现了确定性仿真、场景搜索、失败发现与回放,以及一个物理可行性分析器——用于区分“控制器本可避免的失败”和“物理上不可能的操作条件”。在训练侧,框架支持 PPO 训练、算力匹配的延续实验、以及带验证压力暴露的失败驱动课程。此外,还有一个可选的 LangGraph/Groq 研究智能体,用于提出有界的训练干预建议。
最新加入的鲁棒性测试层包括带符号约束裕度、差分控制器测试和扰动到失败的分析。实验环境是一个简化的泵/罐控制系统,对比对象包括 Stable-Baselines3 的 PPO、解析控制器和基于规则的基线。整个项目在本地 CPU 上运行,强调可复现性和科学诚实。
PPO(Proximal Policy Optimization) 是强化学习中一种常用的策略梯度算法,通过限制每次策略更新的幅度来保证训练稳定性。它使用裁剪的替代目标函数,避免新策略偏离旧策略过远,从而在样本效率和训练稳定性之间取得平衡。PPO 广泛应用于连续控制任务,如机器人控制和自动驾驶。在 SIRFEX 中,PPO 被用于训练泵/罐控制器的策略,而失败驱动的微调则是在已有 PPO 策略基础上,用特定场景数据继续训练。理解 PPO 的裁剪机制有助于分析为何压力样本会扭曲优化目标:当压力样本比例增加时,正常样本的梯度贡献被稀释,策略可能过度适应压力分布,导致标称性能下降。
负结果:压力暴露改善鲁棒性,却牺牲标称性能
开发者最核心的发现来自一个 51,200 交互的开发研究。他原本预期,在发现的失败场景上训练 PPO 会提升鲁棒性。但结果并非如此:增加压力暴露确实改善了困难条件下的跟踪性能,却经常导致正常条件下的跟踪退化。
以 seed 3 为例:
| 训练策略 | 标称 MAE | 压力 MAE |
|---|---|---|
| 仅正常数据 | 0.0177 | 0.1166 |
| 5% 压力 | 0.0296 | 0.0654 |
| 10% 压力 | 0.0501 | 0.0555 |
数据清晰显示了一种权衡:压力训练让控制器在压力场景下的 MAE 从 0.1166 降至 0.0555,但正常场景的 MAE 从 0.0177 恶化到 0.0501。更关键的是,仅正常数据训练的控制器在该开发压力集上已经实现了零物理违规,这意味着“压力跟踪改善”并不等同于“安全性提升”。
开发者还尝试了用 GPT-OSS 120B 提出重训练课程。在一个 seed 的匹配开发试点中,该方案的表现还不如简单的固定 5% 压力策略,两者都未通过标称性能保持的护栏。进一步诊断显示,随着压力暴露增加,上部动作饱和现象加剧,暗示策略可能漂移向更激进的泵送行为。但开发者尚未确定这是灾难性遗忘、奖励激励、课程顺序还是其他原因。
MAE(Mean Absolute Error,平均绝对误差) 是衡量跟踪性能的常用指标,计算预测值与真实值之间绝对误差的平均值。在控制系统中,MAE 越小表示控制器输出越接近设定点。文中标称 MAE 指正常工况下的平均绝对误差,压力 MAE 指在压力场景(如扰动、极端条件)下的平均绝对误差。MAE 对误差的线性惩罚使其对异常值不如均方误差敏感,适合评估控制系统的平稳性。表中数据表明,随着压力训练比例增加,标称 MAE 从 0.0177 升至 0.0501,意味着正常工况下的跟踪精度显著下降;而压力 MAE 从 0.1166 降至 0.0555,显示压力场景性能改善。这种权衡是鲁棒性研究中典型的标称-鲁棒性能折衷。
社区可能关注的几个方向
开发者提出了三个具体问题,这些问题也指向了 RL 鲁棒性研究中常见的难点。
如何在提升鲁棒性的同时不牺牲标称性能? 他列举了标称排练、策略锚定、约束 RL 等候选方案。从负结果看,单纯增加压力样本比例会扭曲策略的优化目标——正常工况的梯度信号被稀释,策略可能过度适应压力分布。标称排练(在每轮训练中混入固定比例的正常数据)和策略锚定(用 KL 散度约束新策略偏离旧策略)是直观的缓解手段,但需要实验验证。
当约束违规频率已经饱和为零,如何衡量有意义的鲁棒性? 这是一个度量设计问题。零违规意味着当前测试集已无法区分控制器优劣。开发者正在转向定量鲁棒性裕度和差分测试,这是合理的方向——带符号的约束裕度可以反映控制器距离违规边界有多远,差分测试则能对比不同控制器在相同扰动下的行为差异。
是否有现有基准或测试方法可对比? 在控制领域,安全强化学习的基准(如 Safety Gym)和鲁棒性测试方法(如基于对抗扰动的测试)可能提供参照。但 SIRFEX 的物理可行性分析层有其独特性,如何与通用基准对齐仍需探索。
约束强化学习(Constrained RL) 是一类在优化累积奖励的同时满足安全约束的强化学习方法。与标准 RL 不同,约束 RL 将约束违反(如物理违规、安全阈值)作为优化目标的一部分,通常采用拉格朗日方法或约束策略优化来平衡奖励与约束。在 SIRFEX 的语境下,约束 RL 可用于确保控制器在提升鲁棒性时不牺牲标称性能——例如将标称 MAE 的退化作为约束,限制策略更新方向。开发者列举的“策略锚定”本质上是约束 RL 的一种简化形式,通过 KL 散度约束新策略偏离旧策略的程度。约束 RL 的挑战在于约束满足与奖励最大化之间的权衡,以及约束阈值的合理设定。
失败驱动微调为何可能不如普通延续训练
原帖中开发者提到,失败驱动的 PPO 微调在试点中不如普通延续训练。这一现象在 RL 实践中并不罕见,可能的原因包括:
- 分布偏移:失败场景通常集中在状态空间的边缘区域,用这些样本微调会让策略过度优化边缘表现,而忽略中心区域的精细控制。
- 奖励重塑的副作用:如果失败驱动课程改变了奖励函数或样本权重,策略可能学会“投机”行为,例如更激进的泵送以快速纠正偏差,但代价是正常工况下的平稳性。
- 课程顺序敏感性:压力暴露的引入时机和比例可能影响最终策略。开发者使用的固定 5% 和 10% 压力比例可能不是最优调度。
开发者观察到上部动作饱和加剧,这与“策略漂移向激进泵送”的假设一致。在泵/罐系统中,更激进的泵送可能帮助快速跟踪压力设定点,但会引入更大的超调和振荡,从而恶化标称 MAE。
灾难性遗忘(Catastrophic Forgetting) 是神经网络在顺序学习多个任务时常见的现象:学习新任务会导致对旧任务性能的显著下降。在强化学习中,当策略在失败场景上微调时,网络参数可能大幅调整以适配新分布,从而遗忘在正常工况下学到的精细控制策略。文中开发者观察到标称性能退化,灾难性遗忘是候选解释之一。缓解方法包括经验回放(混合旧数据)、弹性权重巩固(限制重要参数更新)和策略锚定(约束策略偏离)。然而,灾难性遗忘与分布偏移、奖励重塑等因素可能共同作用,需通过消融实验区分。
对开源 RL 测试框架的启示
SIRFEX 的负结果本身具有价值。它提醒我们,失败驱动的训练不是鲁棒性的万能药。在约束违规已经为零的情况下,继续用失败场景微调可能只是在优化一个已经饱和的指标,而代价是牺牲正常性能。开发者转向定量裕度和差分测试,是更可能产生区分度的方向。
对于构建类似测试框架的团队,这个案例提供了几点参考:
- 标称性能护栏应作为硬约束:任何鲁棒性改进方案都应在标称性能不显著退化的前提下评估。
- 失败场景的采样需要与正常场景平衡:单纯增加压力比例可能适得其反,需要更智能的课程调度或约束机制。
- 鲁棒性度量应超越违规频率:当违规频率饱和时,裕度、恢复时间、扰动灵敏度等指标更能反映真实鲁棒性。
- 负结果值得公开:开发者将负结果和实验细节公开,为社区提供了可复现的参考,这比只报告成功案例更有助于领域进步。
SIRFEX 仍在早期阶段,代码在 GitHub 上开源。开发者明确表示欢迎批评、相关论文、实现建议和贡献。对于关注 RL 控制、安全强化学习和仿真测试的研究者,这是一个值得跟踪的项目。
相关推荐
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。
Claude Code国内实战教程:从安装到代码实战
B站直播课详解Claude Code国内实战:从安装集成、内置命令、MCP配置到SQL技能与DRMD文件,并给出绕开账户注册以避免封号的稳定使用方案,帮助开发者少走弯路。
Coze实战合集:多Agent协作与自由定制指南
B站教程解读Coze多Agent协作:如何像搭团队一样创建AI专家、利用行业模板快速上手、三端互通随时操作,并分析积分消耗与一站式项目的实际取舍。