开源社区封杀AI项目?R/open source新规引争议
R/open source社区同时禁止单人项目和LLM项目,引发开源治理边界争议。
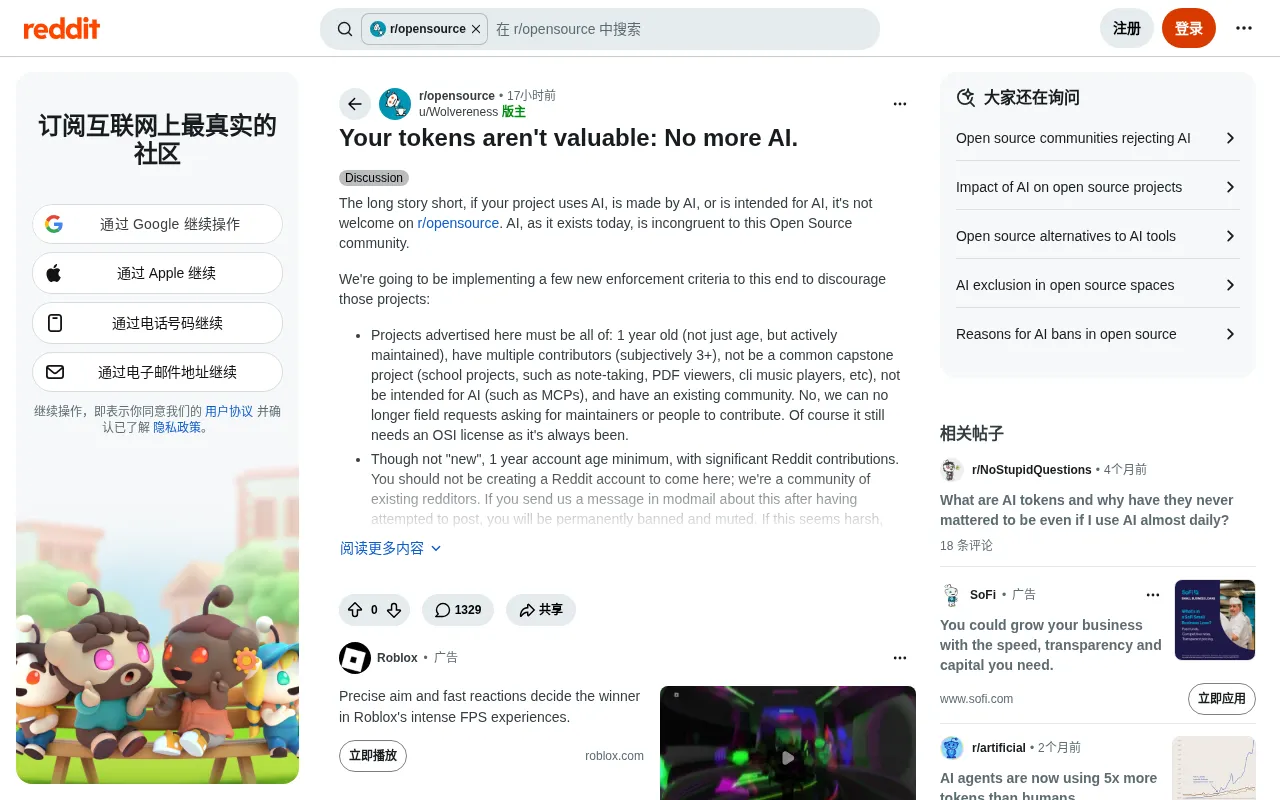
R/open source社区出台新规,同时禁止单人维护的项目和任何使用大语言模型辅助开发的项目,在Hacker News引发讨论。两条禁令指向不同焦虑:禁单人项目是为降低孤儿项目风险,禁LLM项目则担忧训练数据许可证污染、代码审查负担加重以及贡献者透明度下降。文章指出,一刀切规则无法区分LLM辅助程度,可能误伤大量现代开发流程,并把优质贡献者推向规则更宽松的平台,与提升项目质量的初衷相悖。争议的真正价值在于促使开源社区思考如何为AI辅助开发建立可操作的治理框架,而非简单禁止或放行。
开源社区封杀AI项目?R/open source新规引争议
一个名为 r/open source 的社区近日抛出重磅规则:禁止所有单人项目,以及任何使用大语言模型(LLM)的项目。消息在 Hacker News 上获得 48 分、26 条评论,讨论热度不算爆炸,但话题本身足够尖锐——它触及了开源社区在 AI 时代最敏感的神经:当代码可以由模型生成,"开源"的边界到底在哪里?
新规到底禁了什么
根据帖子标题透露的信息,这条规则包含两个相互独立的禁令。第一,所有 solo 项目(即单人维护的项目)被排除在社区之外;第二,任何使用 LLM 辅助开发的项目同样不被接受。
两条禁令叠加,受影响的开发者群体相当庞大。大量开源项目起步阶段都是单人维护,而 LLM 辅助编码在当下几乎已成为默认工作流的一部分。这意味着该社区实际上把当前开源生态中增长最快的两类项目排除在外。
帖子没有公开更详细的执行细则,比如如何检测项目是否使用了 LLM、单人项目在引入第二位维护者后能否重新申请、历史项目是否被追溯清理。这些空白恰恰是评论区争议的焦点。
两条禁令背后的逻辑冲突
把两条禁令放在一起看,会发现它们指向的焦虑并不相同。
禁单人项目,通常出于两个考虑:一是降低维护者失联导致的"孤儿项目"风险,二是社区希望项目具备一定的协作和代码审查能力。这更像传统开源治理思路的延伸。
禁 LLM 项目则是另一回事。它针对的是代码来源的透明度——如果一段代码由模型生成,贡献者是否真正理解它?训练数据中的许可证问题是否会传导到项目里?这类担忧在开源圈已有不少讨论,但从担忧升级为明文禁令的社区并不多。
问题在于,两条规则同时执行会产生荒诞的结果:一个由两人协作、但其中一人用 LLM 写了部分代码的项目被拒;而一个纯手写、却只有单个维护者的项目同样被拒。规则的颗粒度,与真实项目的复杂形态之间存在明显错位。
孤儿项目与 bus factor
“孤儿项目”风险在开源治理中常以 bus factor(巴士系数)衡量:即多少核心维护者同时离开,项目就会陷入停滞。单人项目 bus factor 为 1,维护者一旦失联,issue 无人响应、安全漏洞无人修补,下游依赖者会直接受损。许多社区因此要求项目至少有两名活跃维护者,或建立明确的继任机制。不过 bus factor 只是治理指标之一,把它直接等同于“禁止单人项目”,等于用维护者数量代替对项目健康度的综合判断,这也是该规则引发争议的原因之一。
社区为何对 LLM 如此警惕
从 Hacker News 的讨论语境看,反对 LLM 进入开源项目的声音集中在几个方向。
最直接的是版权与许可证污染。LLM 的训练语料中混有大量不同许可证的代码,生成结果可能在不经意间复制了 GPL 或其他 copyleft 协议的片段。项目一旦引入这类代码,整个许可证体系可能被牵连,这对强调合规的开源社区是实质性风险。
其次是审查负担。模型生成的代码往往"看起来对",但隐藏的逻辑错误需要维护者逐行核对。当项目规模扩大,审查 LLM 代码的成本可能超过自己重写。有评论者认为,这会让"贡献"变成一种负担转移。
还有一层是对社区文化的影响。开源长期依赖人与人之间的信任和声誉积累,LLM 的介入让"谁写了这段代码"变得模糊,评审者难以判断贡献者的真实能力。这种不透明感,是许多老牌维护者抵触的核心原因。
copyleft 与许可证传染性
文中提到的 GPL 属于 copyleft(著佐权)许可证,其核心机制是“传染性”:一旦项目包含 GPL 代码,整个衍生作品通常也须以 GPL 发布。这与 MIT、Apache 2.0 等宽松许可证形成鲜明对比,后者允许闭源商用。LLM 训练语料中混杂各类许可证代码,模型生成片段若与某段 GPL 代码高度相似,就可能把 copyleft 义务“传染”给引入该片段的项目。这正是开源合规社区对 AI 生成代码格外警惕的根源:风险不在代码本身能否运行,而在许可证链条是否被无意中污染。
一刀切规则的现实代价
站在社区治理角度,明文禁令的好处是可执行、无歧义。但代价同样明显。
最直接的是误伤。LLM 辅助的范围极广,从补全一行函数签名到生成整个模块都算"使用 LLM",规则若不区分程度,几乎会把所有现代开发流程挡在门外。
更深层的问题是信号效应。当主流开源社区开始明确排斥 AI 辅助项目,优质贡献者可能流向规则更宽松的平台,被排除的社区反而面临项目质量下降。这与规则想要提升项目质量的初衷相悖。
另一种可能的解读是,这条规则本身就是一种立场表达——在 AI 生成内容泛滥的背景下,社区选择用最激烈的方式划清界限,哪怕牺牲一部分增长。这种做法在小型、价值观驱动的社区中并非没有先例。
AI 生成代码的归属与披露实践
目前业界对 AI 辅助代码的治理尚未形成统一标准,但已出现若干可参照的做法。例如部分项目要求在 PR 模板中声明是否使用 AI 工具及使用范围;Linux 内核社区曾就 AI 生成补丁的 Signed-off-by 标签展开讨论,强调提交者仍需对代码质量和许可证合规负责;GitHub Copilot 等工具也提供代码相似度检测与过滤器。这些实践的共同思路是“披露 + 责任归属”,而非一律禁止,与文中提出的分级治理方向一致,也为社区制定细则提供了现实素材。
开源治理需要更细的刻度
这起争议真正的价值,不在于评判某条规则的对错,而在于它把一个迟早要面对的问题摆上了台面:开源社区如何为 AI 辅助开发建立可操作的治理框架。
可行的方向包括:要求贡献者声明 AI 使用范围而非一律禁止;对 AI 生成比例较高的提交施加更严格的审查流程;在许可证层面明确 AI 生成代码的归属规则。这些方案都比一刀切更复杂,但更接近真实项目的运作方式。
r/open source 的新规或许只是一个开始。随着 LLM 进一步渗透开发流程,类似的规则博弈会在更多社区重复出现。对开发者而言,值得关注的不是某条禁令本身,而是自己所在社区将如何定义"可接受的贡献"。
相关推荐

零基础用Claude Code搭建AI Agent:从工作区到云端自治
无需编程,用Claude Code桌面应用四步搭建AI Agent:从工作区配置、Agent Designer生成第一个智能体,到Skill固定流程、Memory自我进化,最终部署云端定时自治运行。

无需Python基础:Cursor AI编程如何重塑自动化测试与测试开发
测试工程师不学Python也能做自动化测试?本文梳理Cursor等AI编程工具如何赋能功能测试、自动化脚本、测试平台开发与性能调优,并对比国内外主流工具的成本与访问限制,给出测试人员的能力转型建议。

近5000人中招!AI编程插件被植入后门,官方紧急下架
Claude Code的VS Code扩展2.1.313版本被恶意篡改,植入后门可远程登录并持久化控制,最多5000名用户或受影响。官方已下架恶意版本,本文详解攻击手法与清理步骤。