开源事实核查工具:给AI Agent装上独立验证的信任层
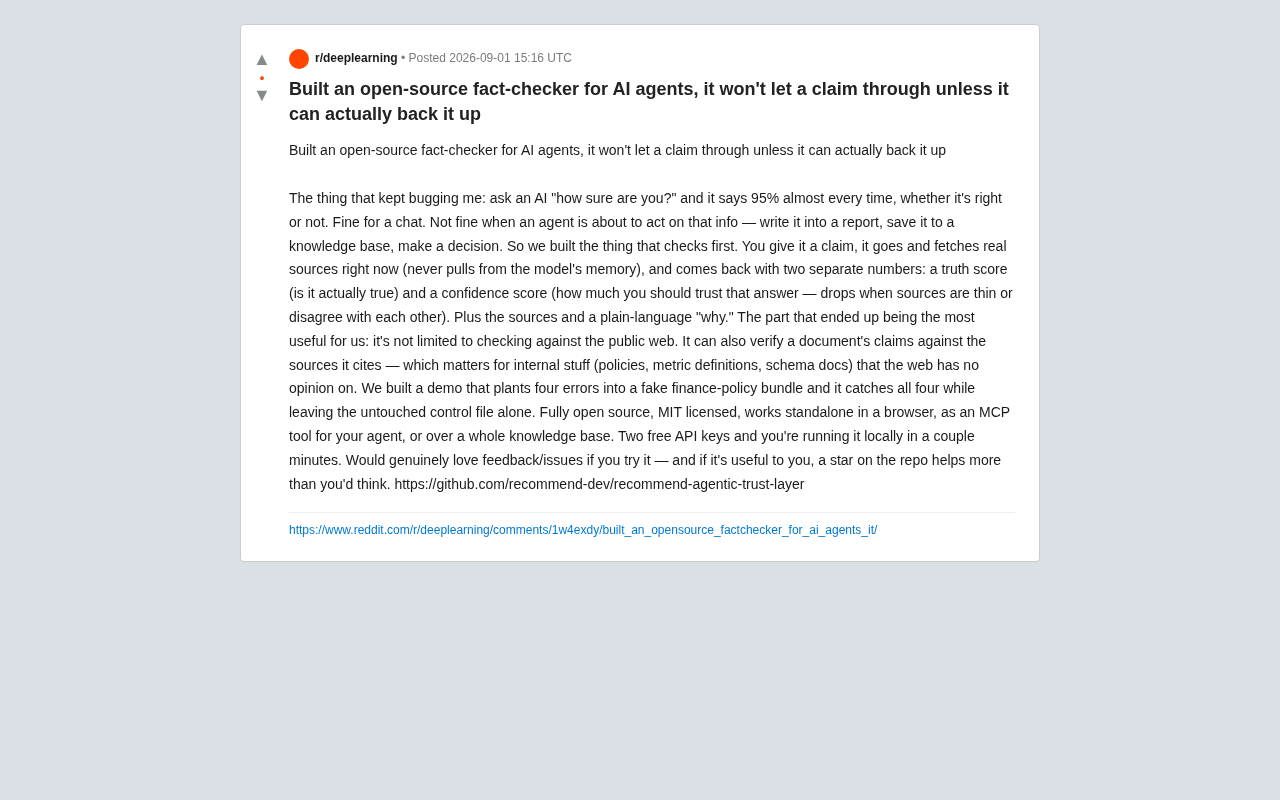
开源工具用"真实性+置信度"双分数机制,为AI Agent加装独立事实核查关卡
这篇文章介绍了一个名为recommend-agentic-trust-layer的开源项目,专门解决AI大模型输出"虚假自信"的问题。其核心设计是将真实性分数(Truth Score)与置信度分数(Confidence Score)彻底分离:前者通过实时抓取外部来源核查论断是否成立,后者则诚实反映核查结果本身的可信程度。工具同时支持对文档内部一致性的交叉验证,能发现论断与其所引用来源之间的矛盾,这对公共网络无法触及的企业内部文档尤为有价值。演示中,工具在植入四个错误的金融文件中实现零误报的精准捕捉。项目提供浏览器独立运行、MCP协议接入Agent工作流、批量知识库核查三种部署形态,定位为模型与真实世界之间的独立验证层。
AI的"95%自信"问题
如果你问一个大语言模型"你有多确定?",它几乎每次都会回答"95%"——无论答案对错。在日常聊天中,这或许无伤大雅。但当一个AI Agent准备基于这个"信息"采取行动时,问题就变得严重了:把它写进报告、存入知识库、甚至据此做出决策。
一个来自Reddit开发者社区的开源项目正是针对这个痛点而生。它的核心理念简单却关键:在AI说出一个论断之前,先去核实它到底站不站得住脚。这个项目名为 recommend-agentic-trust-layer,采用MIT许可证完全开源。
为什么模型输出的"自信"不可信
大模型的置信度输出本质上是概率分布的产物,而非对事实真伪的真实判断。它可能对一个完全错误的陈述表达高置信度,因为在训练语料的统计意义上,这个表述"看起来很合理"。当Agent进入自动化流程后,这种虚假的确定性会被层层放大,最终导致基于错误前提的连锁决策。
双分数机制:真实性与置信度彻底分离
这个事实核查工具最值得关注的设计,是把两个通常被混为一谈的指标彻底分开:
真实性分数(Truth Score)
衡量一个论断是否真的成立。关键在于,工具不会从模型的记忆里"回忆"答案,而是实时抓取真实来源进行核对。这一点至关重要——它同时规避了模型幻觉和训练数据过时的双重风险。
置信度分数(Confidence Score)
衡量你应该在多大程度上信任这个核查结果。当支撑来源稀少,或者不同来源之间相互矛盾时,这个分数会随之下降。换句话说,它诚实地告诉你"我这次判断的把握有多大",而不是永远输出一个虚高的数字。
除了两个分数,工具还会返回引用来源和一段通俗易懂的"为什么"解释,让整个核查过程透明可追溯,而非一个黑箱结论。
超越公开网络:核查文档内部一致性
开发者提到,对他们团队而言最有价值的功能,反而不是核对公共互联网信息,而是验证一份文档的论断是否与它所引用的来源相符。
这个能力对企业内部场景尤为关键。诸如内部政策、指标定义、数据库schema文档这类信息,公共网络上根本没有任何"意见"可供参考。传统的联网核查在这里完全失效,而这个工具可以针对文档自身引用的来源进行交叉验证。
演示效果:精准捕捉错误且零误报
为了证明这一能力,开发者构建了一个演示场景:在一份虚构的金融政策文件包中故意植入四个错误,同时保留一份未改动的对照文件。结果工具准确捕捉到全部四个错误,同时没有误报那份干净的对照文件。
这种"抓得准、不误伤"的表现,正是内部合规、财务审计、法务审查等严肃场景所需要的可靠性基准。
三种部署形态,几分钟即可上手
项目的工程化程度相当完整,提供了三种使用方式以适配不同场景:
- 浏览器独立运行:无需复杂环境配置,直接在浏览器里验证单条论断。
- 作为MCP工具接入Agent:通过Model Context Protocol协议,把事实核查能力直接嵌入AI Agent工作流,让Agent在行动前自动过一遍事实关。
- 面向整个知识库批量核查:批量验证大规模文档集合的一致性与真实性。
开发者表示,申请两个免费API密钥后,几分钟内就能在本地跑起来。
对AI Agent生态的实际意义
随着AI Agent从"能聊天"走向"能行动",可信度问题正从一个学术话题变成工程刚需。一个自动化Agent如果没有外部核查机制,它的每一个错误论断都可能沉淀进知识库、写入报告、触发下游动作,形成难以追溯的技术债。
这个"信任层"(Trust Layer)的定位很清晰:它不试图让模型本身变得更聪明,而是在模型与真实世界之间架起一道独立的验证关卡。真实性与置信度分离的设计,以及对文档内部一致性的核查能力,都体现了对实际企业场景的深入理解。
对于正在构建Agent应用的开发者,这类事实核查工具值得纳入技术选型的考量。作为开源项目,它也欢迎社区反馈与贡献——开发者在帖子中直言,如果它对你有用,一个GitHub star的帮助比想象中更大。
需要提醒的是,本文信息来源于单一Reddit开发者帖子,其Demo效果和实际表现有待更多独立验证。感兴趣的读者可前往项目仓库亲自试用评估。
相关推荐
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。
让AI自己开发AI工具:7天31次提交的自举踩坑实录
一位工程师让AI自动开发AI工具,7天跑出31个commit,自举成功率仅六分之一。本文复盘五类典型踩坑、11条结构性规律及AI审AI机制,揭示自举飞轮如何把失败变成永久免疫。