WorldBench开源:机器人世界模型标准化评估工具箱

一个被忽视的评估难题
当我们谈论具身智能(Embodied AI)和机器人学习时,「世界模型」(World Model)正成为一个越来越核心的概念。具身智能强调将智能系统嵌入具有物理实体的机器人中,使其能够通过与环境的真实交互来感知、学习和行动——这与纯软件AI有根本区别,因为机器人必须实时应对物理世界的不确定性。
具身智能的理论根基可追溯至哲学家梅洛-庞蒂的「身体图式」概念和心理学家詹姆斯·吉布森的「生态感知」理论,强调智能必须通过身体与环境的交互才能涌现。在深度学习时代,这一理念促成了「从模拟到现实(Sim-to-Real)」迁移、自监督感知学习等研究方向的繁荣。世界模型作为具身智能的核心组件,其技术演化经历了从简单递归神经网络(RNN/LSTM)到基于变换器(Transformer)架构的重大跨越,后者凭借注意力机制能够更好地捕捉长程时序依赖关系。
世界模型指的是机器人对物理环境的内部预测能力——给定当前状态和一个动作,模型能够预测下一步会发生什么。这一概念最早源自神经科学对大脑外部世界表征的研究,2018年 David Ha 与 Jürgen Schmidhuber 的论文《World Models》将其正式引入深度学习领域,提出机器人可以在「梦境」(即内部模拟)中学习策略再迁移到真实环境。这种能力是机器人进行规划、想象和决策的基础。
然而,一个长期存在的痛点是:我们该如何客观、系统地评估一个机器人世界模型的好坏? 与图像分类有 ImageNet、大语言模型有 MMLU 等成熟基准不同,机器人世界模型领域长期缺乏统一、易用的评估工具。研究者往往各自为政,用不同指标和数据集自证效果,导致横向对比困难重重。
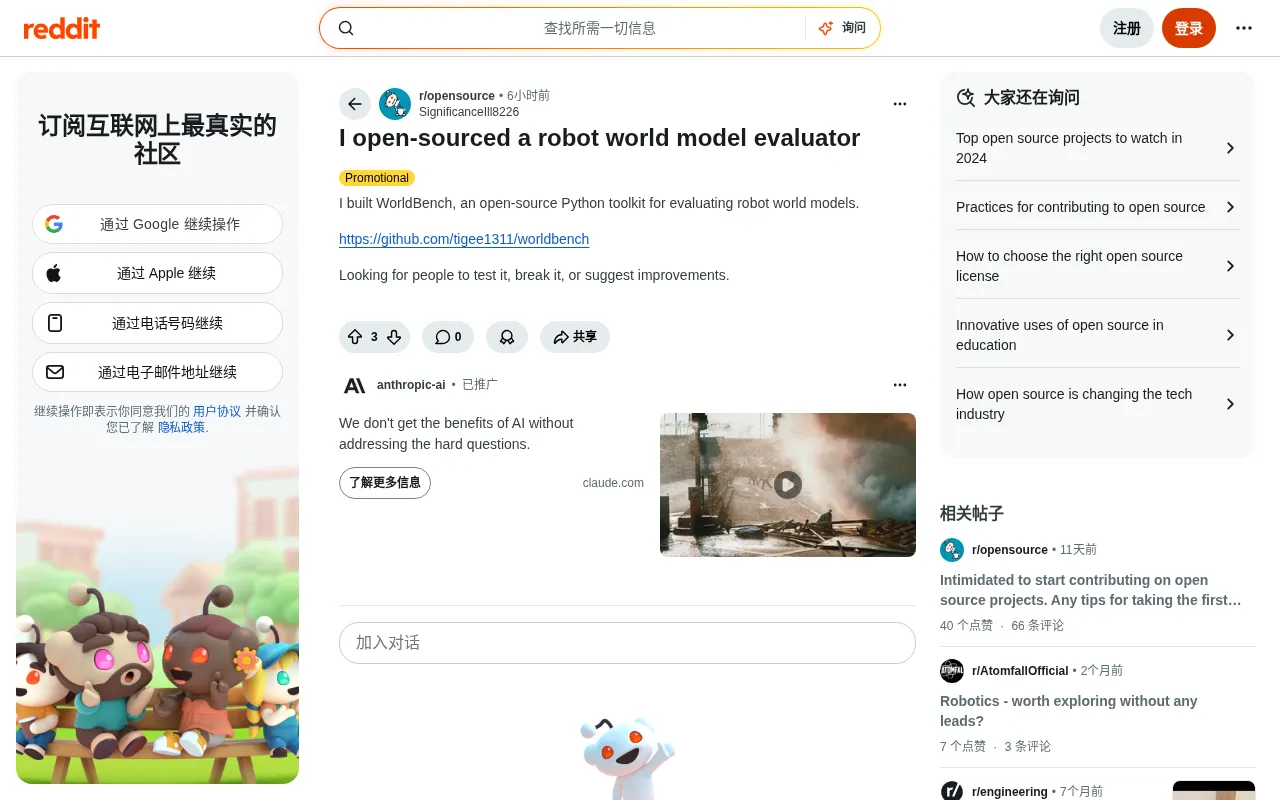
近日,一位开发者在 Reddit 上开源了名为 WorldBench 的项目,试图填补这一空白。这是一个用 Python 编写的开源工具包,专门用于评估机器人世界模型。作者在帖子中直言:「我做了 WorldBench,正在寻找人来测试它、破坏它,或者提出改进建议。」
WorldBench 解决了哪些核心问题
从「自说自话」到标准化评估
世界模型评估的复杂性在于它涉及多个维度,且每个维度都存在深层的技术挑战。一个好的世界模型不仅要预测得「像」,还要预测得「对」——即在物理规律、时间一致性、长程稳定性等方面都经得起推敲。
评估难度远超传统机器学习任务的根本原因在于几个核心矛盾:首先是「感知质量」与「预测正确性」的解耦问题——常用的视觉质量指标如 FID(Fréchet Inception Distance)和 LPIPS(Learned Perceptual Image Patch Similarity)可以衡量图像逼真程度,但无法捕捉物理合理性。FID 由 Heusel 等人于2017年提出,通过比较真实图像与生成图像在 Inception 网络特征空间中的分布距离来衡量生成质量,数值越低代表生成图像与真实图像分布越接近;LPIPS 则由 Zhang 等人于2018年提出,基于深度网络的感知特征计算图像相似性,比传统的 SSIM 或 PSNR 更接近人类视觉判断。然而这两个指标的根本局限在于:它们评估的是像素或特征层面的统计相似性,无法判断物理事件的因果逻辑是否正确——一个预测画面精美但物体运动违反牛顿定律的模型,仍然可以获得优秀的 FID 和 LPIPS 分数。
其次是「复合误差」问题——在自回归预测中,每一步的误差会叠加到下一步,导致长程预测迅速退化,如何量化这种退化速度本身就是一项挑战。自回归(Autoregressive)预测是指模型将自身上一步的输出作为下一步的输入,逐步生成未来序列。这种范式在语言模型(GPT系列)和视频预测中被广泛采用,但在物理环境预测中面临独特挑战:每一步预测不可避免地引入误差,而这些误差在自回归循环中会以指数级速度累积——这种现象在控制理论中被称为「误差传播」或「预测漂移」。为缓解这一问题,研究者提出了计划采样(Scheduled Sampling)、隐空间预测和集成预测(Ensemble Prediction)等多种技术路线。WorldBench 将长程一致性作为核心评估维度,正是对这一实际挑战的直接回应。
具体来说,评估机器人世界模型通常需要考察以下几个维度:
- 预测保真度:模型预测的未来状态与真实观测之间的差距有多大?
- 长程一致性:随着预测步数增加,误差是快速累积(发散)还是保持稳定?
- 物理合理性:预测结果是否符合基本物理约束,例如物体不会凭空消失或穿墙而过?
- 动作条件响应:给定不同动作时,模型能否产生正确对应的结果差异?
WorldBench 的核心价值,正是将这些分散的评估需求整合进统一的 Python 工具链,让研究者可以用一致的标准衡量不同模型的表现。
开源与社区共建策略
值得关注的是,作者采取了典型的「早期开源、社区共建」策略。项目当前处于早期阶段,作者主动邀请社区成员参与测试、寻找漏洞并提出建议。这种做法在机器学习工具领域相当普遍——一个评估基准的权威性,很大程度上依赖于社区的广泛采纳和持续贡献。
对于评估工具而言,「被广泛使用」本身就是其价值的重要组成部分。只有当足够多的团队用同一套工具报告结果时,跨论文、跨团队的对比才真正有意义。
为什么世界模型评估工具值得关注
世界模型正成为机器人学习的主战场
近两年,世界模型热度显著上升。从 DeepMind 的 Genie——一个能从单张图片生成可交互游戏环境的无监督世界模型——到基于扩散模型的机器人预测系统(如 UniSim、SuSIE),学界和业界都在探索让机器人「在脑海中演练」的可能性。
另一类值得关注的技术路线是基于隐空间(Latent Space)的世界模型,典型代表是 DreamerV3——它在压缩的潜在表示空间中进行预测,计算效率更高,已在多种机器人任务上展现出强大的样本效率。DreamerV3 由 Google DeepMind 的 Danijar Hafner 团队于2023年发布,是 Dreamer 系列的第三代成果。其核心创新在于:首先将高维观测(图像、声音等)编码至低维潜在空间,再在该压缩空间内进行递归状态预测,最终在「潜在梦境」中通过 Actor-Critic 算法训练策略,完全无需与真实环境交互。DreamerV3 的突破性在于其跨领域通用性——同一套超参数配置在 Atari 游戏、机器人操作、迷宫导航等截然不同的任务上均达到了接近或超越专用算法的水平,这在强化学习领域极为罕见。这种范式的吸引力在于:如果机器人能在内部世界模型中进行大量低成本的模拟推演,就可以大幅减少对昂贵真实世界交互数据的依赖。
然而热度背后隐藏着一个深层问题——评估的碎片化。当每个团队都使用自己的指标时,领域的整体进展就难以被准确衡量。一个可靠、开源的机器人世界模型评估工具,恰恰是推动领域健康发展的核心基础设施。
评估基准的长期价值
回顾深度学习的发展历程,许多关键突破背后都有配套评估基准的功劳。ImageNet 由斯坦福大学李飞飞团队于2009年建立,包含超过1400万张图片;2012年 AlexNet 凭借在其竞赛上的压倒性表现,标志着深度学习革命的开端。GLUE 与 SuperGLUE 则通过公开排行榜机制汇聚全球研究团队参与,成为推动 BERT、GPT 等模型迭代的核心驱动力之一。这些基准不仅提供衡量标准,更重要的是定义了什么问题值得解决,从而引导整个社区的研究方向。
在机器人领域,类似的尝试包括 RoboSuite(操作任务基准)和 Habitat(导航任务基准),它们均采用「提供标准化环境+社区持续贡献任务」的模式。值得注意的是,这些现有基准普遍聚焦于「策略性能」评估,而非针对世界模型本身的预测质量进行系统衡量——RoboSuite 基于 MuJoCo 物理引擎提供标准化的机械臂操作任务,重点评估抓取、放置、装配等精细操作能力的最终效果,Habitat 由 Meta AI Research 开发,专注于室内导航任务的路径规划成功率。WorldBench 所填补的,正是「模型对环境的预测有多准确」这一评估层次上的空白,与「基于这个模型训练出的策略有多好」在研究目的和方法论上存在本质区别。
这类工具的生命力取决于两个关键因素:技术门槛足够低(易于集成到现有研究流程),以及评估任务具备足够的多样性和挑战性以保持长期相关性。
WorldBench 目前还只是一个刚起步的社区项目,距离成为「机器人世界模型的 ImageNet」仍有很长的路。但它所瞄准的方向——为一个快速升温却缺乏标准的领域提供评估基础设施——无疑具有长远价值。WorldBench 能否走通这条路,将在很大程度上取决于能否吸引几个有影响力的研究团队率先采用并公开报告结果。
对开发者和研究者的实际意义
如果你正在从事机器人学习、具身智能或世界模型相关的研究与工程工作,WorldBench 值得纳入工具箱进行评估:
- 研究者可以用它标准化实验报告,让研究成果更容易被同行验证和横向对比。
- 工程师可以借助它快速定位模型的薄弱环节,例如发现模型在长程预测上误差发散严重。
- 社区贡献者则有机会在项目早期参与进来,直接影响这一潜在标准工具的设计走向。
作者的开源姿态务实而健康:不追求一步到位,而是先把框架搭起来,交给社区打磨。「测试它、破坏它、改进它」这句邀请,本身就体现了开源软件工程的核心精神——真正经得起推敲的工具,往往是在无数次被「破坏」和修复中成长起来的。
结语
WorldBench 是一个小而聚焦的开源项目,但它触及了机器人世界模型领域一个真实且重要的痛点:缺乏统一的评估标准。在世界模型日益成为具身智能核心的当下,这样的评估基础设施一旦被社区接纳并持续完善,将对整个领域的进步产生积极且深远的影响。
感兴趣的读者可前往项目 GitHub 仓库 亲自体验。无论是使用、测试还是贡献代码,早期参与者往往能对一个工具的未来走向产生更大的影响。
相关推荐

本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。