开源智能体本地部署实战:免费写代码、画图、生音乐

用开源工具链在本地搭建多模态AI工作站,以高端硬件换取长期免订阅的创作自由。
本文介绍了一套以本地大模型智能体为调度中枢,通过接入视觉模型、MCP文件操作工具链和ComfyUI图像工作流,构建"本地版多模态创作助手"的完整方案。核心配置三步走:将上下文窗口扩展至100万token、挂载视觉模型获得读图能力、安装MCP组件使智能体能够真正"动手"操作本地资源。在此基础上,智能体可以完成文生图、图像局部替换、高清放大乃至音乐乐器转换等任务,基本复刻云端多模态产品的核心功能。方案的硬件门槛较高,演示使用RTX 5090显卡与96GB内存,适合已有高端设备、注重数据隐私或需要长期大量使用生成能力的创作者,其真正价值在于展示了一种可自由扩展的模块化本地工作站搭建思路。
本地智能体的新玩法:一套开源组合替代云端订阅
随着大模型推理能力的提升,越来越多创作者尝试把智能体完整部署到本地,摆脱对云端订阅服务的依赖。这期B站UP主的演示提供了一个相当完整的样本:以一款本地智能体为核心,叠加视觉模型、文件操作 MCP、文生图工作流和音乐处理模型,最终拼出一个能写代码、读图、画图、改音乐的"本地版免费豆包"。
从硬件配置看,这套方案的门槛并不低——演示使用的是 RTX 5090 显卡搭配 96GB 内存,运行量化后的 IQ3 级别模型,整体流畅度令人满意。换句话说,本地智能体想要达到接近云端的体验,显存和内存仍是绕不开的硬性成本。但对于已有高端硬件的用户来说,一次性投入换来长期免订阅的创作自由,这笔账未必不划算。
三步让本地智能体"能干活"
部署完成只是起点,真正让智能体可用的是后续的三项关键配置。UP主给出的思路清晰且可复制:
第一,放开上下文窗口。 演示中将上下文拉到最高 100 万 token,这意味着智能体可以在超长文档、代码库或多轮复杂任务中保持记忆连贯,避免"聊着聊着就失忆"的尴尬。
第二,接入视觉模型。 下载并挂载视觉模型后,智能体获得了读图能力,可以理解截图、图表和参考图内容,这是后续图像生成和编辑任务的基础。
第三,装上 MCP 工具链。 通过文件操作等 MCP(Model Context Protocol)组件,智能体能够直接读写本地文件、调用外部工具,从"只会聊天"升级为"能动手"。演示中展示的代码运行效果——比如生成一个骑自行车动画、搭建一个音乐播放器界面——都依赖于这层工具能力。
MCP(Model Context Protocol) 是由 Anthropic 于2024年底提出的开放协议,旨在为大语言模型提供标准化的工具调用接口。其核心思想类似于 USB 接口的统一标准:无论底层是文件系统、数据库、浏览器还是外部 API,都可以通过同一套协议被模型"插拔"调用。在此之前,不同智能体框架各自实现工具调用逻辑,生态碎片化严重;MCP 的出现让工具组件可以跨框架复用。对本地部署而言,MCP 尤为关键——它允许智能体在不联网的前提下直接操作本地文件、执行脚本或调用本机服务,这正是从"对话助手"跨越到"自动化代理"的关键一步。
接入 ComfyUI:本地文生图与图像编辑一条龙
这套方案最亮眼的部分,是把智能体与 ComfyUI 打通,实现本地化的图像创作全流程。UP主的做法是在智能体启动时赋予它相应的 skill,让它自动集成文生图工作流、图片编辑工作流以及图片高清放大三套能力,智能体甚至在集成后主动给出了测试 demo。
实际效果值得关注:提供一张参考图,让智能体反推提示词并简单描述需求,就能产出新图;在此基础上还能做局部替换,比如把画面里的圣诞老人换成卡牌、把摆件换成星球或彩球,编辑的可控性相当不错。这种"描述即修改"的交互方式,正是云端产品如豆包主打的卖点,而这里完全跑在本地。
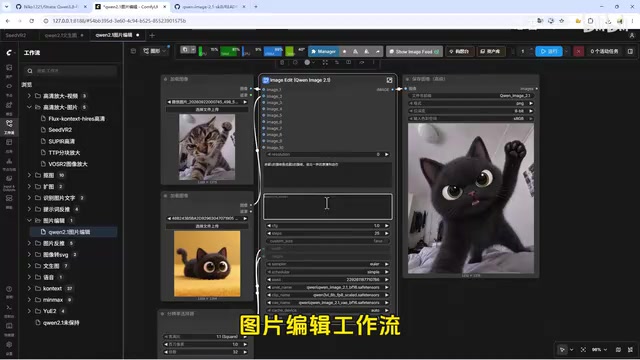
高清放大环节同样实用。UP主演示了用高清工作流处理原图,细节还原明显;对动漫图执行二次高清后,画质提升肉眼可见。对于需要批量出图或做二次创作的用户,本地放大流省去了反复上传下载和订阅额度的烦恼。
ComfyUI 是目前最主流的本地 Stable Diffusion 图形化工作流编辑器,采用节点式(node-based)架构,用户可以将采样器、VAE、ControlNet、放大模型等各类组件拖拽连接成一套可重复执行的图像处理管线。与 WebUI 相比,ComfyUI 的最大优势在于工作流可以被导出为 JSON 文件并通过 API 调用,这使得智能体能够以编程方式触发图像生成任务,而无需人工干预界面操作。正是这一特性,让智能体与 ComfyUI 的打通成为可能:智能体解析用户的自然语言需求,自动填充工作流参数,再通过 API 下发任务并取回结果,全程无需用户手动操作绘图界面。
不止画图:音乐模型也能接进来
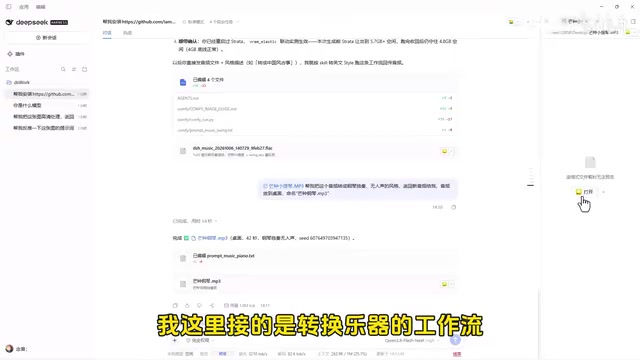
整套组合的扩展性在音乐处理上得到进一步体现。UP主将音乐模型接入智能体,演示了乐器转换工作流——给定一段原版音乐,用"转成钢琴伴奏"的提示词,就能输出改编后的钢琴版本。虽然视频后半段音频存在一些干扰,但从展示结果看,这类音频转换任务在本地跑通是可行的。
把文本、图像、音乐三类能力集中到同一个本地智能体入口,本质上是在复刻云端多模态产品的"全能助手"形态。差别在于,这里的每一项能力都通过开源工作流拼装而成,用户对流程有完全的掌控权,也不受额度和付费墙限制。
这套方案适合谁
客观看,这不是一个"开箱即用"的方案。它需要用户具备一定的部署能力:熟悉模型量化与显存管理、会配置 MCP 与 ComfyUI 工作流、理解显存弹性切换的调度逻辑(演示中为了同时跑智能体和图像模型,专门做了显存切换处理)。门槛明显高于直接打开一个云端 App。
但对于有高端显卡、注重数据隐私、或希望长期大量使用生成能力的创作者而言,这套开源组合提供了极具性价比的替代路径。它的真正价值不在于某一个模型多强,而在于展示了一种"模块化拼装"的思路——把智能体当作调度中枢,按需挂载视觉、绘图、音乐等能力模块,构建属于自己的本地多模态工作站。
需要提醒的是,演示中涉及的硬件配置、模型量化级别和具体效果均基于单一来源的实测展示,实际复现时的表现会因硬件和模型版本而异,建议动手前先评估自己的设备条件。
模型量化是本地部署大模型的核心技术之一。原始的大语言模型参数以 FP16 或 BF16 浮点数存储,显存占用极大;量化技术通过将权重压缩为更低精度(如 INT8、INT4,乃至更激进的 IQ3)来大幅降低显存需求,代价是轻微的精度损失。文中提到的 IQ3 属于 GGUF 格式下的非均匀量化方案,由 llama.cpp 社区发展而来,相较于早期的 Q3_K 等均匀量化方式,在同等压缩比下能更好地保留模型的关键权重,推理质量更高。以一个700亿参数模型为例,FP16 完整加载需要约140GB显存,而 IQ3 量化后可压缩至30-40GB范围,使消费级高端显卡勉强可用。量化级别的选择本质上是在显存预算与输出质量之间做取舍,没有放之四海皆准的最优解。
相关推荐

Heretic 2.0 发布:从去审查到通用模型修改工具
Heretic 2.0 正式发布,新增任意秩消融(ARA)算法与插件系统,从去审查专用工具进化为可抑制废话、降低谄媚、调整情感对齐的通用模型修改平台。37k GitHub 星标,Hugging Face 衍生模型超 8500 个。
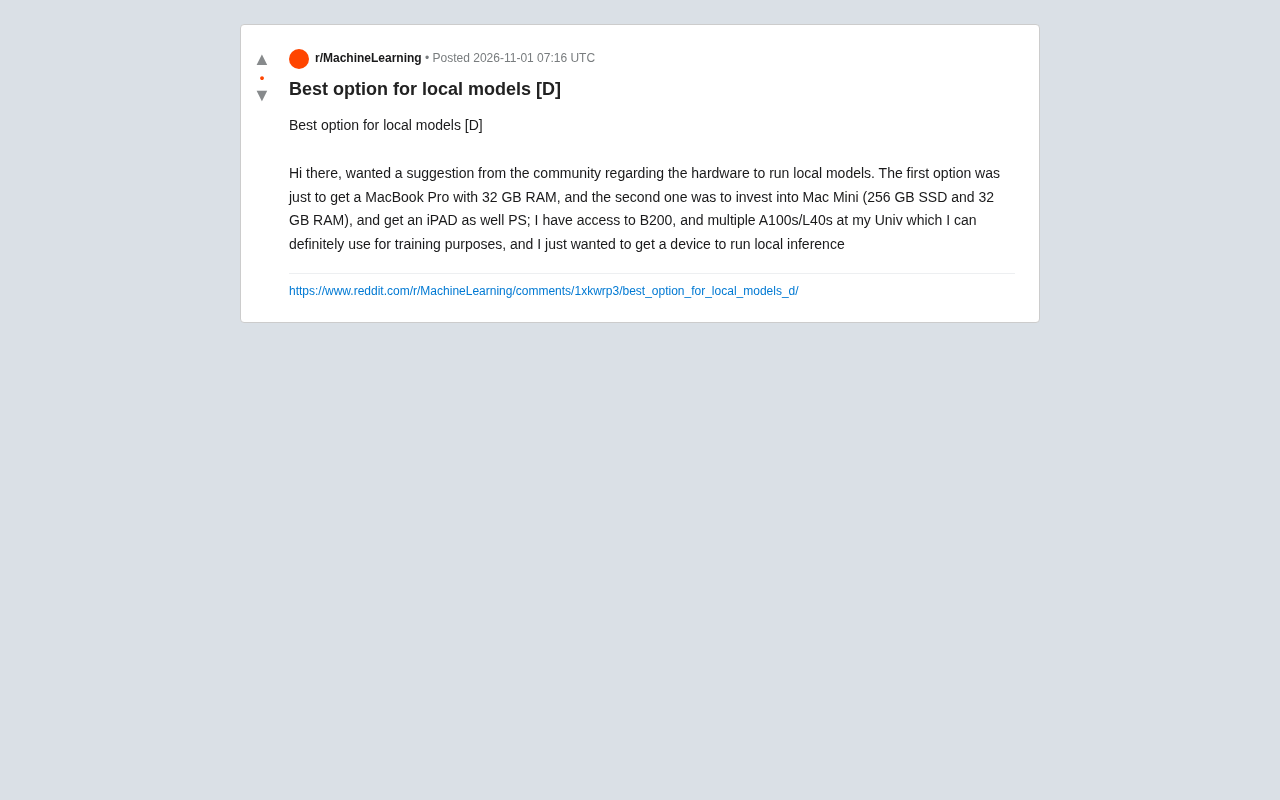
本地大模型硬件怎么选?MacBook Pro vs Mac Mini+iPad深度对比
Reddit社区热议本地大模型硬件选择:32GB MacBook Pro与Mac Mini+iPad组合如何取舍?本文从便携性、性价比、内存需求等角度深度分析,帮你找到最适合本地推理的设备方案。

AI Agent失败溯源:如何定位错误决策的根因?
Reddit讨论聚焦AI Agent失败溯源难题:如何定位导致Agent做出错误决策的根因?分析LangSmith、LangFuse等可观测性工具的局限,探讨手动分析与自建分析系统的实践组合,为Agent可靠性提升提供思路。