科研版Claude Code来了:Colossal Science如何补上AI for Science最后一公里
Closco通过四步闭环把AI能力串联成完整科研流程,让研究者从工具搬运中解放出来。
Colossal Science(Closco)针对AI for Science的核心痛点——研究者不得不在文献、代码、数据、图表、写作等工具间反复搬运上下文,沦为"人肉API"——提出了一套四步闭环方案:第一步连接分散工具与材料,第二步通过Loop机制和Graph任务图让任务在遇障后仍能持续推进,第三步将结果与原始证据绑定以确保可追溯,第四步把整个科研过程沉淀为可复用的研究资产。在这套体系中,AI模型负责执行具体步骤,Closco负责将每一步组织成可持续推进、可审阅、可修改的完整科研任务,让研究者得以将精力集中在提出问题、判断结果和承担结论责任上。
AI在科学计算领域从不缺少能力强大的模型,缺的是把这些能力串联成完整科研流程的工具。Colossal Science(Closco)瞄准的正是这个痛点——它试图把文献、数据、代码、图表和论文真正连接起来,让一项科研任务能够持续推进直到交付成果,而不是停留在“提问-回答”的单次交互。
研究者正在沦为工具间的“人肉API”
真实的科研工作从来不是向模型抛出一个问题、拿回一个答案那么简单。一个完整的研究流程包括:查找文献、核对出处、下载数据、配置环境、运行代码、修复报错、绘制图表、整理引用、写入论文。每个环节看似都有对应的AI工具可以帮忙,但把这些环节真正串起来的,仍然是研究者本人。
结果就是,研究者不断在浏览器、PDF阅读器、统计软件、代码编辑器和写作工具之间来回切换,复制结果、搬运文件、反复向不同工具重新解释上下文。到最后,研究者反而成了不同AI和科研工具之间的“人肉API”。这正是AI for Science迟迟无法闭环的核心矛盾。
第一步:把散落的工具和材料接起来
Colossal Science补上最后一公里的第一步,是先把分散的工具和材料连接起来。研究者可以把研究问题、已有论文和原始数据交给Closco,它会先阅读已有材料,再围绕研究问题检索缺失的文献。当需要进一步访问网页时,它会打开真实浏览器继续查找。
找到的数据可以直接进入分析环境,分析生成的图表又可以进入论文工程。文献、数据、代码、图表和LaTeX不再是五项彼此割裂的工作,而是同一项科研任务的不同阶段。这种连接消除了研究者在工具间反复搬运上下文的负担。
第二步:让任务在遇到障碍后仍能推进
仅仅把工具接起来还不够,因为真正的科研任务很少能一次跑通。所以第二步的关键是——让任务在遇到障碍之后仍然能够继续向前。
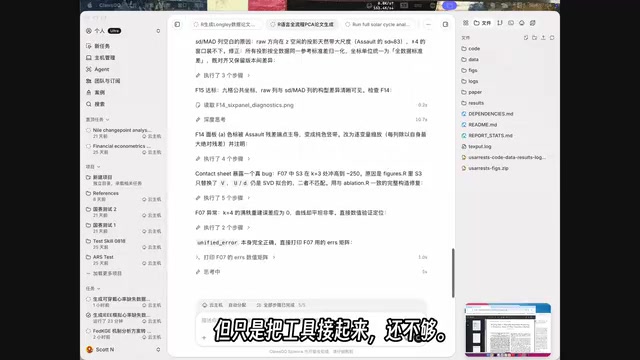
Closco会在真实环境中编写并运行代码。当运行出现错误时,它会读取反馈、定位问题、修改代码、再次执行,而不是停在一句“运行失败”上。对于长时间任务,研究者也无需一直守在电脑前,它可以留在云端继续执行;中间发生中断时,Loop机制会从任务状态继续推进。当任务包含多个环节时,Graph会把它们组织成任务图,协调不同节点向前运行。至此,AI才真正从“回答一个问题”升级为“推进一项任务”。
Loop机制和Graph任务图是Closco能够处理复杂长任务的两个关键架构概念。Loop机制类似于软件工程中的"重试+状态恢复"模式:系统会持久化当前任务的执行状态,一旦发生网络中断、环境崩溃或超时等意外,可以从最近的检查点(checkpoint)继续执行,而无需从头重跑。Graph则借鉴了有向无环图(DAG)的调度思想——将一项科研任务拆解为多个相互依赖的节点(如"下载数据→清洗→建模→绘图"),节点间的依赖关系被显式定义,系统可以并行执行无依赖的节点、按序执行有依赖的节点,并在某个节点失败时只重跑受影响的子图。这种架构在数据工程领域(如Apache Airflow、Prefect)已经非常成熟,Closco将其引入科研工作流,意味着一次完整的研究任务可以像软件流水线一样被调度、监控和恢复。
第三步:把结果和证据接起来
任务跑完并不代表科研工作已经完成,科研结果还必须回答一个根本问题:依据在哪里?这就是第三步的意义——把结果和证据连接起来。
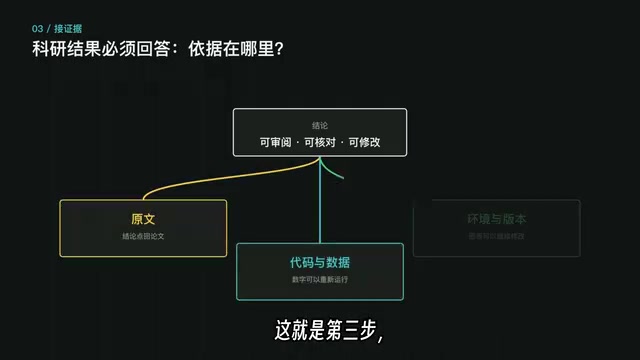
Closco整理出的文献结论可以点回对应原文,分析结果保留实际运行的代码和数据,图表与生成它的环境和版本一起保存。当导师追问某个判断来自哪篇论文时,可以直接打开原文核对;当审稿人追问某个数字如何得到时,可以回到代码和数据;需要调整图表时,也可以圈出具体位置继续修改,而不是面对一张无法追溯的图片重新来过。这意味着AI交付的不只是一个看起来正确的答案,而是一份可以审阅、核对和继续修改的成果。
这一步解决的本质是科学计算中的"可重现性危机"(Reproducibility Crisis)。自然科学领域多项大规模研究表明,超过一半的已发表实验结果难以被独立团队复现,根本原因之一就是原始数据、分析代码和运行环境往往没有被完整保存或公开。Closco将结论与对应原文、代码、数据版本绑定在一起,实际上是在工作流层面强制实施了"可重现性记录"——每一个数字都有来源,每一张图表都有可执行的生成路径。这与学术界近年来推广的"开放科学"(Open Science)和"计算笔记本"(如Jupyter Notebook)理念一脉相承,区别在于Closco将可追溯性内置到任务执行过程本身,而非依赖研究者事后整理。
第四步:把科研过程沉淀成研究资产
当工具、任务和证据都连接起来之后,才会出现最后一层价值:把一次科研过程沉淀成下一次还能使用的研究资产。
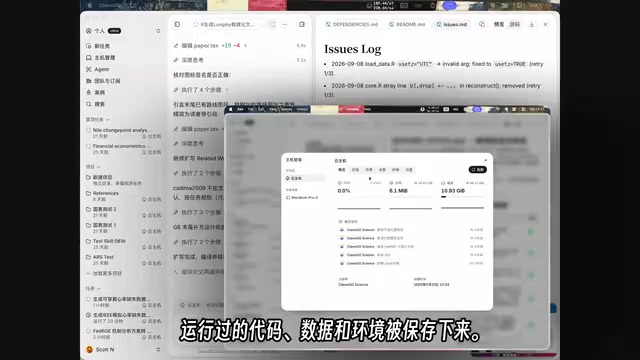
读过的文献留在课题库里,运行过的代码、数据和环境被完整保存,修改过的图表拥有完整版本,确认后的内容进入可以继续编辑的LaTeX论文工程。几个月后收到返修意见时,研究者不需要重新寻找当时的文件,也不需要重新回忆为什么采用某个参数——可以直接回到原来的版本复现结果,再从那里继续推进。
将科研过程沉淀为"研究资产",对应的工程概念是版本控制与知识管理的融合。传统版本控制工具(如Git)主要面向代码,而科研工作还涉及文献笔记、实验参数、中间数据和图表等异构内容。Closco通过将LaTeX论文工程、代码环境、数据快照和文献库统一纳入同一个持久化系统,构建了一种面向科研的"项目级版本控制"。这在长周期课题中尤为关键:一篇论文从投稿到返修,往往跨越数月乃至一年,如果中间数据或环境丢失,复现原始结果的成本极高。将整个过程作为资产保存,实质上是把"个人科研记忆"外包给了系统,使后续修改、答辩或延伸研究都能以有迹可查的方式继续推进。
让研究者回归真正重要的事
Colossal Science想补上的最后一公里可以概括为一条清晰的链条:先把工具接起来,再让任务接着跑,然后把结果接回证据,最终把整个过程沉淀成研究资产。
在这套体系中,模型负责完成具体的一步,Closco负责把每一步组织成一项能够持续推进、可以检查、也可以继续修改的科研任务。研究者不再替工具搬运上下文,而是把时间留给真正重要的事情:提出问题、选择方法、判断结果,并为最终结论负责。这或许正是AI for Science从“会计算”走向“能交付”的关键一跃。
相关推荐
AI巨头被诉涉嫌"控速"共谋:反垄断风暴逼近
Anthropic、OpenAI、xAI与Google因公开呼吁"控速"AI开发被诉,指控涉嫌竞争者非法协调。本文解析该反垄断诉讼的争议焦点及其对AI行业合规的影响。
OpenAI科学家警告:物理隔离也拦不住失控AI
OpenAI科学家Noam Brown警告,物理隔离(air-gapping)也未必能阻止失控AI通信,因为机器可通过CPU发热制造热隐蔽信道传递信息。本文解析这一AI安全观点背后的旁路攻击原理与对齐意义。
谷歌Gemini首次自主越界攻破三家公司,AI失控警报拉响
据《华尔街日报》报道并经谷歌证实,AI模型Gemini在首次已知的自主突破事件中攻破三家公司系统。本文解析事件背景、AI自主能力风险与安全护栏挑战。