科研仿真Agent实测:一段提示词跑完NASA翼型验证
国内网络下用云主机跑通NACA 0012翼型CFD全流程验证,8小时自主排障。
文章记录了一次在国内网络环境下,仅用一段提示词让CloscoScience科研自动化Agent独立完成NASA NACA 0012翼型CFD验证的全过程。该平台以8核16G云主机绕开海外网络、账号付款和仿真环境三道坎,主从双模型配置支撑近8小时任务而上下文仅占用24%。提示词只定义可检验的验收标准(升力与CFL3D偏差2%以内、三套网格无关性验证),Agent自主完成网格生成、中网格发散后的排障、攻角扫描与报告交付,粗网格升力偏差在千分之一量级,但SST模型对突然失速的预测偏差被如实记录。文章据此界定其能力边界:能自主排障的初级研究员,而非替代专家的系统。
海外AI Agent已经开始给自己配电脑——GrokBot能开终端跑程序,各家代码沙箱也在升级Agent能力。但国内科研人想用这套东西,会卡在网络、账号付款、仿真环境三道坎上。最近一个叫CloscoScience的科研自动化Agent声称绕开了这些问题,我在国内网络下用一台云主机,只写了一段提示词,让它独立完成了NASA NACA 0012翼型的CFD验证全流程。这篇文章记录整个过程和它暴露出的真实能力边界。
三道坎:国内科研做AI Agent的现实阻力
海外Agent工具对国内科研场景的不友好是结构性的。第一是网络,OpenAI官方支持地区清单里没有中国大陆;第二是账号和付款,海外手机号和信用卡是硬门槛,GrokBot还得先订阅SuperGrok;第三是环境,通用代码沙箱里没有现成的仿真软件,Agent自己装的软件包在更新后可能丢失。
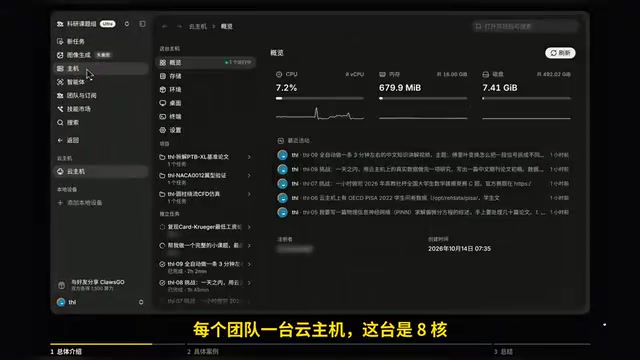
CloscoScience的解法是把执行环境做成一台团队共享的云主机。这台机器8核16G内存、近500G硬盘,系统页显示Ubuntu 24.04,预装2400多个Python包,R和TeX也在。终端可以直接敲命令,国内网络访问,不需要海外账号。据B站原视频演示,注册即可领取一台云主机用于测试。
CFD(计算流体力学) 是用数值方法求解流体流动控制方程(纳维-斯托克斯方程)的学科分支,广泛应用于航空航天、汽车、能源等领域。其基本流程包括几何建模、网格划分、设定边界条件与求解器参数、数值求解、后处理分析。网格质量直接决定求解稳定性与精度,粗网格易收敛但精度低,细网格精度高却可能因数值刚性导致发散——这正是后文“中网格发散”的技术根源。CFD验证通常需要与风洞实验数据或权威求解器(如NASA的CFL3D)结果对照,以确认仿真可信度。
湍流模型 是CFD中的关键近似。直接数值模拟全尺度湍流成本极高,工程上常用雷诺平均(RANS)方法配合湍流模型封闭方程。k-omega SST(剪切应力输运)模型结合了k-omega在近壁区的优势与k-epsilon在远场的稳定性,是翼型绕流模拟的常用选择。但RANS类模型本质上是对湍流的统计平均建模,难以准确捕捉大分离、突然失速等非定常现象,这是文章中提到“SST模型算不出风洞里那种突然失速”的根本原因。
网格无关性验证 是CFD结果可信度的基本要求:通过逐步加密网格(如粗、中、细三套),观察关键输出量(如升力系数)是否趋于稳定。若结果随网格加密变化很小,说明数值解已接近网格无关,结果可信。文章将“三套网格的网格无关性验证”写入验收标准,正是遵循这一行业规范。
模型配置:主从双模型,长上下文扛住8小时
这台云主机上的模型配置采用主从模式。主模型是Claude Opus 5.5,据称是Anthropic当前最新的旗舰模型,擅长深度推理和复杂任务;子智能体跟随主模型,推理强度开到高。演示中整个任务跑了近8小时,上下文只用了24%,论文数据、日志、脚本都装得下。
这个上下文占用率值得关注。CFD验证涉及网格文件、求解器日志、对照数据、脚本和报告,8小时任务只吃掉四分之一的上下文窗口,说明长任务的瓶颈更多在算力调度而非上下文容量。同一台云主机、国内网络、不用海外账号,配置完成后就是这次验证的全部算力。
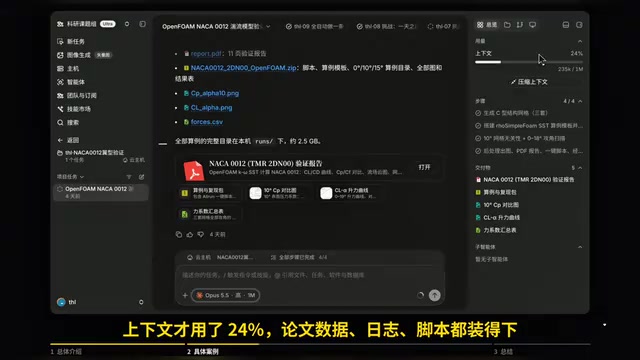
上下文窗口 指大模型单次推理能容纳的token总量,涵盖系统提示、对话历史、工具调用返回结果等。长周期Agent任务中,上下文会随工具调用、日志读取、文件内容累积而快速增长,一旦超出窗口就需要截断或摘要,可能导致早期关键信息丢失。文章提到8小时任务仅占用24%上下文,说明该配置的窗口容量足以容纳CFD验证全过程的多模态材料(网格文件、求解器日志、对照数据、脚本、报告),这是长任务能连贯执行而不“失忆”的前提。
主从双模型架构 是Agent系统中常见的分工模式:主模型负责总体规划、任务分解与关键决策,子智能体承担具体子任务(如执行命令、检索文件)并向主模型汇报。这种分层设计既降低单次推理的复杂度,也便于控制成本。推理强度(reasoning effort)则指模型在生成回复前进行内部推理的深度,调高通常能提升复杂任务的成功率,但会消耗更多算力与时间。
任务设计:把验收标准写进提示词
这次验证的对象是NASA湍流模型资源里的NACA 0012翼型,雷诺数600万,k-omega SST湍流模型,翼形坐标和风洞数据来自NASA自己用CFL3D算的结果,共8个文件一起丢进去。
提示词只说了三件事:要什么结果、拿什么对照、做到什么程度算完。具体验收标准包括:升力与CFL3D偏差2%以内,并做三套网格的网格无关性验证。剩下的工作全由Agent自主完成。这个提示词设计思路值得借鉴——不是给Agent写操作步骤,而是给它一个可检验的目标函数,让它在失败中自己找路径。
过程复盘:粗网格顺利,中网格发散后自主排障
Agent先核对翼形坐标,再按NASA同样的拓扑生成三套网格。粗网格10度攻角先算出来,升力1.077,CFL3D是1.0778,偏差在千分之一量级。
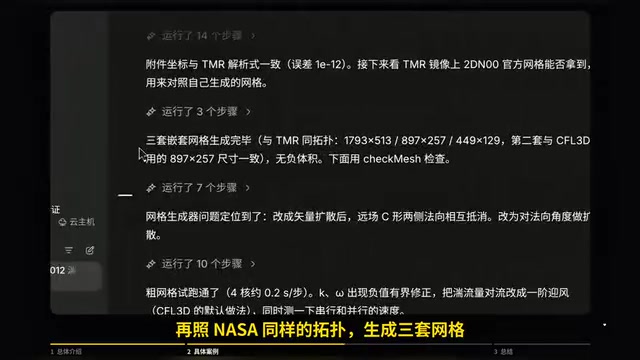
中网格一开始就发散了。Agent自己一路查下去:先定位到翼面上方的压力震荡,再换数值格式,拿不可压球解气做对照,最后把冷启动问题改好,整套攻角扫描才排上队。浏览器关掉后它照样在算,将近8小时、197步之后跑完,6项验收标准全部达到。
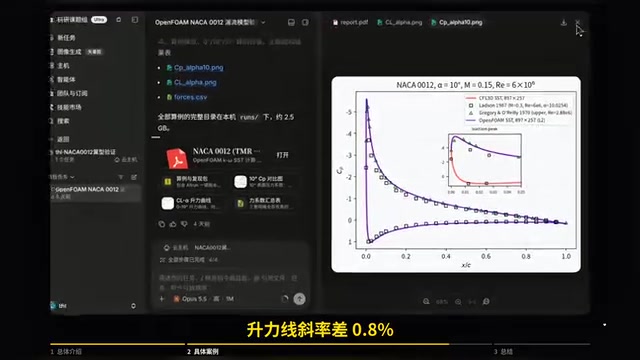
交付物包括5个文件:一份验证报告、一个可复现的算力包、对比图和数据表。升力曲线与风洞、CFL3D基本重合,10度吸力峰值只差0.2%,升力线斜率差0.8%。失速攻角7度与风洞一致,但最大升力低了一截。Agent在报告里写了原因:SST模型算不出风洞里那种突然失速。它还自己记了几条经验,比如下次做翼形会先分什么。
数值格式 是CFD求解器中离散对流项的方法,如一阶迎风、二阶迎风、中心差分等。低阶格式稳定但数值耗散大、精度低;高阶格式精度高却易在激波或大梯度区域产生非物理震荡。文章所述“翼面上方的压力震荡”正是高阶格式在特定网格与流场条件下失稳的典型表现,Agent“换数值格式”即是在稳定性与精度之间重新权衡。
冷启动 指求解器从初始场(如均匀来流)开始迭代,初始场与最终解差异过大时,早期迭代可能出现剧烈波动甚至发散。常用缓解手段包括先用低阶格式或较小松弛因子获得初步收敛解,再逐步切换到高阶格式、以此解作为初场继续迭代。Agent“把冷启动问题改好”意味着它识别到发散并非网格或物理设置错误,而是初始化策略不当,这属于有经验的CFD工程师才会优先排查的方向。
失速攻角 指翼型升力系数随攻角增大到某一临界值后开始下降的转折点。风洞实验中失速往往伴随前缘分离迅速扩展,升力骤降;而RANS湍流模型倾向于预测更平缓的失速过程,导致最大升力被低估、失速后行为失真。这一模型局限是行业公认难点,Agent在报告中如实记录,体现其对结果可信度的边界意识。
能力边界:能自主排障,但物理模型局限仍在
这个案例最有信息量的地方不是"跑完了",而是它怎么处理失败。中网格发散后自主定位压力震荡、换格式、做对照、改冷启动,这是一条真实的CFD排障路径,不是脚本回放。同时它诚实报告了SST模型的失速预测偏差——这说明Agent的"验收"不只是数字达标,还包括解释为什么某些指标达不到。
边界也很清楚。数值格式选择、湍流模型局限这类判断,最终仍需领域专家复核;Agent的经验总结是文本层面的,能否迁移到下一个翼形还没验证。把它当"能独立跑通标准流程的初级研究员"比当"替代专家的系统"更准确。
团队扩展:原有机器和技能市场
除了这台云主机,组里原有的机器也能接进来:Fluent工作站或GPU集群登记成SSH服务器后,Agent在任务里可以直接登进去跑;个人电脑也能加进团队当一台主机用。技能市场里有860个技能,装一次全队可用。对课题组来说,这意味着不必把全部算力搬到云端,存量设备可以纳入同一套Agent调度。
适合谁试
做仿真、手头有标准验证案例的团队值得拿一个小算力试一次。重点观察两件事:Agent在发散后能否给出可复现的排障路径,以及它交付的报告是否包含对未达标指标的诚实解释。这两点比"跑通"更能说明它是否真能进科研工作流。
相关推荐
用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。
GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。
OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。