Kimi Code Desktop:会在你睡觉时写完整个App的AI编程助手

Moonshot AI推出Kimi Code Desktop,以K3模型驱动多模式Agent工作区,可自主完成端到端开发任务。
Moonshot AI推出的Kimi Code Desktop将AI编程工具从"代码补全助手"升级为可独立接管开发流程的Agent工作区。产品提供Goal、Plan、Swarm三种模式,其中Swarm模式可启动多个并行子Agent协同处理复杂任务。底层由K3模型支撑,宣称拥有2.8万亿参数与100万token上下文窗口,理论上可将整个代码库纳入单次推理范围。演示中,仅凭一句"构建带Auth的SaaS落地页"指令,Agent在无人干预的情况下于隔夜完成了含在线链接、git diff、测试和浏览器预览的完整交付物。产品定位面向希望跳出传统编码循环、转向Agent驱动开发的开发者群体,但其在复杂生产环境中的稳定性仍有待更多实证验证。
从终端Agent到桌面工作区
Moonshot AI(月之暗面)推出的Kimi Code Desktop,把原本运行在终端里的编程Agent升级成了一个完整的单窗口工作区。它瞄准的不是传统意义上的代码补全工具,而是一个能够独立完成任务的"Agent工作台"。
与那些只会在你敲代码时给出建议的自动补全编辑器不同,Kimi Code Desktop的定位是:你打开项目,它来接管。据YouTube上的演示介绍,这个Agent能够读取代码、编辑文件、运行命令并验证执行结果——整个开发闭环都由它来跑通,而不是等你一步步手动输入提示词。
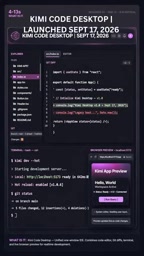
这种从"辅助"到"接管"的转变,代表了AI编程工具正在发生的一次范式变化。开发者需要的不再是更聪明的自动补全,而是一个真正能够承担端到端任务的协作者。
三种工作模式应对不同场景
Kimi Code Desktop提供了三种运行模式,分别对应不同复杂度的任务需求:
Goal Mode(目标模式)
面向长周期任务。你只需要描述最终目标,Agent会自行规划并持续执行,适合那种需要跨越多个步骤、耗时较长的开发工作。
Plan Mode(计划模式)
面向具体的代码修改。它会先给出编辑方案,再执行变更,让开发者对改动范围有更清晰的掌控。
Swarm Mode(蜂群模式)
这是最具野心的一个模式——Agent会启动多个并行的子Agent同时工作。换句话说,它可以把一个大任务拆解成若干子任务,让多个"分身"并发推进,从而大幅压缩完成时间。
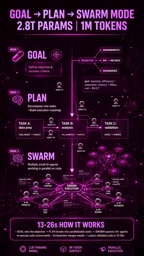
这种并行Agent的设计思路,正是当前AI Agent领域探索的重要方向之一:单个Agent的能力有上限,而通过多Agent协作来处理复杂工程任务,可能是突破瓶颈的关键。
多Agent协作架构(Multi-Agent System)是近年AI工程化落地的核心研究方向之一。其基本原理是将一个复杂任务拆解为多个相对独立的子任务,由"编排Agent"(Orchestrator)负责分配,多个"工作Agent"(Worker)并发执行,最终由编排层汇总结果。这种设计能突破单一模型在单次推理中的时间与能力瓶颈,但也引入了新的挑战:子Agent之间需要共享上下文、避免冲突写入(如同时修改同一文件),并在局部失败时具备回滚或重试机制。K3的百万token上下文窗口在此起到关键作用——只有当所有子Agent都能访问足够完整的项目信息,并行分工才不会产生相互矛盾的代码修改。
K3模型:2.8万亿参数与百万token上下文
支撑这套系统的是Moonshot AI的K3模型,据介绍拥有2.8万亿(2.8 trillion)参数,并配备100万token的上下文窗口。
百万级的上下文窗口意味着什么?用演示者的话说,它可以"记住你的整个代码库"。对于大型项目而言,上下文长度往往是AI编程工具的致命短板——模型记不住足够多的代码,就无法做出全局一致的修改。而百万token的容量,让Agent在处理跨文件、跨模块的任务时,能够保持对整个工程的完整认知。
这也是Swarm Mode等功能得以成立的底层前提:没有足够的上下文能力,并行子Agent之间就难以维持一致性。
上下文窗口(Context Window)指模型在单次推理中能够"看到"的最大文本长度,以token为单位衡量。1个token大约对应0.75个英文单词或约1.5个中文字符。100万token的上下文约可容纳75万个英文单词,相当于数百个源代码文件同时加载。作为对比,GPT-4早期版本上下文仅有8K token,当前主流模型普遍在128K至200K token之间。对编程任务而言,上下文长度决定了模型能否同时"看见"多个模块的依赖关系、历史变更记录和测试结果,直接影响跨文件重构、全局变量追踪等高复杂度任务的完成质量。2.8万亿参数的规模若属实,则约为GPT-4(据传约1.8万亿参数)的1.5倍量级,属于当前已知的超大规模稀疏MoE(混合专家)架构区间。
睡一觉醒来,App已经上线
演示中最吸引眼球的,是一个"睡觉实验"。演示者给出的指令是:"帮我构建一个带身份认证(Auth)的SaaS落地页",然后就去睡觉了。
等他醒来时,呈现在面前的是:一个可访问的在线链接(live link)、完整的git diff记录、通过的测试,以及浏览器预览——全程没有任何提示词循环(prompt loop),不需要人反复介入纠偏。
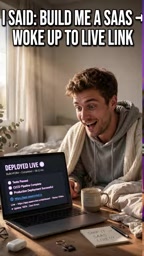
如果这个演示的效果属实,它确实展示了AI编程Agent的一个理想状态:开发者只负责定义需求,剩下的实现、验证、部署全部交给Agent自主完成。当然,这类演示往往经过精心挑选,真实复杂项目中的表现仍需更多验证。
演示中提到的"无提示词循环"(no prompt loop)是区分传统AI编程助手与自主Agent的关键指标。传统工具(如早期Copilot)需要开发者反复输入提示、审查输出、再次提示,形成人机交替的"对话循环"。而自主Agent的设计目标是:在接收初始指令后,能够自主执行"感知—规划—行动—验证"的闭环,遇到错误时自我修正,而非等待人工干预。git diff记录和自动化测试通过是这一闭环的外部可验证标志——前者证明Agent确实对代码库做出了结构性修改,后者证明修改在功能层面得到了验证,而非仅生成了看似合理的代码片段。
给谁用?编程是否已死?
Kimi Code Desktop的目标用户定位非常明确:那些想要一个"Agent工作区"而非"又一个自动补全编辑器"的开发者。
演示结尾抛出了一个颇具争议的问题:"编程已经死了,还是程序员变成了10倍生产力?"(Is coding dead, or are coders now 10x?)
这个问题没有标准答案,但它点出了当下AI编程工具带来的核心张力。一方面,Agent确实能把重复性、流程化的开发工作自动化,让单个开发者的产出成倍提升;另一方面,这类工具对需求定义、架构判断和结果验证的能力提出了更高要求——Agent跑得越快,人对方向的把控就越重要。
对于希望跳出传统编码循环、尝试Agent驱动开发方式的团队和个人来说,Kimi Code Desktop代表了一个值得关注的方向。不过在把它真正投入生产环境之前,理性评估其在复杂业务场景下的稳定性,仍然是必要的一步。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。