Kimi K3.1 Pro开源模型追平GPT-6 Astra,国产AI就业政策出台
国产开源模型逼近顶尖、Anthropic推主动智能体、AI就业政策出台。
本周AI领域三条主线并行。月之暗面开源Kimi K3.1 Pro,参数规模接近3万亿,在真实编程任务测试中取得65.7%的成绩,超过GPT-6 Astra,距OPEX 5.5仅差0.7,并在训练中主动剔除网络攻击相关数据以平衡开源与安全,完整权重计划11月4日前开放。Anthropic推出主动型智能体Claude Duet,可定期查看已连接应用并主动提醒重要事项,拥有云端电脑支持离线处理,但发消息、付款等关键操作仍需用户确认。国务院办公厅发布AI与就业文件,提出6方面18项任务,既强调以AI创造新机会,也要求减缓对文书助理、初级会计、流水线等岗位的替代冲击。三者分别对应模型能力、产品形态与政策环境三个维度。
一周AI大事:国产开源模型逼近GPT-6 Astra,AI就业政策引关注
过去一周,AI领域动态密集:月之暗面开源了参数规模接近3万亿的Kimi K3.1 Pro,在真实编程任务中表现抢眼;Anthropic推出主动型智能体Claude Duet,探索个人智能体新形态;国务院办公厅则发布了AI与就业的专项文件,试图在技术进步与就业保障之间寻求平衡。以下是对本周关键事件的梳理与分析。
国产开源模型新突破:Kimi K3.1 Pro
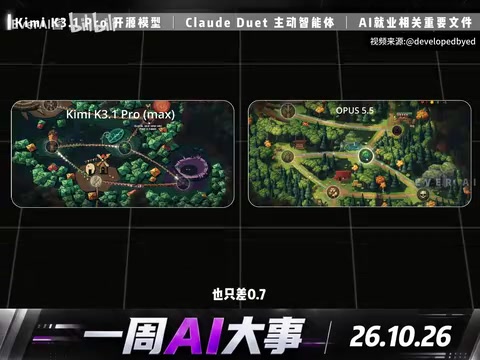
月之暗面在周末发布了Kimi K3.1 Pro开源模型,参数规模接近3万亿。据B站UP主在视频中展示,该模型在“做游戏、写软件”等场景下展现出令人印象深刻的生成效果。
更值得关注的是其在编程任务上的量化表现。在一项真实编程任务测试中,Kimi K3.1 Pro取得了65.7%的成绩,不仅超过了GPT-6 Astra,距离OPEX 5.5也仅有0.7的差距。这一结果意味着国产开源模型在代码生成与软件构建能力上,已经进入国际第一梯队的竞争区间。
安全考量:主动剔除攻击相关数据
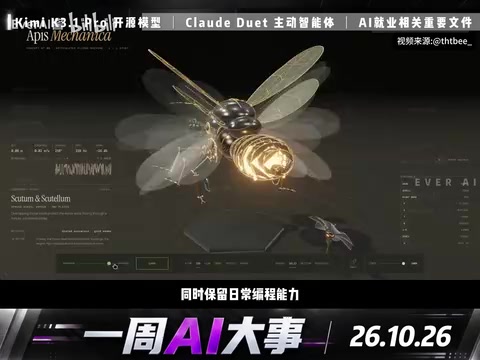
Kimi此次在训练策略上还有一个特别之处:主动剔除了部分网络攻击相关数据,以降低模型被滥用于攻击系统的风险,同时尽量保留日常编程能力的完整性。这种做法反映了模型开发者在开源与安全之间寻求平衡的尝试——在开放权重的同时,通过数据层面的筛选来抑制恶意使用场景。
完整模型权重计划在11月4日前开放,开发者将能够在自己的设备上部署该模型。对于需要本地化、隐私敏感或定制化AI能力的团队而言,这是一个值得关注的选项。
混合专家架构与激活参数:Kimi K3.1 Pro 宣称的“接近3万亿参数”在业内通常指模型的总参数量,而非每次推理实际参与计算的数量。当前超大规模开源模型普遍采用混合专家(MoE)架构,前向计算时只激活其中一小部分专家,因此“总参数”与“激活参数”是两个需要区分的指标。这解释了一个现象:一个总参数接近3万亿的模型,其推理成本未必按同等倍数增长,在消费级或多卡设备上部署也具备现实可能。评估此类模型时,更值得关注的是激活参数规模、专家数量与路由策略,而非仅看总参数,这也是比较不同模型“体量”时常见的误区。
开放权重与开源的区别:文中“完整模型权重计划开放”属于**开放权重(open weights)**发布,即公开训练后得到的参数文件,允许他人下载、部署甚至微调,但通常不公开训练数据、训练代码与完整流程。这与严格意义上的开源软件存在差别:使用者获得的是可运行、可修改的模型,却难以完全复现其训练过程。开放权重的好处是降低本地部署门槛,适合隐私敏感或需要定制的场景;代价是发布方对下游用途的控制力较弱,一旦权重流出便难以回收。因此“剔除攻击相关数据”这类前置筛选,往往成为开放权重发布者在安全与开放之间采取的主要手段之一。
Anthropic入局个人智能体:Claude Duet
Anthropic本周推出了主动型智能体Claude Duet,正式进入个人智能体赛道。与以往需要用户主动发起指令的AI不同,Claude Duet在获得授权后,会定期查看已连接的应用,发现重要邮件或待办事项时主动提醒用户。
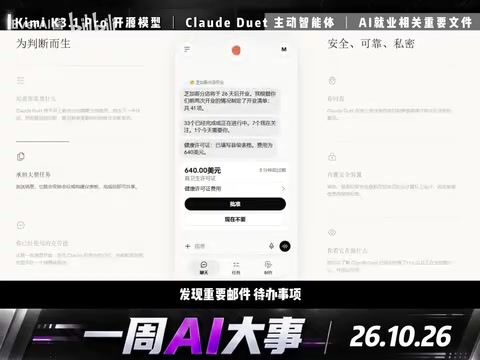
该智能体拥有自己的云端电脑,即使你关闭了设备,它也能继续处理任务。不过,对于发消息、付款等重要操作,仍然需要用户确认。这种设计在提升自动化效率的同时,保留了关键环节的人类控制权,是当前智能体产品在信任机制上的常见折中方案。
从行业趋势看,个人智能体正从“被动响应”向“主动服务”演进。Claude Duet的推出意味着Anthropic不再局限于模型API供应,而是开始向应用层延伸,与已有的智能体产品形成直接竞争。
智能体的“主动”与工具调用:所谓主动型智能体,指的是在用户预设授权与触发条件下,能够自行发起检查、判断并执行动作的系统,其技术基础是**工具调用(tool use / function calling)**与任务规划能力:模型通过调用邮件、日历、待办等应用接口读取状态,再依据规则决定是否提醒或代办。主动性的提升也带来新的风险面——错误判断可能触发多余操作、权限范围过宽可能造成隐私暴露、长期后台运行则涉及凭证与数据存储安全。因此“重要操作需用户确认”并非简单的产品妥协,而是把不可逆或高后果的动作留在人类审批环节,属于当前智能体设计中被广泛采用的权限分级思路。
国内政策:AI与就业的平衡之道
国务院办公厅本周出台了AI与就业相关的重要文件,提出了6个方面、18项任务,特别提及AI对就业的影响。
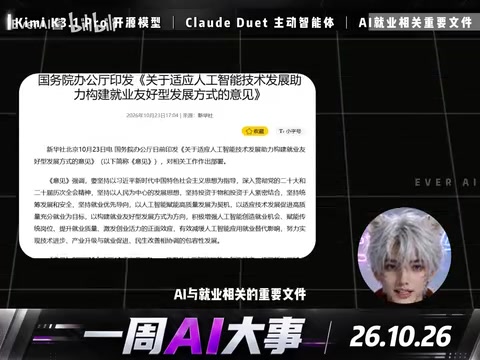
文件的双重基调值得注意:一方面强调利用AI创造新机会,另一方面明确要减缓AI对文书助理、初级会计、制造业流水线等岗位的替代冲击。文件提出需要推动技术进步与就业民生相协调,减少岗位替代冲击,并加强技能培训。
这一政策信号表明,监管层对AI的就业影响已有清晰认知,并试图通过政策工具进行前置干预。对于企业而言,这意味着在推进AI自动化的同时,需要更重视员工技能转型与岗位再设计;对于从业者,技能培训与跨领域能力建设的重要性进一步凸显。
AI 就业影响的“任务替代”视角:经济学界在评估AI对就业的冲击时,通常区分“岗位替代”与“任务替代”。一项工作往往由多种任务组成,AI更可能先替代其中标准化、可重复的部分任务(如文书整理、初级核算、流水线重复操作),再由人类承担判断、沟通与异常处理等环节。这解释了文件为何点名文书助理、初级会计、制造业流水线等岗位——它们属于任务结构中以规则化任务为主的类型。相应的政策工具也围绕任务层面展开:技能培训帮助劳动者转向不易被替代的任务,岗位再设计则重新划分人机分工,而非简单以“岗位是否消失”作为判断标准。
本周观察
三件事分别对应了AI发展的三个维度:模型能力(Kimi K3.1 Pro)、产品形态(Claude Duet)与政策环境(就业文件)。国产开源模型在编程任务上逼近国际顶尖水平,说明开源社区的追赶速度在加快;智能体产品从被动工具转向主动服务,交互范式正在迁移;而就业政策的出台,则提醒我们技术落地的社会成本需要被纳入考量。三者叠加,构成了当前AI行业既竞争激烈又需谨慎平衡的真实图景。
相关推荐
B站最系统Agent智能体开发教程:从零基础到企业级实战
B站系统Agent智能体开发教程解析:从提示词、工具调用、记忆与上下文管理、知识库到多Agent协同,拆解五大核心模块,并通过实战项目对标企业级Agent开发岗位要求,适合零基础与转型程序员学习。
零基础转行AI Agent开发:双非二本的逆袭路径
B站UP主分享:计算机专业就业难,AI Agent开发对学历包容,零基础入门需掌握Python、RAG、Tool Use和LangChain,中小厂就业机会多。
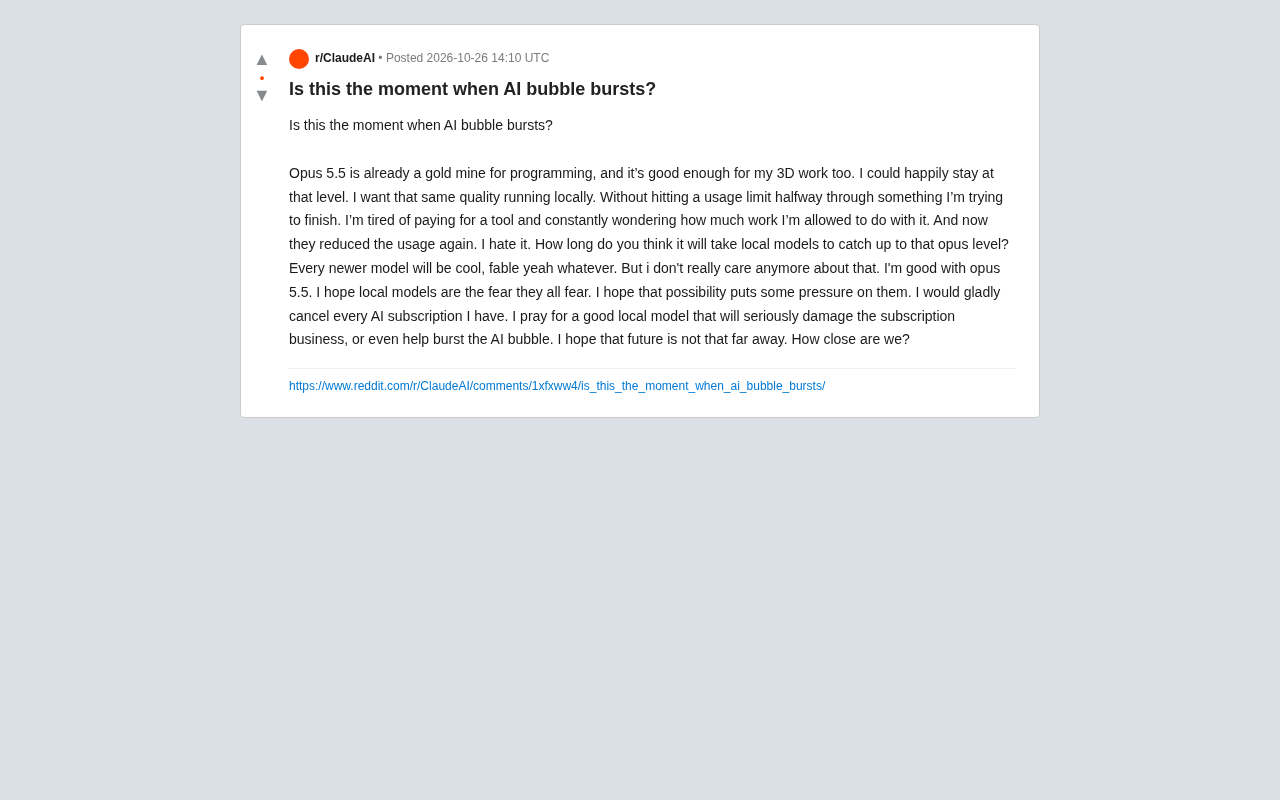
AI泡沫要破了?用户怒问本地模型何时追上Opus
Reddit用户吐槽AI订阅用量被缩减,直言Opus 5.5已够用,只想要同等质量的本地模型,并期待本地模型冲击订阅制、戳破AI泡沫。本文分析这一用户心态转变背后的信号。