Kimi K3.1 Pro权重开源:AI开源与安全收紧并行

Kimi K3.1 Pro权重开源,OpenAI推产品、Anthropic倡验证,开源加速与安全收紧并行。
文章以 Moonshot AI 完整开源 Kimi K3.1 Pro 模型权重为切入点,梳理同日多条 AI 动态,指出行业正沿两条主线推进:其一是开放加速,权重开源让开发者可自主部署微调、数据不出域,Rayman Computing 公开 131 亿参数模型的训练技术账,则把可复现性一并补上;其二是安全与验证收紧,OpenAI 发布 Images 2.6 持续增强生成能力,Anthropic 呼吁厂商证明模型输出真实。医疗 AI 工具进入临床流程,说明成熟度在提升;而自动化薅额度的开源项目走红也提示协议风险。叠加美国中期选举带来的政策不确定性,文章认为能力、验证、产品与监管四条线同时推进才是当下真实节奏。
Moonshot AI 把 Kimi K3.1 Pro 的模型权重完整放了出来,开源阵营又多了一个有竞争力的选手。同一时间,OpenAI 在推进图像生成产品,Anthropic 则在呼吁给模型加"说真话"的验证机制。据 B 站 UP 主白光的日报梳理,这一天的几条动态放在一起看,恰好勾勒出当前 AI 行业的两条主线:开源在加速,安全在收紧。
Kimi K3.1 Pro 开源权重意味着什么
据 TechNote 报道,Moonshot AI 此次放出的是完整模型权重,而非仅开放 API 调用。对开发者来说,这意味着可以自己部署、自己微调,不必被单一 API 绑死。
权重开源的价值不只是"免费"。它让中小团队能在本地或私有云上跑模型,数据不出域,微调方向也能按自己的业务来定。国产模型这两年从追赶到并跑,靠的正是这种愿意把权重交出来的动作——生态先做起来,工具链和二次开发才会跟上。
什么是"模型权重":模型权重是神经网络在训练完成后保留下来的参数集合,可以理解为模型"学到的经验"本身。推理时,输入数据与这些参数做运算得到输出。所谓"开源权重",就是把这些参数文件公开放出,任何人都能下载并在自己的硬件上运行。它与"开源训练代码""开源训练数据"是不同的开放层级:公布权重的模型(如 Llama 系列)通常被称为 open-weight 模型,而非严格意义上的完全开源模型。因此,拿到权重意味着可以本地推理与微调,但未必知道模型是如何被训练出来的,这也解释了后文为何把"公开技术账"视为与开源权重互补的另一件事。
131亿参数模型的技术账被摊开
Rayman Computing 公布了 131 亿参数模型的开发技术账。把训练过程摊开来讲的做法并不多见——多数团队只公布结果指标,不披露中间过程。
这类"技术账"对行业的价值在于可复现性。参数规模、训练路径、资源投入这些信息公开后,其他团队可以少走弯路,也方便外界判断一个模型的能力来源。开源权重与公开技术细节是两件事,前者给的是使用权,后者给的是方法论,两者叠加才算真正意义上的开放。
参数规模与"技术账"的含义:参数量指模型中可训练变量的总数,粗略反映模型容量与算力需求,但不直接等同于能力——数据质量、训练策略、后训练对齐的影响往往更大。131 亿参数属于中等规模,常见于可在单机多卡或中等集群上部署的场景。所谓"技术账",是把训练预算拆开公布:用了多少 token、多少 GPU 小时、几轮训练与何种数据配比、做了哪些消融实验。这类信息披露是模型卡(model card)与训练报告实践的延伸,能让外部团队判断结果的可信度,也为复现提供依据,是开放生态从"给权"走向"给方法"的关键一步。
一个踩油门,一个装刹车
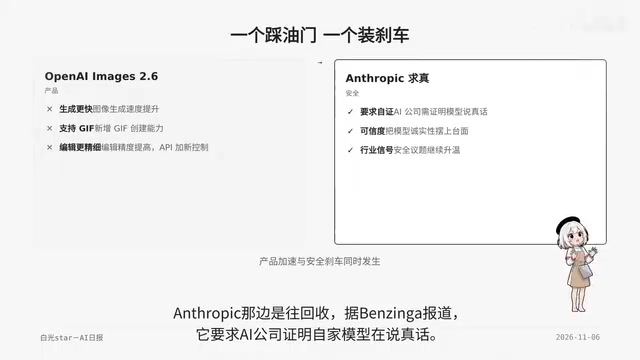
OpenAI 这边是产品往前推。Images 2.6 发布,图像生成更快,支持 GIF,编辑能力更精细,API 也加了新的控制系统。产品迭代的方向很清楚:把生成能力做得更可用、更可控。
Anthropic 那边是往回收。据 Benzin Go 报道,它公开呼吁 AI 公司需要证明自家模型说的是真话。这不是单纯的技术问题,而是信任机制的问题——模型输出越来越像人话,验证它是否可靠的成本也在上升。
一个加速能力,一个加装验证,两条路线并不矛盾。能力越强,验证的需求越迫切;验证越成熟,能力才越敢往高风险场景放。
为什么需要"证明模型说真话":大语言模型的输出是概率生成的结果,它在训练中学会的是"像正确答案的样子",而非"知道自己是否正确",因此可能自信地给出错误信息,即幻觉。要验证输出真实性,业界目前有几条路径:一是让模型给出可核查的引用来源;二是引入外部工具或检索做事实比对;三是用独立的验证模型对回答做审计;四是让模型在不确定时表达置信度或拒答。Anthropic 的呼吁指向的是,厂商应把这类机制作为可被外部检验的承诺公开,而不只是内部口号。能力越强,输出越像人话,人工辨伪的成本就越高,验证机制因此成为能力释放的前置条件。
医疗场景的落地与开源项目的提醒
据 Modern Healthcare 报道,Mail Clinic Platform 给临床医生上线了 AI 工具,接入诊疗流程。医疗是容错率最低的行业之一,工具能进医院,说明其可解释性和审核流程经得起检验。这类落地比通用聊天场景更能说明 AI 的实际成熟度。
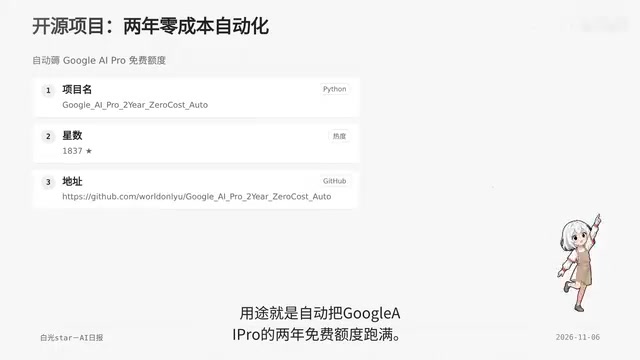
开源项目方面,一个 Google AI Pro 两年零成本自动化的项目拿到 1837 颗星,用 Python 编写,主打自动跑满免费额度。这类项目星数涨得快,但使用前需要看清条款——自动化薅额度往往踩在服务协议边缘,账号风险要自己承担。
政策变量与行业节奏
美国中期选举民主党大胜,AI 政策走向被打上问号。监管口径的变化会直接影响模型训练、数据使用和部署合规,对开源模型的分发尤其敏感——权重一旦放出就很难收回,政策收紧时开源阵营往往首当其冲。
把这几条放在一起,节奏就很清楚了:开源在加速,安全在收紧,产品在推进,政策在观望。四条线同时往前跑,才是当下 AI 行业的真实状态。对开发者而言,机会在于开源权重带来的自主性,风险在于合规与验证成本正在同步上升。
开源权重为何对监管变化更敏感:模型权重一旦公开发布,就无法像 API 那样在服务端下线、限制访问或追溯使用者,分发本身具有不可逆性。这意味着以"部署后监管"为思路的政策,对开源权重几乎失效;监管方只能在发布前设门槛,例如要求能力评估、训练数据披露或发布许可。也正因如此,各国在讨论高风险模型规则时,常对开源与闭源采用不同口径。对开发者而言,这带来的现实影响是:选型时除了看性能,还要关注模型的许可证条款与后续版本是否可能因合规压力而收紧,避免把业务架构绑定在分发政策不确定的权重上。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。