KL正则化强化学习的紧致样本复杂度:新界与下界
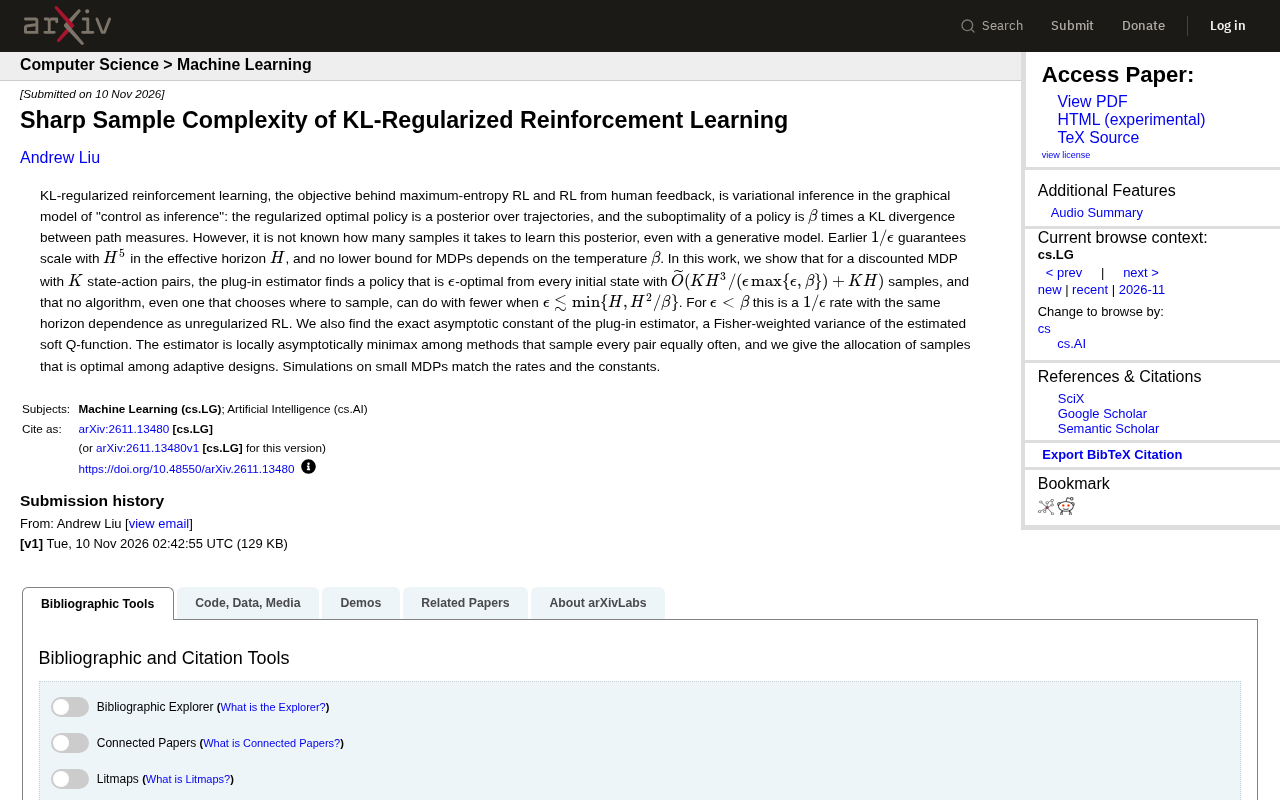
KL正则化强化学习的插件估计器达到minimax最优样本复杂度,将H的幂次从5降至3,并揭示温度参数β的作用。
本文研究KL正则化强化学习的样本复杂度,该目标函数是最大熵RL和RLHF的核心。作者针对折扣MDP提出插件估计器,证明其样本复杂度上界为\widetilde{O}(KH^3/(ε\max\{ε,β\}) + KH),并将有效时域H的幂次从先前的5次降低到3次。同时,作者证明了匹配的下界,表明在ε \lesssim \min\{H, H^2/β\}时该估计器是minimax最优的。特别地,当ε < β时样本复杂度为Θ(KH^3/ε),与无正则化RL相同,说明KL正则化并未增加学习难度。此外,作者刻画了精确渐近常数(软Q函数的Fisher加权方差),并给出了自适应设计下的最优样本分配策略。模拟实验验证了理论结果。该工作深化了对KL正则化RL样本复杂度的理解,为RLHF和最大熵RL算法设计提供了理论指导。
KL正则化强化学习是最大熵强化学习和基于人类反馈的强化学习(RLHF)背后的核心目标函数,本质上是“控制即推断”图模型中的变分推断问题。在该框架下,正则化后的最优策略是轨迹空间上的后验分布,而策略的次优性等于路径测度之间KL散度的β倍。然而,如何从样本中高效学习这一后验分布,其样本复杂度一直未得到精确刻画——即使是在拥有生成模型的情况下。
近期一项理论研究填补了这一空白:作者针对折扣MDP,给出了插件估计器(plug-in estimator)的紧致样本复杂度上界,并证明了匹配的下界,表明在广泛参数范围内该估计器是minimax最优的。该工作不仅将先前保证中有效时域H的幂次从五次方降低到三次方,还首次揭示了温度参数β在样本复杂度中的关键作用。
问题背景:从控制即推断到样本复杂度
经典强化学习追求最大化累积奖励,而KL正则化强化学习在目标中额外加入策略与参考策略之间的KL散度惩罚。这种形式在最大熵RL和RLHF中极为常见,其最优策略可以通过贝叶斯推断得到:将奖励视为观测,策略为后验。数学上,正则化最优策略p满足p(τ) ∝ p0(τ) exp(A(τ)/β),其中A为优势函数,β为温度参数。
尽管这一推断视角优雅,但实际中我们只能通过采样来近似后验。此前的研究给出了1/ε的样本复杂度保证,但其对有效时域H的依赖高达H^5,且下界未体现β的影响。对于实际算法设计而言,理解样本复杂度如何随H和β缩放至关重要。
变分推断与后验分布:在“控制即推断”框架中,强化学习问题被转化为概率图模型上的推断问题。具体而言,将轨迹视为隐变量,奖励视为观测,最优策略对应于给定观测下轨迹的后验分布。由于精确后验难以计算,通常采用变分推断,即在一个策略族中寻找与真实后验最接近的分布,最小化KL散度。由此得到的变分目标恰好等价于KL正则化强化学习的目标函数,其中KL惩罚项对应变分推断中的证据下界(ELBO)中的KL项。这一联系解释了为何最大熵RL和RLHF中的正则化最优策略具有解析形式,并为样本复杂度分析提供了统计推断的视角。
主要结果:上界与下界匹配
论文考虑具有K个状态-动作对的折扣MDP。作者证明,插件估计器——即先估计软Q函数,再导出贪婪策略——能够以\widetilde{O}(KH^3/(ε\max{ε,β}) + KH)个样本找到从每个初始状态出发都是ε最优的策略。这一上界在ε < β时表现为1/ε速率,且对H的依赖与无正则化RL相同(H^3)。当ε较大时,样本复杂度则与β成反比,体现了正则化强度对学习难度的影响。
更关键的是,作者证明了匹配的下界:任何算法,即使允许主动选择采样位置,在ε \lesssim \min{H, H^2/β}时都无法用更少的样本。这意味着插件估计器在该范围内是minimax最优的。特别地,当ε < β时,样本复杂度恰好为Θ(KH^3/ε),与无正则化情形一致,说明KL正则化并未增加学习难度(在ε较小时)。
Minimax最优性:在统计决策理论中,minimax最优性指一个估计器在最坏情况下的风险(此处为样本复杂度)与任何其他估计器相比都是最优的,即达到了下界。具体到本文,作者证明了插件估计器的样本复杂度上界与任何算法(即使允许自适应采样)的下界在常数因子内匹配,从而确立了该估计器在给定参数范围内的minimax最优性。这一性质意味着没有算法能显著超越插件估计器,为其实用性提供了理论保障。
精确渐近常数与自适应设计
除了速率,作者还刻画了插件估计器的精确渐近常数:它是估计的软Q函数的Fisher加权方差。这一常数揭示了估计误差的分布特性,并表明该估计器在均匀采样每对状态-动作的方法中是局部渐近minimax最优的。
对于自适应设计,作者给出了最优的样本分配策略,即根据状态-动作对的不确定性分配采样次数。模拟实验在小规模MDP上验证了理论速率和常数,为理论结果提供了实证支持。
Fisher加权方差:Fisher信息量衡量了数据中关于未知参数的信息量,其逆给出了参数估计的渐近方差下界(Cramér-Rao下界)。在本文中,精确渐近常数是估计的软Q函数的Fisher加权方差,即在每个状态-动作对上,估计误差的方差与该点上Fisher信息量的加权和有关。这一常数刻画了插件估计器误差的分布特性,并表明在均匀采样下,该估计器达到了局部渐近minimax最优,即其渐近方差与任何估计器的最小可能方差同阶。
意义与展望
该工作深化了我们对KL正则化强化学习样本复杂度的理解,将有效时域的依赖从H^5改进到H^3,并首次揭示了β的作用。这为设计更高效的RLHF和最大熵RL算法提供了理论指导。未来方向包括将结果推广到更一般的函数逼近 setting 以及探索非折扣MDP下的紧致界。
对于实践者而言,这一结果暗示当正则化较强(β较大)时,学习后验可能需要更多样本;而当ε较小时,正则化几乎不影响样本效率。这有助于在RLHF中合理设置温度参数和采样预算。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
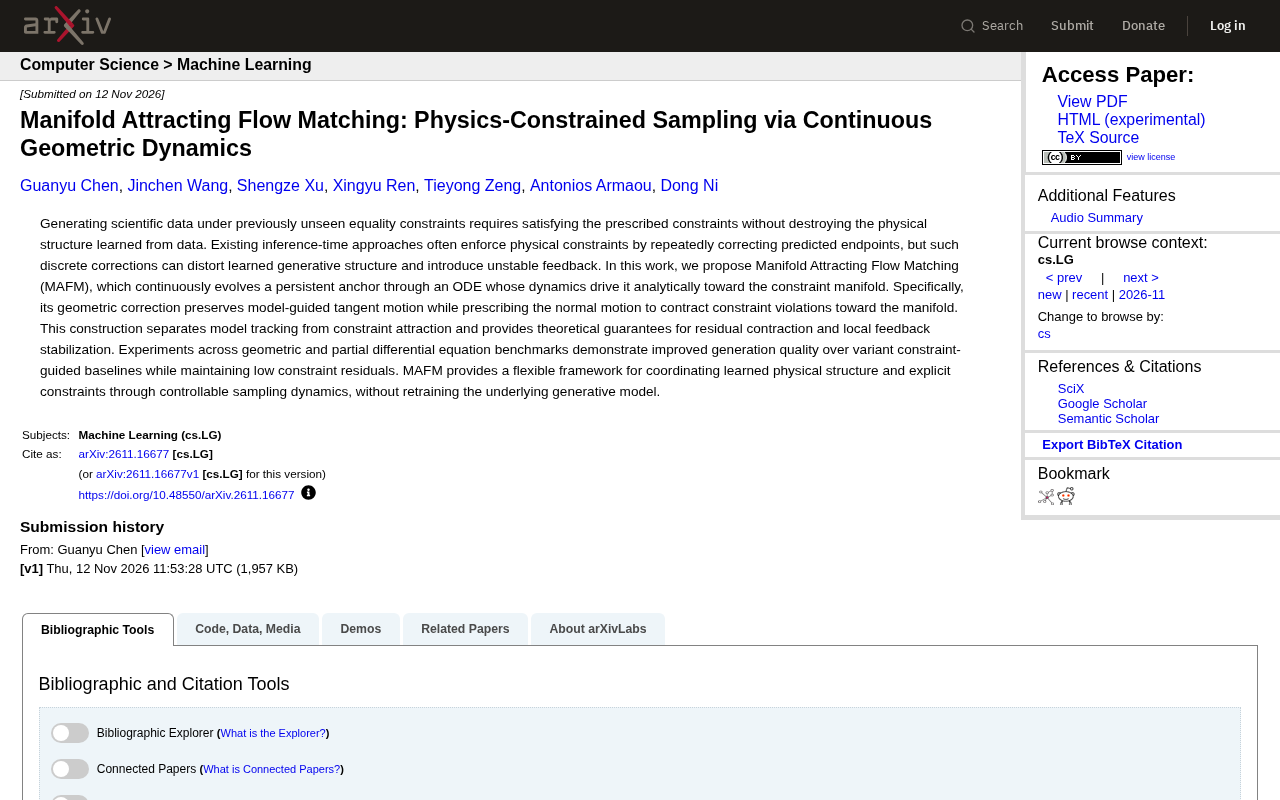
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。