Krea 2 Turbo风格参考LoRA:一张图片定义生成风格

风格迁移新工具:一张图片即可定义输出画风
在AI图像生成领域,如何精准控制输出图像的视觉风格,始终是创作者关注的核心问题。知名开发者ostris近日在Hugging Face上发布了 Krea 2 Turbo Style Reference LoRA,为这一难题提供了一个轻量且实用的解决方案。这款工具允许用户在Krea 2 Turbo模型上,直接以任意一张或多张参考图像的风格来生成全新图像。
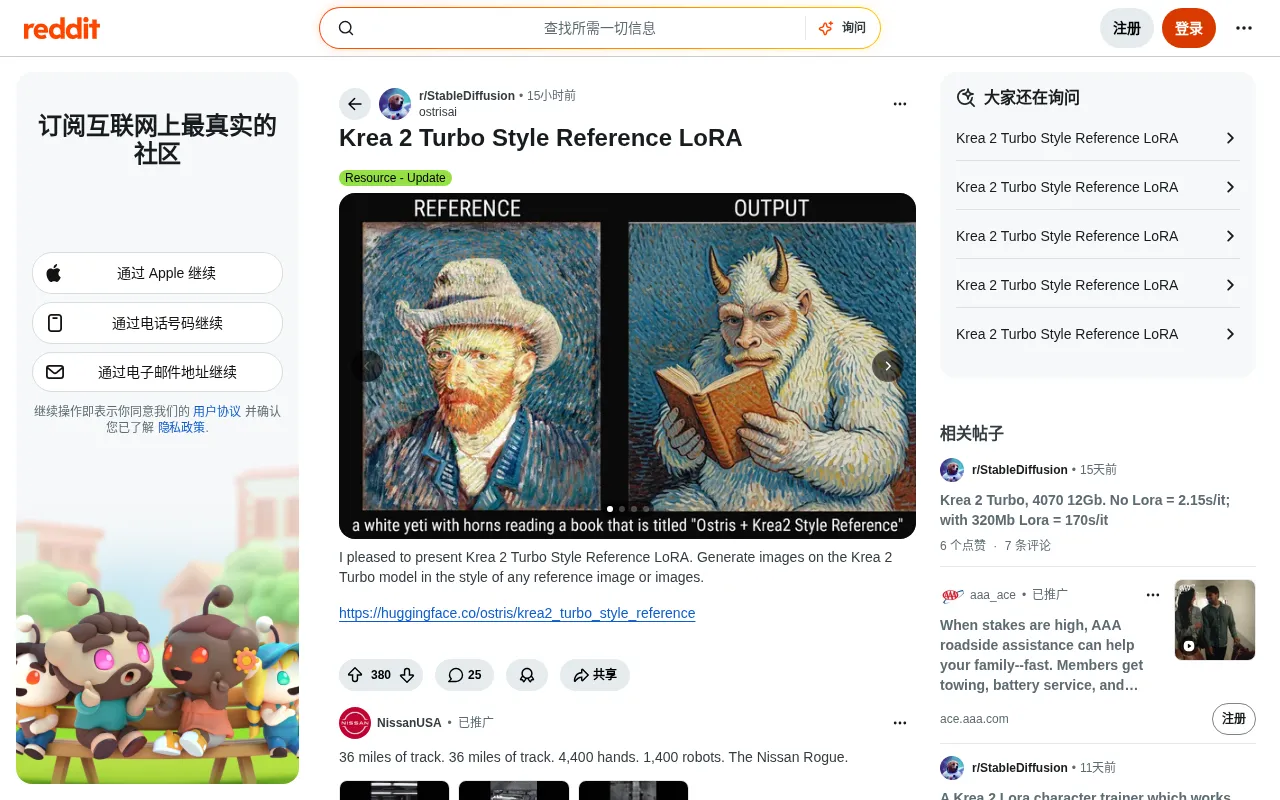
据Reddit社区的发布信息,该LoRA的核心能力在于「风格参考」(Style Reference)——只需提供一张具有特定美学特征的参考图,模型便能捕捉其风格特点,并将其迁移到全新的生成内容中。这种能力对于追求视觉一致性的创作者而言,具有相当强的实用吸引力。
什么是Style Reference LoRA
LoRA技术简述
LoRA(Low-Rank Adaptation,低秩适应)是一种轻量级模型微调技术,由微软研究院于2021年在论文《LoRA: Low-Rank Adaptation of Large Language Models》中首次提出,最初用于大型语言模型的高效微调。其核心思想源于一个重要观察:预训练大模型在适配下游任务时,权重更新矩阵本质上是「低秩」的,可以用两个远小于原矩阵的矩阵之积来近似表达。具体而言,LoRA将原本需要更新的权重矩阵W分解为W + ΔW,其中ΔW = A×B,A和B是秩远低于W的小矩阵。这意味着需要训练的参数量可缩减至原来的万分之一甚至更少。
这一低秩假设并非凭空而来,而是有坚实的线性代数基础支撑。在大型预训练模型中,权重矩阵往往具有极高维度(如2048×2048),但研究者发现,当模型适配特定下游任务时,实际发生有效变化的「自由度」远低于矩阵的完整维度。通过奇异值分解(SVD)分析微调前后的权重差异矩阵,可以观察到绝大多数奇异值接近于零,证实了这一假设的合理性。直观来理解,SVD将任意矩阵分解为若干「方向-强度」对的叠加:奇异值代表每个方向的重要程度,而绝大多数方向的重要程度趋近于零,意味着真正有信息量的变化集中在极少数主方向上。LoRA用秩r(通常为4到64)的两个小矩阵A(d×r)和B(r×k)来近似原本d×k的更新矩阵,参数量从d×k压缩至r×(d+k),当r远小于d和k时,压缩比极为可观。值得注意的是,LoRA还引入了缩放系数α/r来控制更新幅度,避免低秩矩阵在初始化阶段对原始权重造成过大扰动,这一设计细节对训练稳定性至关重要。
相比对整个大模型重新训练,LoRA只需训练极少量参数,便能让基础模型习得特定能力或风格。这一技术随后被图像生成社区广泛采用,Stable Diffusion社区将其发扬光大,创作者可用消费级显卡在数小时内完成风格微调,生成的LoRA文件通常仅数十至数百MB,极易分发和复用。值得一提的是,图像生成领域的LoRA通常作用于U-Net或Transformer骨干网络中的注意力层(Query、Key、Value投影矩阵),而非所有权重层,这是因为注意力机制负责建立图像不同区域与文本条件之间的语义关联,是风格信息传递的关键通道。
Krea 2 Turbo Style Reference LoRA并非训练某种固定艺术风格,而是训练了模型「读取并模仿参考图风格」的通用能力。这是它与传统风格LoRA的关键区别——传统风格LoRA往往锁定在某一画风(如水彩、赛博朋克),而这款工具追求的是「风格泛化」,让参考图本身来决定输出方向。
这种「风格泛化」能力,也折射出AI风格迁移技术整体演进的脉络。早在2015年,Gatys等人发表的论文《A Neural Algorithm of Artistic Style》奠定了早期技术基础——通过卷积神经网络(CNN)分离图像的内容表示与风格表示,其核心数学工具是Gram矩阵:将CNN不同层提取的特征图展平后计算自相关矩阵,Gram矩阵的值反映的是不同特征通道之间的共现关系,与空间位置无关,因此天然编码了纹理和风格信息而非具体内容。风格迁移通过梯度下降优化一张输出图像,使其内容层特征接近内容图,同时Gram矩阵接近风格图,但彼时每张图处理需数分钟乃至数小时,且每个网络只能表达一种固定风格。扩散模型时代的到来彻底改变了这一格局:在以FLUX等现代架构为代表的扩散模型体系下,风格信息的编码方式与CNN时代有本质区别。这类模型依赖Transformer架构的交叉注意力机制(Cross-Attention),文本提示通过CLIP或T5等文本编码器转化为语义向量,与视觉特征在注意力层中融合。风格参考LoRA的技术核心在于:训练模型学会将参考图像的视觉特征——色调分布、笔触纹理、构图规律、光影习惯——编码为可注入生成过程的条件信号,本质上是在拓展模型的「条件输入空间」。这与IP-Adapter等技术路径有相似之处:IP-Adapter通过在交叉注意力层添加独立的图像提示分支,使图像条件与文本条件并行注入,其优势在于训练参数量极少(仅约2200万)且与基础模型解耦,切换不同风格只需更换图像编码器的输出。但LoRA方案的优势在于权重直接融入模型,推理时无需额外的图像编码器前向计算,部署成本更低,且在面向特定基础模型深度定制时,通常能获得更紧密的风格耦合效果。当前的「风格泛化LoRA」正是这一演进链条上的最新形态。
与Krea 2 Turbo的结合
Krea 2 Turbo是一个主打生成速度的图像模型,「Turbo」命名在AI图像生成领域通常指代经过推理加速优化的模型变体。这类优化背后涉及多种技术路径:其一是知识蒸馏(Knowledge Distillation),将大型教师模型的能力压缩至更小的学生模型;其二是减步采样技术,标准扩散模型通常需要20-50个去噪步骤,而Turbo类模型通过一致性模型(Consistency Models)或对抗训练等方法,将步骤压缩至1-8步;SDXL Turbo、FLUX Schnell等均是这类加速模型的代表,单次生成时间可从数十秒压缩至数秒以内。
理解「Turbo」的加速原理有助于评估这类工具的能力边界。一致性模型(Consistency Models)由OpenAI研究员宋飏(Yang Song)于2023年提出,其核心思想是:在扩散过程的同一条去噪轨迹上,所有时间步的输入都应映射到同一个干净图像,即「轨迹一致性」。通过训练模型满足这一自洽约束,使其能够在单步或少步推理中直接跳至终点。具体训练时,一致性模型需要最小化同一轨迹上相邻时间步输出的距离(一致性损失),从而使模型在任意噪声水平下都能「直达终点」。在此基础上发展出的「潜在一致性模型(LCM)」进一步与潜在扩散模型结合,实现了4步生成高质量图像的能力。另一类代表性方案是对抗性扩散蒸馏(ADD,Adversarial Diffusion Distillation),引入判别器网络来监督少步生成结果的真实感,SDXL Turbo即采用此方案。两种路径各有侧重:一致性模型更注重数学上的自洽性和训练稳定性,ADD则借助对抗训练提升感知质量上限,但对抗训练本身存在模式崩溃等训练不稳定风险,调参难度相对更高。此外需要注意的是,减步优化通常以牺牲一定的细节多样性为代价——步数越少,随机采样的探索空间越窄,这也是Turbo类模型在某些高度细节化场景下效果不如标准模型的原因。
将风格参考能力附加到高速模型之上,意味着创作者可以在快速迭代的同时享受可控的风格输出。「速度 + 可控性」的组合,正是当下AI创作工作流的核心需求。
核心能力与应用场景
单图与多图参考
该LoRA支持「任意一张或多张参考图像」的风格提取,这一设计细节值得关注:
- 单图参考:适合有明确风格样板的场景,例如复制某位插画师的作品风格。
- 多图参考:通过融合多张参考图的风格特征,可创造出更具复合感的视觉效果,避免过度依赖单一样本导致的风格僵化。多图参考在技术层面通常通过对多张参考图的特征向量进行加权平均或注意力聚合来实现,不同参考图的权重可以根据其与目标提示的语义相关性动态调整,这也是判断一款风格参考工具成熟度的重要指标之一。
潜在应用方向
这类AI风格迁移工具在实际创作中的用途相当广泛:
- 品牌视觉一致性:企业或设计师可以用一张品牌基调图,批量生成风格统一的营销素材。
- 系列作品创作:漫画、游戏美术等需要整体画风统一的项目,可借助参考图确保输出连贯。
- 快速风格探索:设计师在概念阶段,可用不同参考图快速试验多种视觉方向,大幅缩短前期探索时间。
- 个人化创作助手:独立创作者可将自己的历史作品作为参考图,训练一套专属于自己美学习惯的个人风格标签,在后续创作中保持个人化的视觉语言延续性。
开源生态的价值
该项目托管于Hugging Face平台,作为开源资源向社区开放。Hugging Face成立于2016年,最初定位为聊天机器人公司,2018年转型为AI模型托管与协作平台后迅速崛起,目前已成为全球最大的开源AI模型与数据集社区,托管超过50万个模型和10万个数据集。其Model Hub采用类似GitHub的版本控制机制,支持模型的公开发布、版本管理与社区讨论。
Hugging Face的技术影响力很大程度上也源于其Diffusers开源库——这是一套专为扩散模型设计的推理与训练框架,提供了统一的Pipeline抽象,使不同架构的模型(SDXL、FLUX、Stable Diffusion 3等)能以近乎一致的调用接口运行。对于LoRA的加载,Diffusers提供了load_lora_weights()等标准化方法,支持动态调整LoRA的权重系数(scale),允许创作者在0到1乃至更高的范围内控制风格迁移的强度——scale低于1时风格影响减弱、内容自由度上升,高于1时风格特征被过度放大,可能出现伪影,这一参数的精细调控往往是获得理想输出的关键所在。Hugging Face还维护着PEFT(Parameter-Efficient Fine-Tuning)库,将LoRA、Prefix Tuning、Prompt Tuning、IA³等多种高效微调方法统一在同一框架下,极大降低了社区开发和复用新LoRA的技术门槛。PEFT库的另一重要贡献在于支持「LoRA组合」——多个LoRA权重可以通过线性叠加的方式同时激活,例如同时加载一个风格参考LoRA和一个角色特征LoRA,两者的影响可以分别通过scale系数独立调节,为创作者提供了近乎无限的组合空间。这也是为何Hugging Face能成为开源LoRA生态的核心枢纽。
开发者ostris在AI创作工具社区中素有声望,其在该平台上的另一知名贡献是AI Toolkit(ai-toolkit)——一套被社区广泛使用的Flux模型训练框架,这些开源贡献使其在扩散模型社区建立了较高的技术公信力。
开源模式带来的直接好处是:创作者可免费获取并本地部署,无需依赖闭源云服务;社区也能基于此进行二次开发和优化。对于希望掌控创作流程、注重数据隐私的用户而言,本地可运行的开源LoRA,显然比黑箱式在线服务更具吸引力。值得关注的是,开源生态也带来了风格版权方面的争议:当创作者上传他人艺术作品作为风格参考时,生成结果的版权归属与道德边界仍是行业悬而未决的议题,这一问题随着风格迁移工具的普及而变得愈发迫切。
理性看待与使用建议
尽管这款工具的能力令人期待,但作为刚发布的社区项目,实际使用时仍需注意以下几点:
- 效果依赖参考图质量:风格提取的效果高度取决于参考图的清晰度和风格辨识度,选图不当会影响最终输出。理想的参考图应具有鲜明的风格特征(如强烈的色彩倾向、独特的线条风格或明显的纹理肌理),而非风格模糊的普通照片。
- 需匹配指定基础模型:该LoRA须搭配Krea 2 Turbo模型使用,请确保本地环境配置正确。LoRA权重与基础模型之间存在严格的架构绑定关系,用于SDXL训练的LoRA无法直接迁移至FLUX等不同架构模型,这是使用前必须确认的技术前提。
- 建议实测验证:目前公开信息主要来自开发者发布说明,具体表现仍需更多社区实测反馈来验证。
- 注意内容版权边界:使用他人已发布作品作为风格参考时,建议关注相关版权法律的最新动态,并遵循平台使用规范。
总结
Krea 2 Turbo Style Reference LoRA是AI图像生成工具向「更可控、更实用」方向演进的一个典型案例。从2015年Gatys等人用Gram矩阵奠定神经风格迁移的理论基础,到2021年LoRA技术将微调成本压缩至消费级可及,再到如今风格泛化LoRA实现「任意图像即风格标签」,技术演进的方向始终指向更低的使用门槛与更高的创作自由度。这款工具将「风格控制」这一创作痛点,转化为轻量、灵活的即插即用方案,显著降低了实现视觉一致性的门槛。
感兴趣的读者可前往其Hugging Face页面进一步了解并下载试用。在AI创作工具快速迭代的当下,持续关注这类开源项目,或许能让你在创作实践中抢占先机。
核心要点
核心要点
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。

Commodore 64经典赛车游戏迎来Driver AI
探索Commodore 64经典赛车游戏《Stunt Car Racer》中的Driver AI实验,了解在资源受限的8位平台上实现自动驾驶AI的技术挑战与启示。

黄仁勋若被替换,开源AI会否生变?Reddit激辩
Reddit网友激辩:如果黄仁勋被替换,英伟达会反对开源AI吗?讨论指出英伟达支持开源AI源于商业利益,需拓宽GPU客户群,而非一人决策。