跨语言概念子空间:读取、迁移与擦除的实证研究

孟加拉语习语研究表明跨语言概念共享是估计器敏感的,读取、迁移与擦除需分开评估。
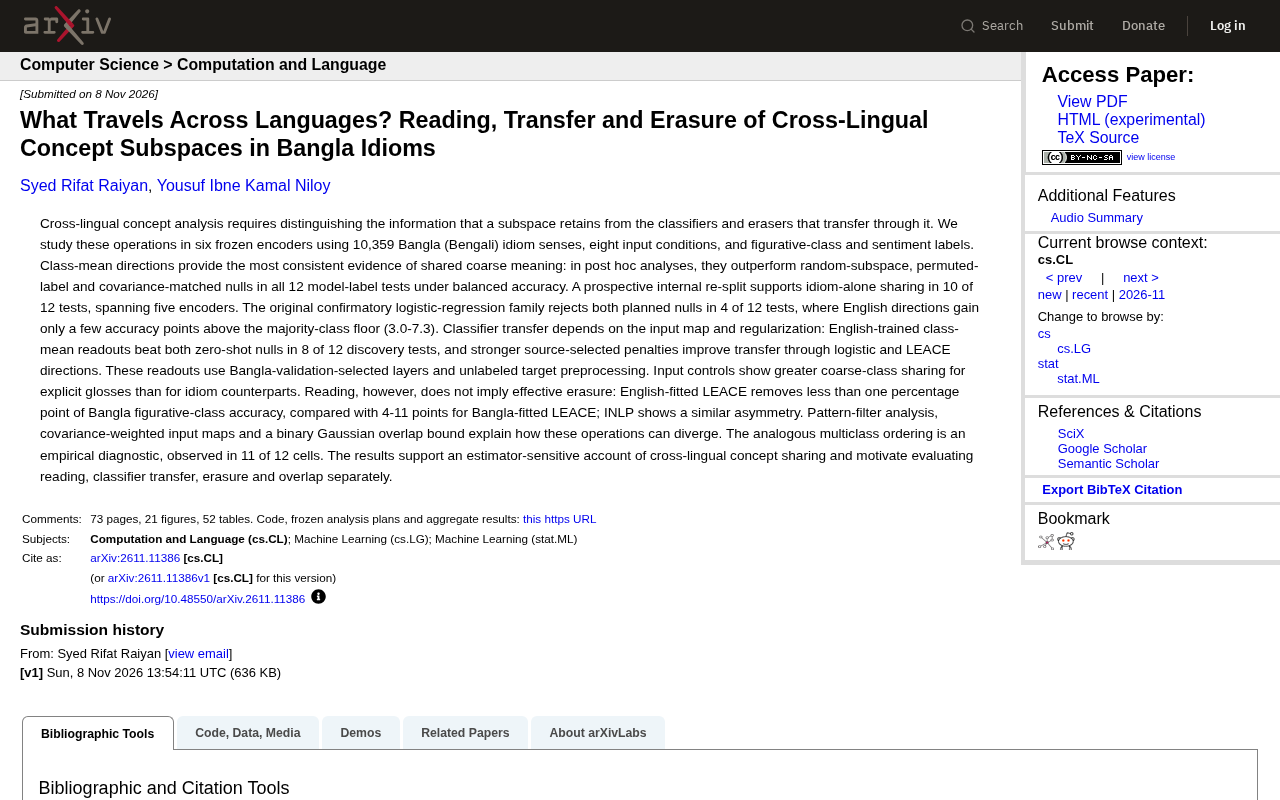
一项针对孟加拉语习语的研究使用六个冻结编码器、10,359条习语义项和八种输入条件,系统检验跨语言概念子空间的读取、迁移与擦除。研究发现,类别均值方向提供了最一致的粗粒度共享证据,在全部12个模型-标签测试中优于多种零假设;英语训练的类别均值读出器在12个发现测试中有8个优于零样本基线,迁移依赖输入映射和正则化强度。然而,读取不等于擦除:英语拟合的LEACE仅移除不到1个百分点的孟加拉语比喻类别准确率,而孟加拉语拟合的LEACE移除4-11个百分点,INLP也表现出类似不对称性。研究支持估计器敏感的跨语言概念共享解释,主张将读取、迁移、擦除和重叠分开评估。
跨语言概念分析往往假设不同语言共享某种语义子空间,但一项针对孟加拉语习语的研究揭示,这种共享是“估计器敏感”的——子空间能否被读取、分类器能否迁移、概念能否被擦除,是三件不同的事。该研究用六个冻结编码器、10,359条孟加拉语习语义项和八种输入条件,系统检验了跨语言概念子空间的读取、迁移与擦除。
研究设计与核心发现
研究聚焦孟加拉语习语,因为习语的意义往往无法从字面推导,是检验跨语言概念共享的理想探针。作者使用六个冻结编码器,在八种输入条件下提取表示,并用比喻类别和情感标签进行评估。
核心结论是:类别均值方向提供了最一致的粗粒度共享证据。在后验分析中,类别均值方向在全部12个模型-标签测试中,以平衡准确率优于随机子空间、标签置换和协方差匹配的零假设。一项前瞻性内部重划分在12个测试中的10个支持习语单独共享,覆盖五个编码器。
这说明,至少对于粗粒度的比喻类别,跨语言信号是存在的。但信号的强度有限:原始验证性逻辑回归家族在12个测试中有4个拒绝了两个计划零假设,其中英语方向仅比多数类基线高出几个百分点(3.0-7.3)。
冻结编码器指在多语言表示研究中,直接使用预训练语言模型(如XLM-R、mBERT等)的中间层输出作为固定特征,不再针对下游任务微调。这样做的好处是排除微调带来的参数更新干扰,使不同语言、不同输入条件下的表示差异完全来自编码器本身和输入映射。研究者通常从多个层提取表示,再在验证集上选择最佳层,以观察跨语言信号在模型内部的分布。冻结策略也便于复现和比较不同编码器,但代价是表示可能未针对目标任务优化。
迁移依赖输入映射与正则化
分类器迁移是另一个维度。研究发现,英语训练的类别均值读出器在12个发现测试中有8个优于两个零样本零假设,而更强的源选择惩罚能通过逻辑回归和LEACE方向改善迁移。这些读出器使用了孟加拉语验证集选择的层和无标签目标预处理。
输入控制还显示,显式注释比习语对应物表现出更强的粗类共享。这意味着,当输入映射更“透明”时,跨语言迁移更容易发生。
LEACE(Least-squares Concept Erasure)是一种线性概念擦除方法,通过寻找一个最小的线性变换,使得目标概念的线性分类器无法从表示中预测该概念,同时尽量保留其他信息。其核心是闭式解,基于类内协方差矩阵的逆,对表示做白化后再投影掉概念方向。LEACE常用于公平性去偏和概念移除。在跨语言场景中,若在源语言上拟合LEACE,再应用到目标语言,擦除效果取决于两种语言表示分布的几何对齐程度,因此可能出现不对称性。
INLP(Iterative Nullspace Projection)是另一种线性概念擦除方法,通过迭代训练线性分类器并投影到其零空间,逐步移除概念信息。与LEACE的一次性闭式解不同,INLP重复“训练分类器—投影”过程,直到分类器无法预测概念。INLP同样假设概念方向线性可分,在跨语言应用中,若源语言和目标语言的概念方向不一致,擦除效果会打折扣。INLP和LEACE都是后处理线性方法,计算高效,但只能移除线性可解码的信息。
读取不等于擦除:不对称性显著
研究最重要的警示在于:读取到概念,不意味着能有效擦除它。英语拟合的LEACE仅移除不到一个百分点的孟加拉语比喻类别准确率,而孟加拉语拟合的LEACE移除4-11个百分点;INLP表现出类似的不对称性。
这种不对称性可以用模式过滤分析、协方差加权输入映射和二元高斯重叠界来解释。换言之,擦除操作的效果高度依赖于拟合语言与目标语言之间的几何关系。
对跨语言表示研究的启示
研究支持一种“估计器敏感”的跨语言概念共享解释,并呼吁将读取、分类器迁移、擦除和重叠分开评估。多类排序作为一种经验诊断,在12个单元中的11个被观察到。
对于从事多语言模型可解释性和公平性研究的实践者,这项工作的启示是直接的:不要假设在一个语言上有效的概念擦除方法能直接迁移到另一个语言。评估跨语言概念操作时,需要分别报告读取精度、迁移性能和擦除效果,而不是将它们混为一谈。
该研究也提示,习语这类非组合性语言现象,可能是检验跨语言概念共享的更严格测试场。未来工作可以扩展到更多语言对和更多概念类别,以检验这种估计器敏感性是否普遍存在。
背景补充
平衡准确率(Balanced Accuracy)是分类评估指标,定义为各类别召回率的算术平均,对类别不平衡不敏感。在跨语言概念分析中,使用平衡准确率可以避免多数类主导,更公平地反映分类器对少数类的识别能力。研究中将其与随机子空间、标签置换和协方差匹配等零假设比较,以判断概念方向是否携带真实的跨语言信号。平衡准确率高于基线几个百分点可能具有统计显著性,但实际效应量有限,需谨慎解读。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。