Lakebase Postgres调优实践:shared buffers提至75% DRAM,吞吐翻倍
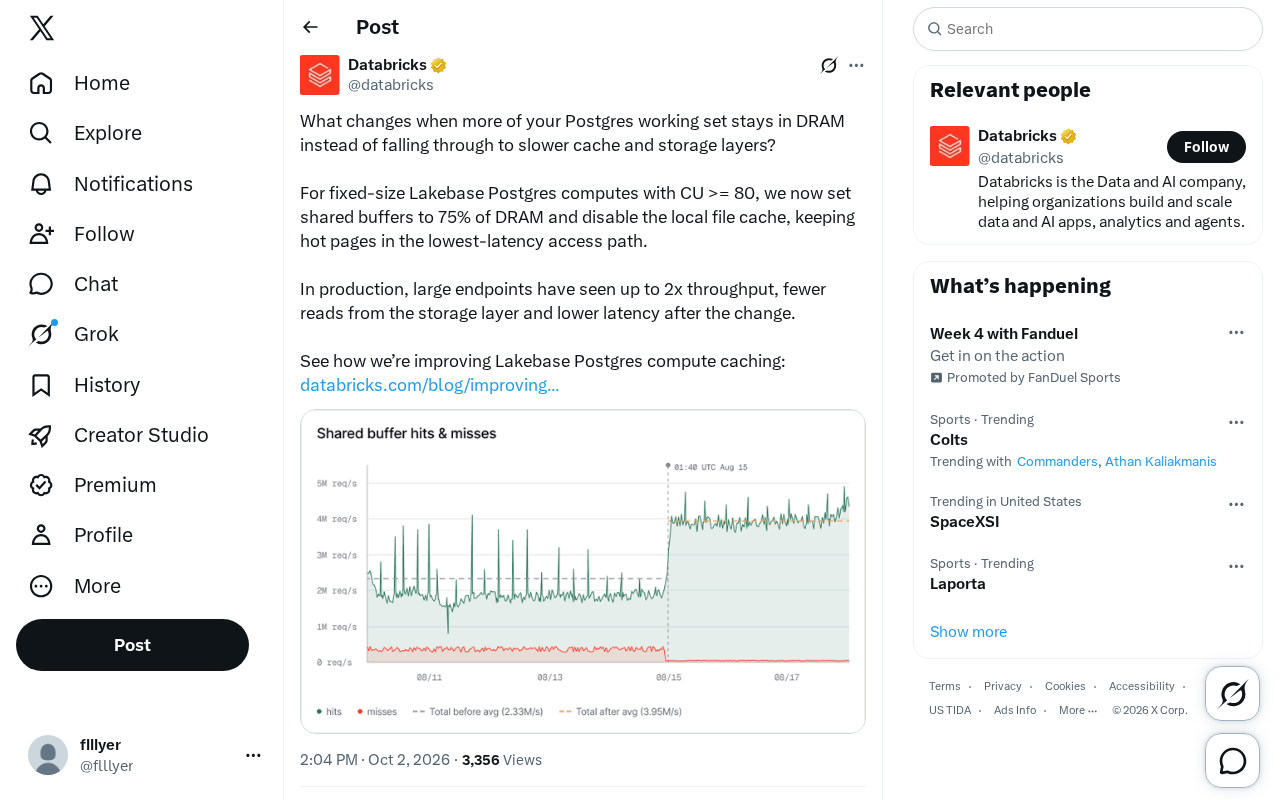
Lakebase将大规格Postgres实例的shared buffers提至DRAM的75%并禁用文件缓存,生产环境吞吐最高提升2倍。
Lakebase近期对CU≥80的固定规格Postgres实例实施了一项缓存策略调整:将shared buffers设为DRAM总量的75%,同时禁用本地文件缓存。这一组合通过消除shared buffers与文件缓存之间的双重缓存问题,将热页面集中保留在延迟最低的DRAM访问路径中,避免数据在两层缓存间重复占用内存。生产环境测试数据显示,大型端点吞吐最高提升2倍,存储层读取次数减少,整体延迟降低。该策略有明确的适用边界:仅适用于内存充裕的大规格实例,且依赖业务工作集能够大部分装入DRAM;禁用文件缓存后未命中shared buffers的请求将直接访问存储层,对命中率有较高要求。这一案例对自管Postgres团队也具有参考意义——在大内存时代,传统保守的shared buffers配置经验值得重新审视。
一次缓存策略调整带来的性能跃升
数据库性能优化的核心命题之一,是让热数据尽可能停留在延迟最低的访问路径上。当更多的Postgres工作集能够常驻DRAM,而不是跌落到更慢的缓存层或存储层时,整个系统的响应特性会发生显著变化。
Lakebase团队近期公布了一项针对Postgres计算资源的缓存调优措施:对于固定规格、CU(Compute Unit)大于等于80的实例,将shared buffers设置为DRAM总量的75%,同时禁用本地文件缓存(local file cache),把热页面(hot pages)保留在延迟最低的访问链路中。
为什么是75%与禁用文件缓存
Postgres的内存访问存在明显的层级结构:从DRAM中的shared buffers,到操作系统的文件缓存,再到底层存储层,每一级的延迟逐级升高。传统配置下,shared buffers往往设置得较为保守(经典建议是25%左右),把大量内存留给操作系统的页缓存去管理。
Lakebase的做法反其道而行:在大规格实例上,直接把shared buffers拉高到75%,并关闭本地文件缓存。这一组合的逻辑在于——对于内存充裕的大型计算节点,与其让数据在shared buffers和文件缓存之间形成"双重缓存"(double buffering)带来重复占用与额外拷贝开销,不如让Postgres自身的缓冲池直接掌控更多热数据,减少不必要的中间层。
双重缓存问题的消解
当shared buffers和OS文件缓存同时缓存相同的数据页时,内存被重复利用,实际有效缓存容量被稀释。禁用本地文件缓存后,内存几乎全部交给Postgres的缓冲池统一调度,热页面命中率更高,从存储层读取数据的次数随之下降。
shared_buffers 是 Postgres 最重要的内存参数之一,直接决定数据库进程自身能够缓存多少数据页。Postgres 官方文档长期以来建议将其设置为系统内存的 25% 左右,这一保守值的历史背景在于:早期服务器内存有限,且 Postgres 需要与同机其他进程共享内存,OS 页缓存(Page Cache)能够以较低代价利用剩余内存完成"二次缓存"的职责。然而,OS 页缓存对 Postgres 而言是透明且不可控的——Postgres 无法精确知道哪些页面被操作系统缓存、何时被驱逐,缓存决策权分散在两个独立的子系统中。随着云原生数据库节点动辄拥有数百 GB 内存,25% 的上限往往意味着数百 GB 内存被留给 OS 管理,而实际业务工作集完全可以装入 Postgres 自己的缓冲池——此时坚守保守比例反而是对资源的浪费。
双重缓存(Double Buffering)问题在 Postgres 生态中由来已久。当一个数据页从存储层读入时,它会先经过 OS 内核的页缓存落入物理内存,再被 Postgres 进程读取后复制到 shared buffers——同一份数据在内存中存在两份副本。对于大量顺序扫描场景,Postgres 会主动通过 fadvise(POSIX_FADV_DONTNEED) 提示内核丢弃页缓存以缓解这一问题,但随机读工作负载下这种自动清理难以奏效,双重占用依然存在。Lakebase 所采用的"本地文件缓存(local file cache)"是其云原生存储架构中位于 shared buffers 与远程对象存储之间的一层本地 SSD/内存缓存,并非标准 Postgres 的 OS 页缓存,但其与 shared buffers 并存时同样会引发类似的重复缓存问题。禁用该层后,热页面的唯一驻留位置变为 shared buffers,缓存决策集中化,有效容量得以最大化利用。
生产环境的实测效果
据Lakebase公布的数据,在实际生产环境中,大型端点(large endpoints)在应用该调整后出现了明显改善:
- 吞吐量最高提升达2倍
- 存储层读取次数减少
- 整体延迟降低
这三项指标相互印证——读请求更多地在DRAM内命中,不再频繁下沉到存储层,既减少了I/O压力,也缩短了响应时间,吞吐自然随之上扬。对于读密集、工作集可以大部分装入内存的负载,这种收益尤为显著。
适用边界与权衡
这项优化并非对所有场景无差别生效,其适用条件值得关注:
限定于CU≥80的固定规格实例。只有在内存足够大的节点上,把75%的DRAM交给shared buffers才不会挤压其他进程的内存需求。小规格实例若照搬此配置,反而可能因内存不足导致不稳定。
依赖工作集能够驻留内存。该策略的收益建立在"热数据大部分能装进DRAM"这一前提上。如果工作集远大于可用内存,热页面仍会被频繁换出,提升幅度将受限。
禁用文件缓存的取舍。关闭OS层缓存消除了双重缓存的浪费,但也意味着一旦数据未命中shared buffers,就直接走存储层,少了一道中间缓冲。这要求shared buffers的命中率足够高,否则可能放大未命中的代价。
CU(Compute Unit)是 Lakebase 及多数云数据库平台用于量化计算资源的抽象单位,通常包含固定比例的 vCPU 与内存。CU≥80 在 Lakebase 的规格体系中对应内存达到数百 GB 量级的大型实例。之所以以此为阈值,是因为在较小实例上将 75% 内存划给 shared buffers 会严重压缩操作系统自身的可用内存,进而影响网络栈、文件描述符管理、后台进程等系统级操作,甚至触发 OOM(Out-Of-Memory)杀进程。工作集(Working Set)是指在一段时间窗口内被频繁访问的数据页集合,其大小直接决定缓存命中率的上限——若工作集体积超过 shared buffers 容量,再大的缓冲池也无法避免频繁的页面换入换出(Buffer Eviction),此时提升 shared buffers 比例的边际收益会急剧递减。
对数据库运维的启示
这则调优案例对自建或自管Postgres的团队同样有参考价值。随着云上计算节点内存规格不断增大,过去那套"shared buffers保守配置、依赖OS页缓存"的经验法则,在大内存场景下未必最优。
核心思路可以概括为:在内存充裕时,减少缓存层级、让数据库自身掌控更多热数据,往往比依赖多层缓存更高效。当然,任何配置调整都应结合自身负载特征进行压测验证,Lakebase的2倍吞吐是其特定工作负载下的结果,不应直接套用为通用预期。
对于托管服务用户而言,这类由平台方自动应用的底层优化,意味着无需手动调参即可获得性能红利——这也是托管数据库相较自建的价值体现之一。
相关推荐

免费白嫖Gemini 4与Claude Sonnet 5.5?实测Free.pi教程
实测Free.pi平台免费调用Gemini 4 Argon与Claude Sonnet 5.5的完整流程,包括CLI安装、GitHub登录获取每日15000积分、模型切换与代码任务测试,并分析免费通道的潜在限制。

Microduck:用Rust打造的双足机器鸭,GitHub一日斩获421星
Pollen Robotics开源项目microduck:一个用Rust编写的微型双足机器鸭,GitHub单日新增421星,总星数超1万。本文解析其技术栈、双足行走控制原理及对机器人学习者的价值。

2.2万Star的电子书宝库:一个GitHub仓库如何聚合四大读书App资源
GitHub项目ebook-treasure-chest获2.2万Star,聚合帆书、微信读书、京东读书、喜马拉雅等读书App电子书下载链接。本文分析其价值、链接失效风险与版权边界,探讨资源聚合类开源项目的可持续性。