LangGraph生产环境三大隐患:CVE漏洞、85%存储膨胀与静默循环
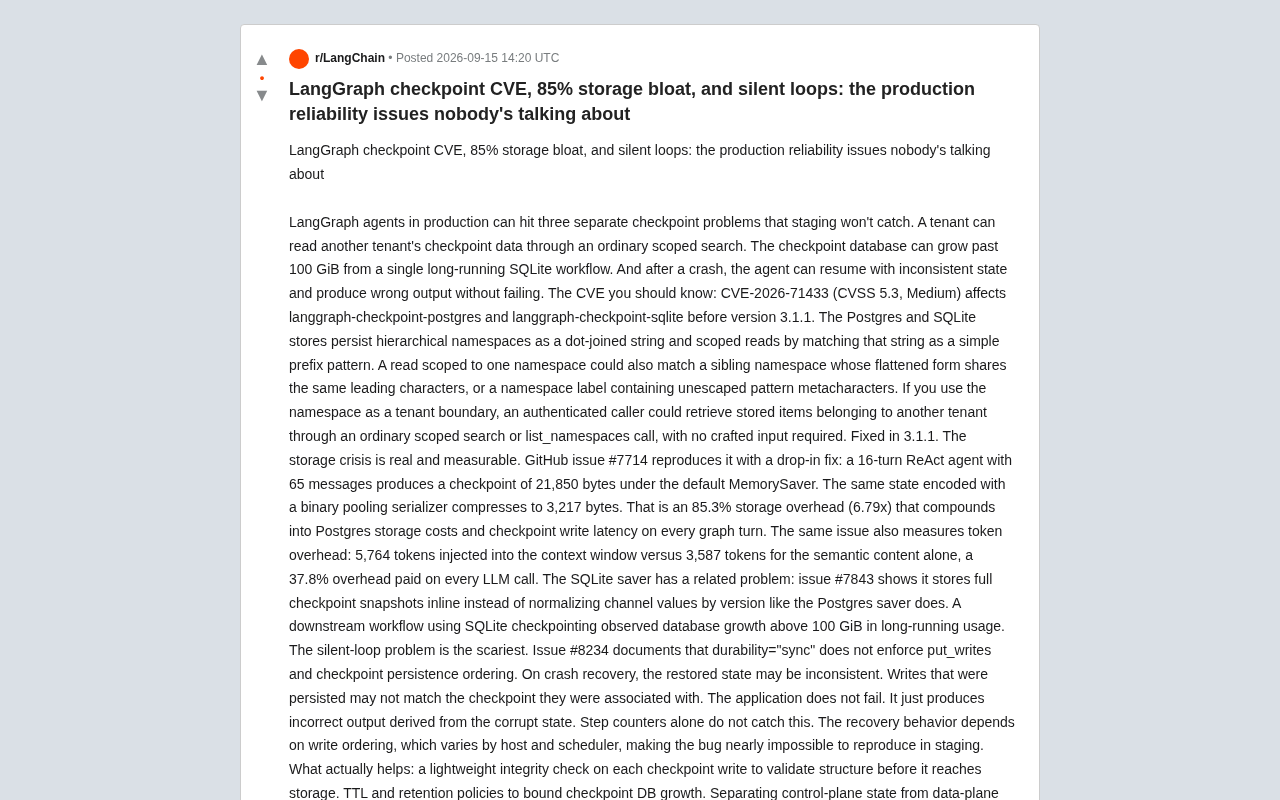
LangGraph生产环境存在越权读取漏洞、85%存储膨胀及崩溃后静默错误状态三类隐患
本文揭示了LangGraph智能体在生产环境中潜藏的三类严重问题。其一是CVE-2026-71433安全漏洞(CVSS 5.3),3.1.1之前版本的Postgres/SQLite存储因命名空间前缀匹配缺陷,可导致已认证调用方跨租户越权读取数据,多租户SaaS架构尤其危险,已在3.1.1版本修复。其二是存储膨胀问题,默认MemorySaver采用全量JSON快照,16轮对话即产生85.3%的冗余存储开销(约6.79倍),同时带来37.8%的额外token消耗;SQLite saver更因不做版本归一化而在长期运行中导致数据库突破100 GiB。其三是最隐蔽的静默循环问题:`durability=sync` 未强制写入顺序,崩溃恢复后系统可能基于不一致状态安静输出错误结果,且不抛出任何异常。应对措施包括升级至3.1.1、使用二进制池化序列化器、配置TTL保留策略、分离控制与数据平面,以及将数据库增长率纳入监控指标。
在测试环境跑得好好的LangGraph智能体,一旦上线可能遭遇三类难以察觉的checkpoint问题:租户数据越权读取、单个长期运行的工作流让数据库膨胀到100 GiB以上、崩溃恢复后带着不一致状态继续输出错误结果却不报错。这些问题在staging阶段几乎无法复现,却在真实负载下悄然发酵。
CVE-2026-71433:命名空间前缀匹配导致的越权读取
这个漏洞编号为CVE-2026-71433,CVSS评分5.3(中危),影响3.1.1之前版本的langgraph-checkpoint-postgres和langgraph-checkpoint-sqlite。
问题根源在于存储层对层级命名空间的处理方式。Postgres和SQLite存储将层级命名空间持久化为「点号连接的字符串」,而范围读取时是把这个字符串当作简单前缀模式来匹配的。这就埋下两个隐患:一是某个命名空间的扁平化形式,可能与另一个共享相同起始字符的兄弟命名空间发生误匹配;二是命名空间标签中若含有未转义的模式元字符,会导致匹配范围失控。
如果你把命名空间当作租户边界来使用,那么一个已认证的调用方,仅仅通过一次普通的范围搜索或list_namespaces调用,无需任何精心构造的输入,就有可能读取到属于其他租户的存储数据。对于多租户SaaS架构而言,这是典型的横向越权。该问题已在3.1.1版本修复,升级是目前唯一的解法。
在LangGraph的多租户部署模式中,开发者通常用命名空间(namespace)来隔离不同租户的智能体状态,例如将 tenant_a.workflow 和 tenant_b.workflow 分配给不同的客户。前缀匹配的根本缺陷在于:当存储层执行 WHERE namespace LIKE 'tenant_a%' 这类查询时,若 tenant_a2 这样的兄弟命名空间存在,它也会被误匹配并返回。模式元字符问题同样危险——若租户ID中包含 _(在SQL LIKE语法中匹配任意单字符)或 %(匹配任意长度字符串),未经转义时查询边界会完全失控。3.1.1的修复方案通常是将命名空间切换为精确的数组列类型匹配,或在构造查询前对元字符进行强制转义,彻底消除前缀语义歧义。
85%的存储膨胀:checkpoint序列化的隐性成本
第二个问题不是安全漏洞,而是实打实、可测量的成本问题。GitHub issue #7714给出了一个可复现的案例并附带了修复方案。
数据很直观:一个16轮、包含65条消息的ReAct智能体,在默认的MemorySaver下产生的checkpoint大小为21,850字节;而同样的状态用二进制池化序列化器编码后,压缩到了3,217字节。这意味着默认方案带来了85.3%的存储开销(约6.79倍)。
这个开销不是一次性的。它会在每一次graph turn上累积,直接推高Postgres的存储费用和checkpoint写入延迟。更值得警惕的是token层面的浪费:同一issue测算出注入上下文窗口的token达到5,764个,而语义内容本身只需3,587个token——每次LLM调用都要多付37.8%的token开销。在高频调用场景下,这笔账相当可观。
SQLite saver还有一个相关但更严重的毛病。Issue #7843指出,它会内联存储完整的checkpoint快照,而不像Postgres saver那样按版本对channel值做归一化处理。结果就是,一个使用SQLite checkpointing的下游工作流,在长期运行中观察到数据库体积突破了100 GiB。
LangGraph的checkpoint机制本质上是一种「完整状态快照」策略:每次graph执行到节点边界时,框架会将当前完整的状态图序列化并持久化,以便在崩溃后从任意中间步骤恢复。默认的 MemorySaver 使用JSON序列化,对消息列表、工具调用结果等结构体进行逐字段序列化,不做去重或增量压缩。随着对话轮次增加,状态中的 messages 数组会线性增长,而每个checkpoint都包含全量历史,这是造成存储膨胀的根本原因。「二进制池化序列化器」通过将重复出现的子结构(如相同的系统提示、工具定义)提取到共享对象池中并以引用代替内联,可大幅缩减序列化体积,在对话轮次越多时效益越显著。Postgres saver的「按版本归一化channel值」也是类似思路——只存储变更的channel,而非每次都写入全量快照。
静默循环:崩溃恢复后的状态不一致
三个问题里最可怕的是静默循环,它记录在issue #8234中。
核心问题是:durability="sync"并没有强制保证put_writes与checkpoint持久化之间的顺序。当发生崩溃恢复时,被恢复的状态可能是不一致的——那些已经持久化的写入,未必与它们所关联的checkpoint相匹配。
最棘手的是它的失败方式:应用不会报错。它只是基于被污染的状态,安静地产出错误的输出。仅靠step计数器根本发现不了这类问题。而恢复行为又依赖于写入顺序,这个顺序会随宿主机和调度器的不同而变化,导致该bug在staging环境中几乎无法复现。这正是「生产环境专属灾难」的典型特征——你只有在真实崩溃发生后,才会意识到状态早已悄然错位。
durability="sync" 在直觉上意味着「写入后立即落盘、调用方确认后才继续」,开发者往往据此假设checkpoint的持久化顺序与写入操作一一对应。然而该配置实际上只保证单次写入本身的持久性,并不约束多个写入操作之间的全局顺序。LangGraph在一次turn中可能产生多个 put_writes 调用(记录节点输出)和一次 put_checkpoint 调用(快照完整状态),这两类操作在底层可能经由不同的异步路径落库。当进程在两者之间崩溃时,恢复逻辑若以checkpoint为基准,就会丢失已写入的node outputs;若以最新writes为基准,则会在没有对应checkpoint的情况下重放,均可导致状态语义错误。由于这类时序竞争依赖于具体的操作系统调度、数据库连接池状态和崩溃时机,在受控的staging环境中几乎无法稳定复现。
生产环境的实用应对策略
针对上述三类问题,原帖给出了几条切实有效的工程实践:
- 写入前的轻量完整性校验:在每次checkpoint写入前验证其结构,确保数据到达存储层之前是完整可信的,可有效防范静默循环。
- TTL与保留策略:为checkpoint数据库设置过期和保留规则,主动约束数据库增长,避免无限膨胀。
- 分离控制平面与数据平面状态:把两类状态拆开,防止臃肿的checkpoint拖慢热路径的处理速度。
- 将checkpoint数据库增长率作为生产指标监控:不要只盯着查询延迟,增长率本身就是一个关键的健康信号。
这些措施看似简单,却直指LangGraph在生产落地中最容易被忽视的盲区。安全升级到3.1.1解决越权问题,序列化优化和SQLite归一化缓解存储压力,而完整性校验则是应对静默状态损坏的最后防线。对于正在或计划将LangGraph智能体推向生产的团队来说,这三类问题都值得提前排查。
相关推荐
Python接单实战:接单平台选择与报价避坑指南
Python接单副业实战经验分享:闲鱼、淘宝、BOSS直聘三大接单平台对比,100元到10K不同单价梯度的技术要求与报价逻辑,以及新手应具备的爬虫、数据处理技能。同时理性剖析高收入宣传背后的真实门槛与避坑要点。
AI Agent是什么?从聊天机器人到数字员工的落地逻辑
AI Agent是什么?它是能替人干活的数字员工,能读数据、调接口、拆任务、自我纠错。本文解析Agent与聊天机器人的区别、客服/财务/运营等企业落地场景,以及为什么「能落地」的人才最稀缺。
OpenAI对Cursor断供内幕:SpaceX收购引发的模型战争
OpenAI宣布终止与Cursor合作,将于11月12日切断模型访问。本文深度解析SpaceX收购Cursor引发断供的真正原因——模型蒸馏、数据争夺与即将发布的Astra,以及开发者的应对方案。