LangGraph生产实战:从服务拆分到人类介入的七条经验

生产级AI系统的踩坑教训:服务拆分、契约、护栏与人工审核的故障模式。
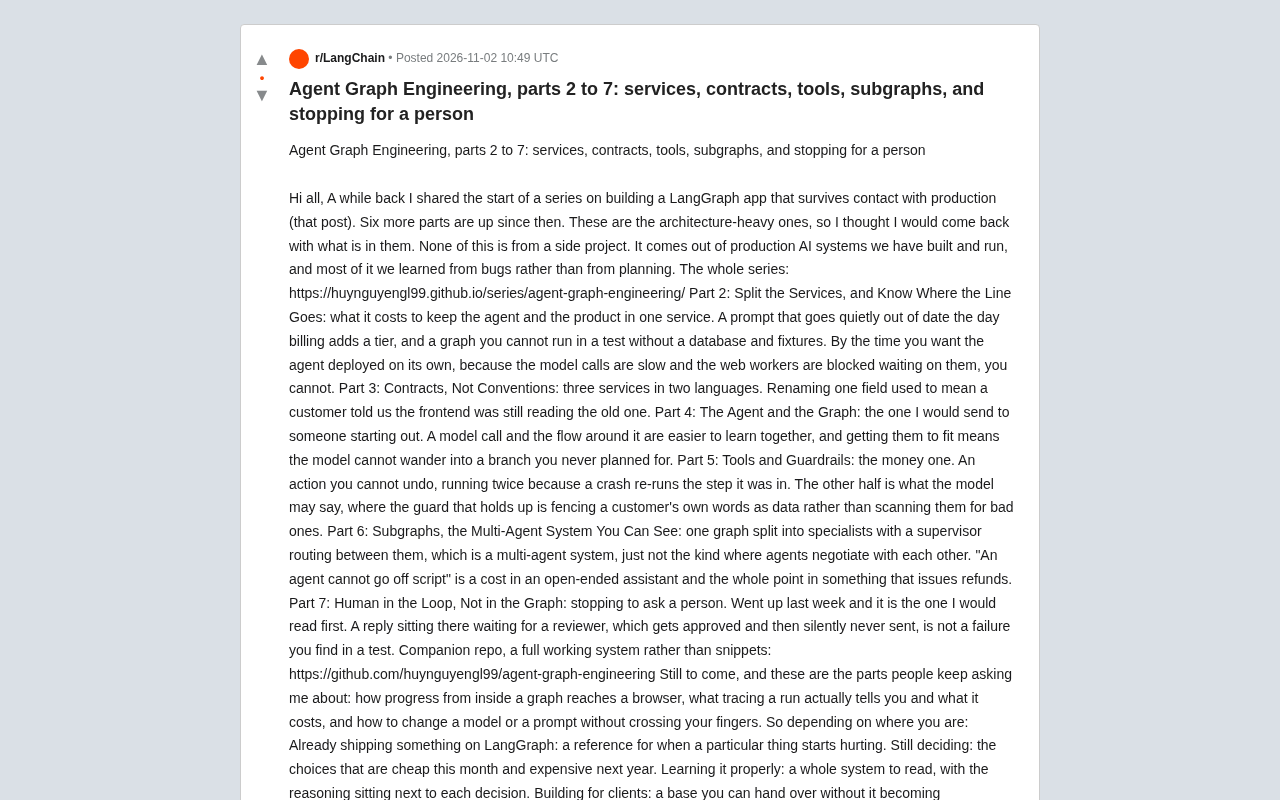
本文基于Reddit系列文章《Agent Graph Engineering》第2至7部分,总结了生产环境部署LangGraph等Agent框架时的真实教训。核心问题包括:Agent与产品同服务导致测试依赖数据库、模型调用阻塞Web worker且难以拆分;多语言多服务下需显式契约而非口头约定;不可撤销操作在崩溃重跑时可能重复执行,需幂等设计;有效护栏应将客户输入当数据处理而非扫描坏词;人工审核环节自身可能成为故障点,如回复被批准却从未发送。文章强调这些失败模式在测试中难以暴露,但直接对应真实损失,建议团队提前规划边界与防护措施。
很多LangGraph教程教你搭起一个能跑的Demo,但很少有人讲清楚:当这个图真正跑在生产环境、每天面对真实用户和真实账单时,会在哪里出问题。一位开发者在Reddit分享了系列文章《Agent Graph Engineering》的第2到第7部分,内容全部来自团队实际构建和运维的生产级AI系统,且大部分教训是从bug里学来的,而非规划出来的。该系列配有完整的可运行仓库,不是代码片段拼凑。
为什么要把服务和Agent拆开
第2部分的主题是服务边界。作者列举了把Agent和产品塞进同一个服务的真实代价:一个提示词在计费模块新增套餐的那天悄悄过期,而你毫无察觉;一个图想要在测试里跑起来,必须先准备数据库和一堆fixture。更现实的问题是部署——模型调用很慢,Web worker会被阻塞在等待上,等到你终于想把Agent单独部署时,发现已经拆不开了。
这类问题的共同点是:它们在早期不痛,等到痛的时候重构成本已经很高。作者的建议是提前想清楚边界画在哪里,而不是等到阻塞发生再动手。
Web worker 是处理HTTP请求的进程或线程,通常与用户请求生命周期绑定,要求快速响应。模型调用往往涉及外部API,延迟可达数秒甚至数十秒。若Agent与Web服务同进程,Worker会被长时间占用,导致并发能力急剧下降,甚至拖垮整个服务。将Agent拆分为独立服务后,Web worker只需异步转发请求,自身保持轻量,同时Agent服务可以独立扩缩容和部署。
契约比约定更可靠
第3部分讲的是跨服务协作。他们的系统里有三个服务、两种语言,曾经因为重命名一个字段,最后是客户告诉他们前端还在读旧字段。这件事说明口头约定和文档约定在多语言、多服务的环境里撑不住,需要的是显式的契约。
对正在做多服务Agent架构的团队来说,这个教训很直接:字段变更不是改个名字那么简单,接口契约才是跨团队协作的锚点。
显式契约 指用机器可校验的接口描述(如OpenAPI、Protobuf、JSON Schema)定义服务间的数据格式,而非依赖文档或口头共识。在多语言、多服务环境中,契约文件可作为代码生成和持续集成校验的依据:字段重命名会立即触发构建失败或测试告警,而不是等到客户反馈。契约的核心价值是将跨团队协作的假设显式化、自动化验证,降低沟通成本和线上事故风险。
模型调用与流程图要一起学
第4部分是作者最推荐给初学者的一篇。核心观点是:一次模型调用和它周围的流程,放在一起学更容易理解;而让两者严丝合缝地配合,意味着模型无法游走到你从未规划的分支里。
这其实点出了LangGraph这类框架的价值所在——不是让模型更聪明,而是让模型的行动范围可控。对开放式助手来说这可能是一种限制,但对需要确定性的业务场景来说,这正是想要的效果。
工具与护栏:关于钱的那一课
第5部分被作者称为"关于钱的那一篇"。场景是一个不可撤销的操作,因为崩溃导致所在步骤被重新执行,于是这个操作跑了两次。这类问题在测试里很难暴露,却直接对应真实损失。
护栏的另一半是模型能说什么。作者给出的经验是:真正撑得住的护栏,是把客户自己的话当作数据处理(fencing),而不是去扫描里面有没有坏词。这个思路的转变值得注意——从内容过滤转向数据隔离。
幂等性 指同一操作执行多次对系统状态的影响与执行一次相同。在分布式系统中,崩溃重试、超时重发很常见,若操作非幂等(如扣款、发邮件),重复执行会导致资损或骚扰。实现幂等通常需要唯一请求ID、去重表或状态机。对于不可撤销操作,应在设计时引入幂等键,确保重跑安全。这是在测试中难以暴露但生产环境必须考虑的关键点。
子图:看得见的多Agent系统
第6部分讨论子图。把一个图拆成多个专家节点,再由一个supervisor在它们之间路由,这本身就是一种多Agent系统,只是不是那种Agent之间互相协商的类型。作者对此的判断很务实:"Agent不能偏离脚本"在开放式助手里是成本,但在一个负责退款流程的系统里就是全部意义所在。
换句话说,多Agent不一定要追求自治和协商,受控的编排在很多业务场景里反而是正确选择。
人类介入:最容易漏掉的失败模式
第7部分是最近发布的,也是作者认为最该先读的一篇。场景听起来很简单:一条回复停在那里等待审核,审核通过了,然后它悄无声息地从未被发送出去。
这种失败在测试里找不到。它不属于异常,不属于报错,只是一个本该发生的动作没有发生。把人类放进循环(Human in the Loop)听起来是安全措施,但如果流程设计不当,人工审核环节本身会成为新的故障点。
Human-in-the-Loop (HITL) 指在自动化流程中插入人工审核或决策环节,常用于高风险操作。但HITL本身是一个分布式状态机:待审核、已批准、已拒绝、已发送等状态需要持久化并可靠流转。常见故障包括审核通过后未触发后续动作、状态更新丢失、超时未处理等。设计时需将人工环节视为正式服务,保证状态变更的原子性和可观测性,避免“静默失败”。
系列还有哪些内容
作者提到后续还会覆盖几个被频繁问到的主题:图内部的进度如何传到浏览器、追踪一次运行到底能告诉你什么以及它的成本、以及如何在不靠运气的情况下更换模型或提示词。
整个系列配有完整的工作系统仓库(而非片段),作者也说明了不同读者的切入点:已经在用LangGraph上线的,可以当作"某个地方开始疼了"时的参考;还在选型的,可以看清哪些选择这个月便宜、明年昂贵;在学习的,有一整套带决策理由的系统可读;做客户交付的,有一个不会变成维护噩梦的基底。
对正在把Agent从Demo推进到生产的团队来说,这套内容的价值在于它记录的是踩坑顺序,而不是理想架构图。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。