李宏毅生成式AI导论:零基础入门大模型的正确路径

拆解台大李宏毅《生成式人工智能导论》的课程定位、内容与自学方法。
本文围绕台大李宏毅的《生成式人工智能导论》展开拆解,指出该课并非教ChatGPT用法,而是讲生成式AI的原理与全貌。课程分基础、进阶、实战三模块,覆盖Transformer、预训练、SFT、RLHF及RAG、Agent、微调部署,作业刻意保留训练耗时与结果不可复现的负面体验。文章还借GPT-2与芙莉莲的类比说明技术迭代之快,并给出三点自学建议:分清会用与理解、把作业当体验、别被「保姆级」误导。
B站上有一门被反复推荐的LLM入门课——台大李宏毅的《生成式人工智能导论》。但围绕它的宣传往往跑偏:标题写着「零基础保姆级」,内容简介却在堆砌RAG、Agent、LangChain等实战名词。这门课到底讲什么、适合谁、该怎么学?结合课程原始内容和B站UP主的整合版本,本文做一次拆解。
这门课不教「怎么用ChatGPT」
李宏毅在课程开场就主动澄清了一个常见误解:这不是一门教你怎么用ChatGPT的课。ChatGPT只是生成式AI中最具代表性的一个例子,课程要讲的是生成式AI的全貌——这些模型怎么来的、怎么被训练出来的、为什么今天这么厉害,以及未来还有哪些可能性。
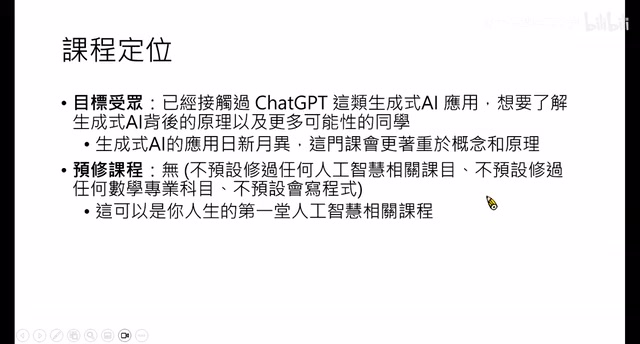
他的理由很直接:ChatGPT这类应用的界面和能力日新月异,几个月甚至几周就可能大变样,课堂上教的某个操作技巧很快会过时。而大学课程应该教往后数年甚至一辈子都用得上的东西,也就是背后的概念和原理。这个判断对自学者同样成立——追着工具教程跑,永远在补课;理解了Transformer、预训练、SFT、RLHF这些底层概念,换任何新工具都能快速上手。
课程明确不设预修要求:不需要修过AI相关课程,不需要数学和编程背景,可以作为人生的第一堂AI课。
课程内容:从原理到动手训练
据B站UP主的整合版本,课程分为三大模块。基础篇覆盖Python快速入门、AI开发环境搭建、提示词工程,以及大模型核心原理——Transformer、预训练、SFT、RLHF等关键概念。进阶篇进入RAG、Agent、LangChain等实战技术,以及大模型微调与私有化部署,结合企业真实场景讲基座模型选择、数据集处理和微调实施。实战篇则是企业级项目,如医疗问答系统、智能电商客服、数字人、教育行业智能助教等。
需要说明的是,UP主版本是对李宏毅原课的二次整合与扩充,课程中李宏毅本人的作业设计更偏原理体验。据他介绍,课程共10个作业,多数需要写程式甚至训练模型,执行环境用Colab或Kaggle,不需要自备GPU。
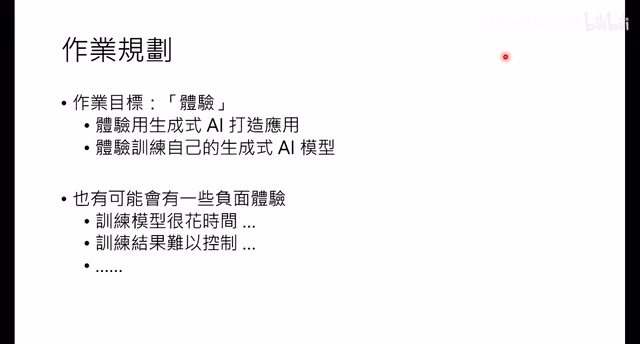
作业难度用三角形标注:一个三角形基本是送分题,两个三角形需要花时间才能拿满分,三个三角形涉及训练模型,至少需要数小时。李宏毅还特意保留了「负面体验」——训练模型耗时、结果不可完全复现。他把这种体验比作疫苗:让你知道训练模型可能很花时间、很难预测,未来面对更大挑战时多一分心理准备。
Transformer 是2017年Google在论文《Attention Is All You Need》中提出的神经网络架构,其核心是自注意力机制(Self-Attention),让模型能并行处理序列中任意两个位置的关系,而非像RNN那样逐步递归。这一设计大幅提升了训练效率,并成为GPT、BERT等几乎所有现代大语言模型的骨架。理解Transformer是理解「大模型为什么能work」的起点。
预训练(Pre-training) 指在海量无标注文本上通过自监督目标(如预测下一个词)训练模型,使其习得通用语言规律和世界知识。预训练后的模型称为基座模型(Base Model),它具备强大的补全能力,但还不会「听话」地遵循指令。
SFT(监督微调) 是在少量高质量的「指令-回答」配对数据上继续训练基座模型,让它学会按人类期望的格式和风格回应。RLHF(基于人类反馈的强化学习) 则更进一步:先训练一个奖励模型来模拟人类偏好,再用强化学习(如PPO)优化语言模型,使其输出更符合人类价值观。SFT+RLHF是ChatGPT类产品「对齐」的关键步骤,课程中会展开其原理与局限。
RAG(检索增强生成) 是一种让大模型在生成回答前先从外部知识库检索相关文档,并将检索结果作为上下文输入的技术。它无需重新训练模型就能注入私有或实时知识,常用于企业知识问答、客服等场景,是缓解大模型「幻觉」和知识过时问题的主流方案。
Agent(智能体) 指以大模型为「大脑」,能自主规划、调用工具(搜索、计算、API)并执行多步任务以达成目标的系统。与单轮问答不同,Agent强调循环决策与环境交互。
LangChain 是一个开源开发框架,提供链式调用、工具集成、记忆管理、Agent编排等组件,简化基于大模型的应用开发。课程进阶篇引入这些内容,是为了让学习者在理解原理后,能快速搭建可用的原型系统。
一个值得记住的类比:GPT-2与芙莉莲
课程中最出圈的段落,是李宏毅用《葬送的芙莉莲》做的类比。80年前魔王手下的干部库瓦尔发明了杀人魔法,无人能挡;80年后封印松动、库瓦尔复活,芙莉莲却只让弟子展开普通防壁就挡住了——因为人类用80年时间研究透了这套魔法。
对应到AI:作业里要微调的模型有70亿参数,听起来很大,但用免费算力就能跑,算不上特别厉害。可如果穿越回几年前,GPT-2最大的版本只有15亿参数,当时却被称作「史上最强NLP模型」。今天你手上的作业模型,是当年那个「毁天灭地」模型的好几倍。
这个类比指向一个务实结论:生成式AI技术变化极快,不要用五年前的标准判断今天的技术水位,也不要因为某个模型「参数大」就默认它强。参数量只是夸耀模型能力的指标之一,影响能力的因素还有很多。
参数量 指神经网络中可学习权重的总数,通常以「亿」或「十亿(B)」为单位。参数越多,模型容量越大,理论上能拟合更复杂的模式,但并非线性决定能力:数据质量、训练策略、架构优化、后训练对齐等同样关键。GPT-2最大版本15亿参数,而今天7B(70亿)模型在免费算力上即可微调,这直观反映了算力效率与算法进步的叠加效应。李宏毅的类比正是提醒:参数规模是历史坐标,不是绝对强弱标签。
用AI写作业?老师也用AI改
课程对AI工具的态度相当开放。学生能不能用ChatGPT写作业?李宏毅的答案是「可以」——生成式AI导论的课,当然应该可以用生成式AI写作业。同时他也说明,能用大语言模型批改的作业都会用大语言模型来批改,并感谢NTK的达宾奇团队提供平台和算力支持。据课程介绍,该团队还会到课堂分享业界使用生成式AI的经验,以及自研大语言模型的心路历程。
这种「用AI学AI、用AI教AI」的闭环,本身就比任何工具教程更能说明生成式AI在今天教育场景中的真实位置。
怎么学这门课:给自学者的三点建议
第一,先分清「会用」和「理解」。如果你只是想快速做出一个文章分类、客服问答的小应用,直接调用现成API就够了,不必花一学期学原理。但如果你想判断什么时候该自己开发模型、什么时候该用现成方案,原理课的价值就体现出来了。
第二,把作业当成体验而非考核。训练模型耗时长、结果有随机性,这些「负面体验」恰恰是理解大模型工程现实的最短路径。
第三,别被「保姆级」三个字误导。这门课是两学分的导论课,课时有限,很多技术只能点到为止。李宏毅自己的定位是:这门课手把手带你练几个魔术,但不足以把你训练成魔术师。它是起点,不是终点——课上引用的论文(多数来自arXiv)才是深入的方向。
对零基础学习者来说,这门课真正的价值不在于教会你某个框架的用法,而在于帮你建立一套判断技术水位和工具选择的坐标系。在模型能力几个月一变的节奏下,这比任何速成技巧都更耐用。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。