联邦变分不等式的更快收敛率:理论新突破
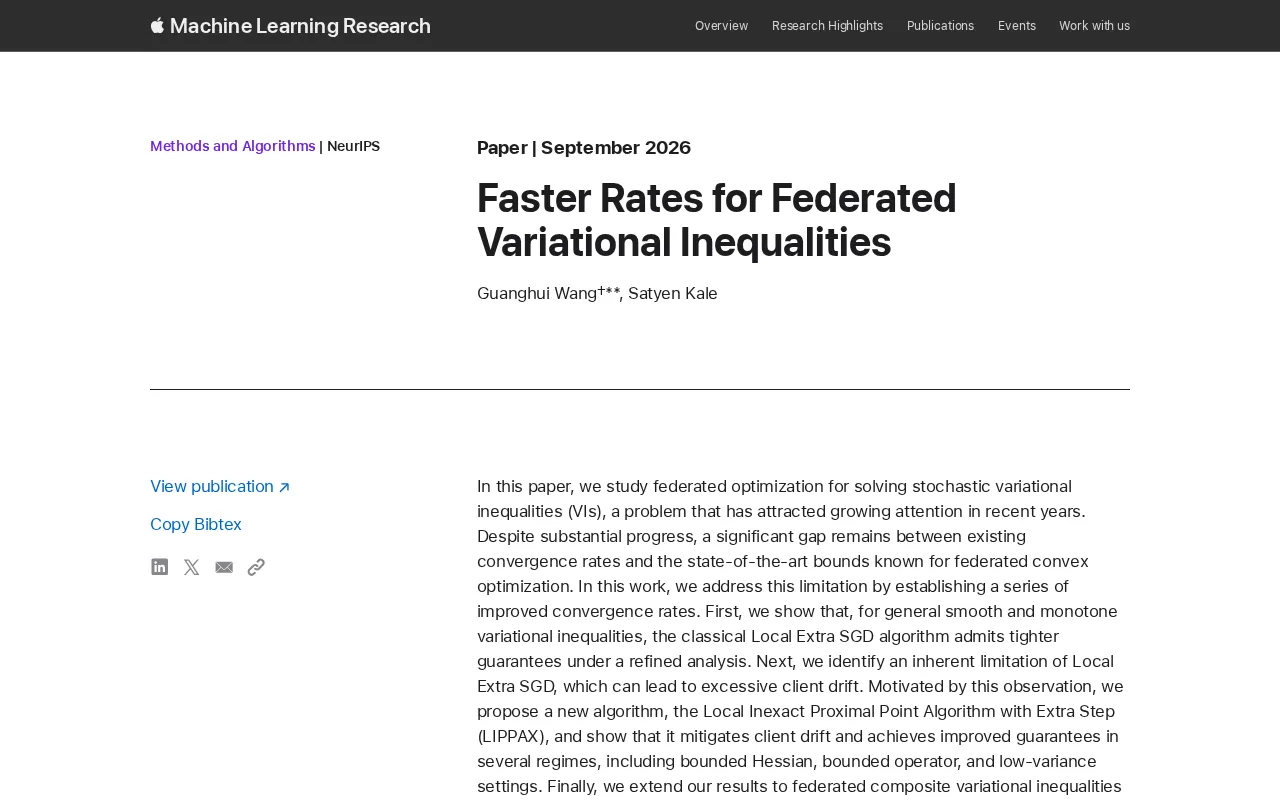
本文通过精细化分析Local Extra SGD,缩小了联邦变分不等式与联邦凸优化之间长期存在的收敛率理论差距。
联邦变分不等式(Federated VI)是分布式机器学习中涵盖极小极大优化、博弈均衡求解等问题的统一框架,但其收敛率理论长期落后于联邦凸优化领域的最优界。本文采用"旧算法、新分析"的策略,对经典的 Local Extra SGD 算法进行精细化理论分析,在一般光滑单调 VI 条件下建立了更紧的收敛保证,系统地缩小了上述理论差距。研究成果无需改动现有算法实现,即可为实践者提供更强的理论支撑,并在分布式对抗训练、多智能体博弈求解和隐私保护计算等应用场景中具有直接参考价值。
研究背景:联邦优化中的变分不等式难题
近年来,随着分布式机器学习和隐私保护计算的兴起,**联邦优化(Federated Optimization)**成为学术界和工业界共同关注的焦点。在这一领域中,求解随机变分不等式(Stochastic Variational Inequalities, VIs)是一个日益重要却颇具挑战的问题。变分不等式作为一种统一的数学框架,能够刻画包括极小极大优化(min-max optimization)、博弈论均衡求解在内的多类问题,因此在生成对抗网络(GAN)、对抗鲁棒性训练和多智能体系统中都有广泛应用。
然而,尽管过去几年该方向取得了实质性进展,一个关键的理论鸿沟始终存在:现有联邦变分不等式算法的收敛速率,与联邦凸优化领域已知的最优界之间仍有明显差距。换言之,我们在处理凸优化问题时能达到的理论保证,尚未在变分不等式场景中被充分复现。这篇论文正是瞄准这一空白展开研究。
变分不等式(Variational Inequalities, VIs) 的基本形式是:寻找向量 $x^$,使得对所有可行点 $x$ 满足 $\langle F(x^), x - x^* \rangle \geq 0$,其中 $F$ 是一个算子(通常是梯度或伪梯度)。当 $F$ 是某凸函数的梯度时,VI 退化为标准凸优化;当 $F$ 由极小极大目标中对两个变量分别求偏导构成时,VI 则刻画了鞍点问题。单调性是 VI 分析中对应于凸性的核心条件:若 $\langle F(x) - F(y), x - y \rangle \geq 0$ 对所有 $x, y$ 成立,则称算子 $F$ 单调,这保证了解的存在性与算法的收敛性。在随机设定下,每次迭代只能访问 $F$ 的噪声估计,这进一步增加了分析难度。联邦场景在此基础上再叠加多客户端数据异质性与通信受限两重挑战,使得直接套用集中式 VI 算法的理论分析不再可行。
核心贡献:一系列改进的收敛速率
该研究的核心目标是缩小上述理论差距,通过建立一系列更紧的收敛速率来推进联邦变分不等式的理论边界。
对经典算法的精细化分析
论文的第一项贡献颇具启发意义:针对**一般光滑且单调(smooth and monotone)**的变分不等式,作者证明经典的 Local Extra SGD 算法在经过更精细的分析后,能够获得比以往更紧的收敛保证。
这一结果的价值在于,它并未提出全新的复杂算法,而是重新审视了已有方法的理论潜力。这种"旧算法、新分析"的思路在优化理论研究中往往具有更强的现实意义——因为它意味着实践者无需更换现有实现,就能享受到更好的理论支撑。Extra SGD 通过引入额外的梯度外推步骤来稳定变分不等式的求解过程,而在联邦(Local)设定下,各客户端进行多轮本地更新再聚合,能够有效降低通信开销。
Extra SGD(Extragradient SGD) 的核心思想来自 Korpelevich(1976)提出的外推梯度法:在标准梯度步之前先做一次"预测步"(look-ahead step),用预测点处的梯度来指导实际更新。这一双步结构能有效抑制变分不等式求解中常见的震荡现象,在理论上可以保证对单调算子的收敛,而单纯的梯度下降-上升(GDA)在该情形下可能发散。在 Local Extra SGD 的联邦变体中,每个客户端在本地执行多轮 Extra SGD 迭代(即"本地步"),之后再将模型参数或梯度信息同步至中央服务器进行聚合。本地步数量越多,每轮通信所摊销的计算量越大,通信效率越高,但同时也会因各客户端数据分布不同而积累"客户端漂移(client drift)"误差。如何在本地计算与漂移误差之间取得平衡,正是联邦 VI 精细化分析的关键所在。
技术意义:从凸优化到变分不等式的迁移
变分不等式相比标准的凸优化更难处理,主要原因在于其算子的单调性并不等价于某个凸函数的梯度结构,因此许多在凸优化中行之有效的分析技巧无法直接照搬。这也是为什么长期以来联邦 VI 的收敛速率落后于联邦凸优化的根本原因。
本文的意义正体现在这里:它试图把联邦凸优化中那些先进的分析工具和界,系统地迁移到变分不等式场景中。如果这种迁移能够成功,就意味着在极小极大优化、分布式博弈求解等更广泛的问题上,我们都能获得更强的理论保证和更高效的算法设计。
在联邦凸优化领域,SCAFFOLD、FedProx 等算法通过引入方差缩减或近端正则项来纠正客户端漂移,已建立起接近最优的通信复杂度界。然而这些技术的关键前提是目标函数的梯度具有"势函数"结构——即算子 $F$ 本身是某函数的梯度场,从而可以借助函数值的下降来构造 Lyapunov 势能并证明收敛。对于一般的单调算子,这一势函数不存在,研究者必须转而构造基于算子范数或间隙函数(gap function)的替代度量,整个分析框架需要从头搭建。这正是为何联邦 VI 的理论进展长期滞后,即便凸优化那边的工具箱已相当完善。本文的核心技术挑战,便是找到能够跨越这道结构性鸿沟的分析路径。
应用前景与研究价值
从应用角度看,联邦变分不等式的收敛率改进具有多重现实意义:
- 分布式对抗训练:GAN 等生成模型本质上是极小极大问题,可以自然地建模为变分不等式。在联邦学习环境下训练此类模型时,更快的收敛率意味着更少的通信轮次和更低的计算成本。
- 多智能体与博弈场景:分布式的纳什均衡求解、多方博弈优化都可归结为变分不等式,理论上的改进能直接转化为算法效率的提升。
- 隐私保护计算:联邦框架本身就服务于数据不出本地的隐私需求,收敛速率的提升让隐私与效率之间的权衡更加友好。
小结
这项工作聚焦于一个具体而重要的理论问题——如何缩小联邦变分不等式与联邦凸优化之间的收敛率差距。通过对 Local Extra SGD 等经典算法的精细化分析,作者在一般光滑单调变分不等式上取得了更紧的收敛保证。对于关注分布式优化、极小极大问题和联邦学习理论的研究者而言,这一系列改进的速率结果为后续算法设计和理论分析提供了新的基准。
需要说明的是,由于本文属于理论性研究,其完整的技术细节、证明方法以及与现有方法的定量对比,仍需查阅原始论文才能全面把握。
相关推荐
Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。
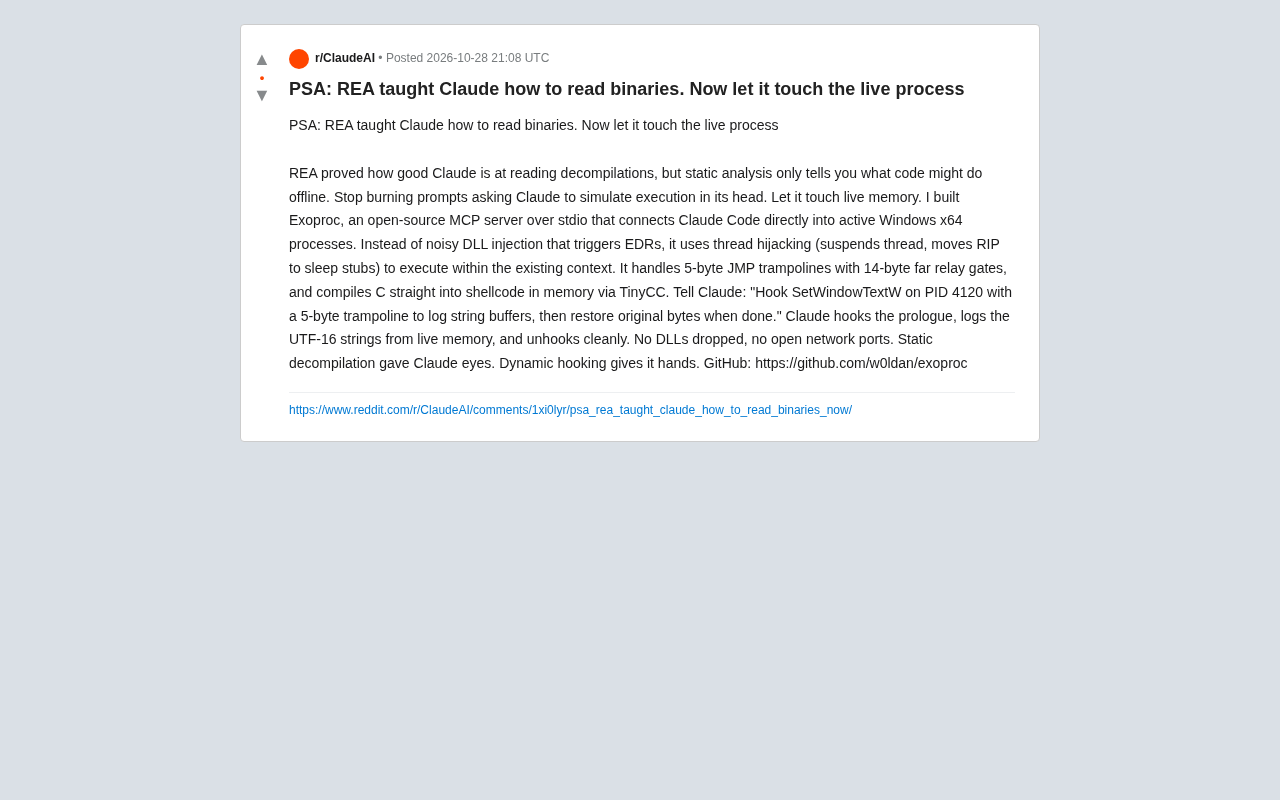
给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。