联合建模多元有序偏好:超越成对比较的新框架

新论文提出联合马尔可夫随机场模型,避免将有序偏好评分粗化为胜负比较,从而改进LLM对齐与推荐系统的偏好建模质量。
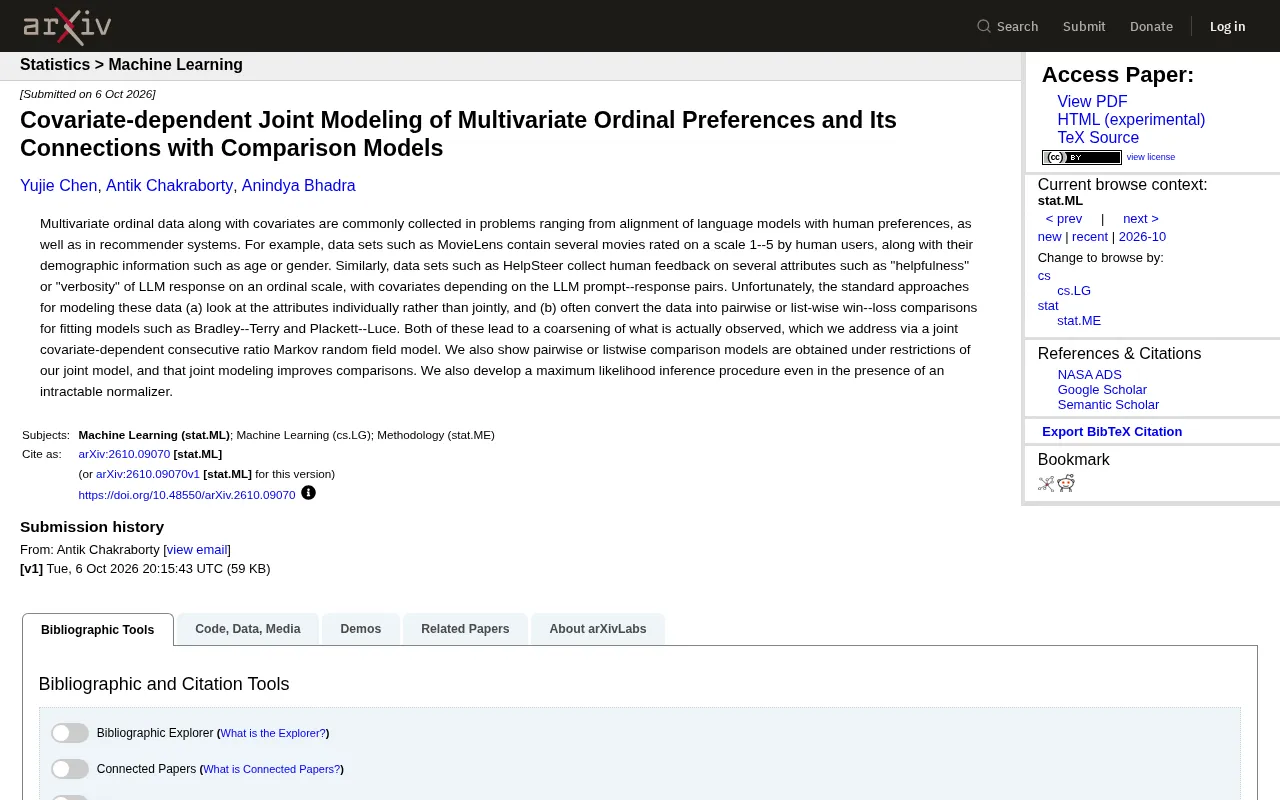
现有偏好建模方法(如 Bradley–Terry、Plackett–Luce)存在两大缺陷:将多维评分属性孤立处理,以及把有序分数转换为粗化的胜负比较,导致信息损失。这篇 arXiv 论文提出"协变量依赖的连续比率马尔可夫随机场模型",对多个有序属性进行联合建模,同时纳入用户特征等协变量,完整保留评分的有序结构与属性间相关性。理论上,作者证明 Bradley–Terry 等经典模型均是该联合模型的特例;实践上,针对 MRF 难解的归一化常数问题,论文开发了专门的极大似然推断方法,确保模型可操作。该研究对 RLHF 对齐流水线和推荐系统均具有直接启示:偏好数据的建模方式本身就是对齐质量的重要变量,过早粗化数据会无形限制下游效果。
从人类偏好数据说起
无论是让大语言模型对齐人类偏好,还是构建推荐系统,研究者都离不开一类特殊数据——带协变量的多元有序数据(multivariate ordinal data)。这类数据在现实中极为常见。
以经典的 MovieLens 数据集为例,用户会对多部电影按 1 到 5 分进行评分,同时数据集还附带了用户的年龄、性别等人口统计信息。类似地,用于 LLM 对齐的 HelpSteer 数据集,则收集人类对模型回复多个维度的反馈,比如"有用性"(helpfulness)或"冗长度"(verbosity),每个维度都以有序量表打分,而这些评分又依赖于具体的"提示-回复"对。
这类数据的核心特征在于:评分是有序的(1 分明显低于 5 分,但差值未必等距),且往往是多维度的(一个对象会在多个属性上被同时评价),还受到外部协变量的影响。如何恰当地建模这种结构,直接关系到偏好学习和模型对齐的质量。
现有方法的两大局限
这篇 arXiv 新论文指出,标准建模方法存在两个值得警惕的缺陷。
第一个问题是孤立看待各个属性。传统做法倾向于逐一分析每个维度,而忽略了属性之间的联合依赖关系。但现实中,"有用性"和"冗长度"往往彼此关联——一个过于简短的回复可能牺牲有用性,而冗长的回复也未必更有帮助。割裂地建模各维度,会丢失这些重要的相关性信息。
第二个问题是将数据转化为成对或列表式的胜负比较。许多主流模型,如 Bradley–Terry 模型和 Plackett–Luce 模型,需要先把有序评分转换成"谁赢谁输"的比较形式再进行拟合。论文作者认为,这种转换本质上是对真实观测数据的一种"粗化"(coarsening)——原本精细的有序评分被压缩成了二元或排序结果,信息在转换过程中被损耗。
这两个局限叠加,使得基于比较的偏好模型可能无法充分利用数据中蕴含的全部信号。
Bradley–Terry 模型是比较偏好建模中最经典的框架,起源于 1952 年。它假设每个候选对象拥有一个潜在的"实力"分数,任意两个对象之间的胜负概率由两者实力分数的 logistic 变换决定。Plackett–Luce 模型则是其在排序场景下的推广:给定一组对象,模型假设每次从剩余对象中按实力比例概率抽取排名第一的对象,依次生成完整排序。这两个模型在 RLHF 流水线中被广泛使用——OpenAI 训练 InstructGPT 时所采用的奖励模型训练范式,本质上正是 Bradley–Terry 框架的一种实例化。其核心操作就是将标注者的评分或排名转化为成对比较标签(A 优于 B),再用这些二元标签拟合奖励模型。这一做法的简洁性使其成为行业默认选择,但同时也意味着原始评分中蕴含的强度信息(例如"5 分对 1 分"与"3 分对 2 分"的质的差异)被彻底丢弃。
联合协变量依赖的建模方案
针对上述问题,论文提出了一个核心方法:协变量依赖的连续比率马尔可夫随机场模型(covariate-dependent consecutive ratio Markov random field model)。
这个模型的设计思路可以拆解为几个关键点。它直接对多个有序属性进行联合建模,而非逐一处理,从而捕捉属性之间的依赖结构。模型中引入了协变量,使得偏好的分布能够随用户特征或"提示-回复"上下文而变化。采用"连续比率"(consecutive ratio)的方式处理有序性,是统计学中处理有序响应的一种自然选择,能够尊重评分之间的次序关系。而马尔可夫随机场(MRF)的框架则提供了刻画多变量联合分布的灵活工具。
这套组合拳的目标很明确:在不损失有序信息、不割裂属性关联、不丢弃协变量影响的前提下,对偏好数据进行完整的建模。
连续比率模型(consecutive ratio model)是有序回归中的一种参数化方式,又称"相邻类别 logit 模型"的变体。对于有序响应变量(如 1 至 5 分),它建模相邻类别之间的转移概率,即在已达到某分数的条件下进一步上升一个等级的概率。这与另外两种常见的有序模型形成对比:累积 logit 模型(cumulative logit model,如比例优势模型)建模"得分不超过 k"的累积概率;相邻类别 logit 模型则直接比较相邻两类的概率比。连续比率模型在解释上更贴近"逐级递进"的心理过程,例如用户在考虑"是否从 3 分升到 4 分"时的决策,因此在行为数据和心理量表数据中具有自然的语义对应。将这一有序处理方式嵌入 MRF 框架,正是该论文在多元有序建模上的关键设计选择。
与比较模型的理论联系
论文一个颇具价值的理论贡献在于,它揭示了新模型与经典比较模型之间的内在关系。
作者证明,成对比较模型和列表式比较模型,实际上是其联合模型在特定约束条件下的特例。换言之,Bradley–Terry、Plackett–Luce 这类广泛使用的模型,并非独立于联合建模框架存在,而是可以从中推导得出的受限版本。
这一结论的意义在于,它把看似分散的建模方法统一到了一个更一般的框架之下。更重要的是,论文进一步论证了联合建模能够改进比较本身的效果——由于保留了更丰富的信息,联合模型在偏好比较任务上理论上优于那些先行粗化数据的方法。这为"是否值得采用更复杂的联合模型"提供了理论支撑。
应对棘手的归一化难题
马尔可夫随机场模型在实践中有一个著名的拦路虎:难解的归一化常数(intractable normalizer)。MRF 的联合概率分布需要一个配分函数进行归一化,而这个配分函数通常涉及对所有可能状态的求和或积分,在高维情况下几乎无法精确计算。
论文针对这一挑战,专门开发了即使在归一化常数不可解情况下仍然适用的极大似然推断方法(maximum likelihood inference procedure)。这意味着该模型不仅在理论上自洽,在实际参数估计层面也具备可操作性——这往往是这类复杂统计模型能否被真正应用的分水岭。
马尔可夫随机场(MRF)是一种以无向图表示变量间依赖关系的概率图模型,节点对应随机变量,边表示变量间的直接相关性。其联合分布由一系列势函数(potential functions)的乘积定义,并除以配分函数 Z 以归一化。配分函数需要对所有变量的所有可能取值组合求和,当变量数目或取值空间较大时,这是一个指数级的计算问题。应对这一难题的常见策略包括:变分推断(用简单分布近似真实后验)、MCMC 采样、对比散度(Contrastive Divergence)以及伪似然(pseudo-likelihood)方法。伪似然由 Besag 于 1975 年提出,将联合似然替换为每个变量关于其邻居条件概率的乘积,彻底规避了配分函数的计算,是 MRF 参数估计中最常用的实用替代方案。本文专门为有序数据场景开发的极大似然推断方法,正是在这一技术脉络下的针对性设计。
对AI对齐与推荐系统的启示
从应用视角看,这项工作触及了当前 AI 研究的一个热点领域。随着 RLHF(基于人类反馈的强化学习)和各类对齐技术的普及,如何从人类偏好数据中提取尽可能准确的信号,变得越来越关键。
如果偏好数据在进入模型前就被粗化为简单的胜负比较,那么下游的对齐效果可能受到无形的制约。这篇论文提醒我们,偏好数据的建模方式本身,就是对齐质量的一个重要变量。对于推荐系统而言,联合考虑多属性有序评分与用户协变量,同样有望带来更精细的个性化推荐。
当然,作为一篇理论性较强的新发表论文,其方法在大规模实际数据集上的表现、计算成本与可扩展性,仍需后续的实证验证。但它所提出的"不要过早粗化数据"的核心理念,对偏好学习领域的从业者具有普遍的参考价值。
相关推荐

分币不掏学AI Agent开发:从零搭建最小对话智能体
基于B站小福哥免费课程,详解AI Agent开发第一课:五阶段学习路线、OpenAI协议对接、Java轻量工程搭建与最小对话智能体实现,附HTTP请求解析与多语言对照要点。
安全团队须知:Abliterated模型在Agent中的风险
Abliterated模型通过权重层面移除对齐约束,当这类模型被用于具备工具调用能力的AI Agent时,风险从内容层面升级为操作层面。本文从模型来源审计、行为基线检测、运行时防护和供应链准入四个方向,为安全团队提供应对思路。
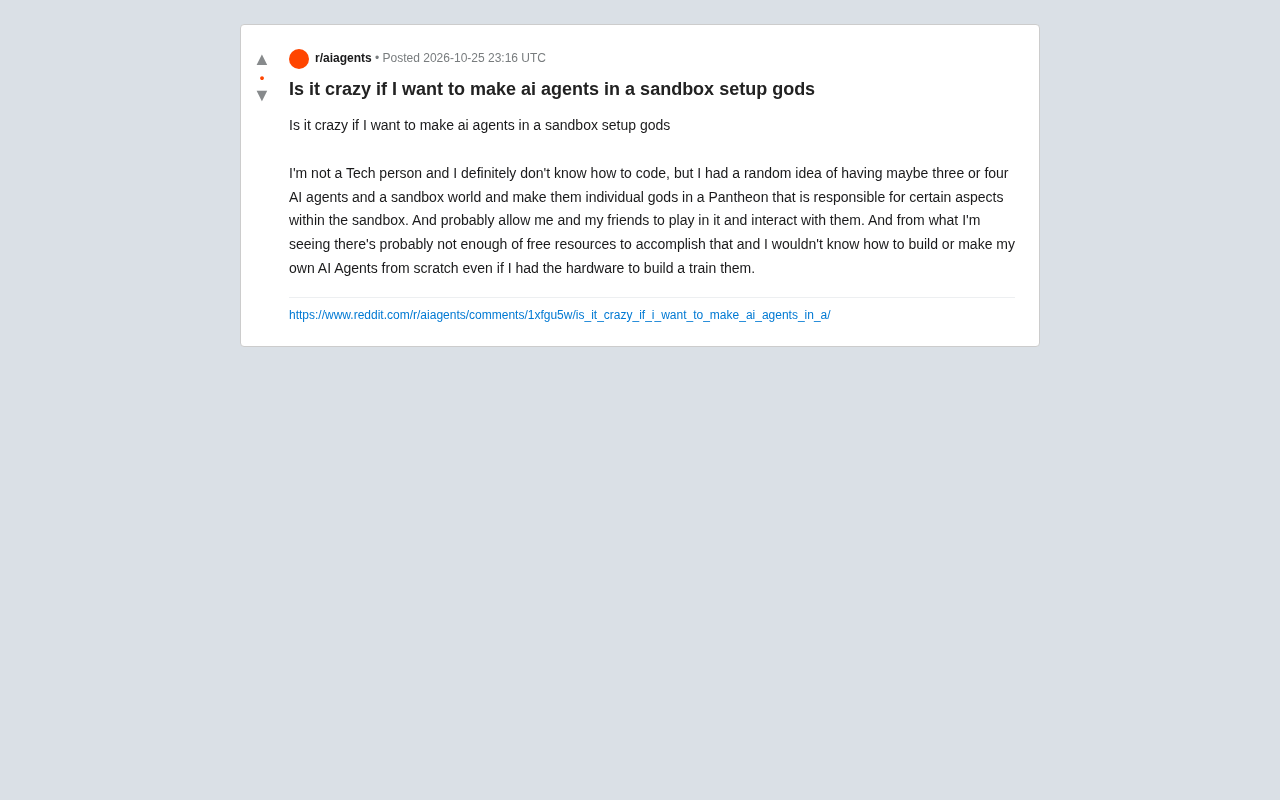
零代码造AI神祇沙盒:Reddit网友的疯狂构想可行吗
Reddit网友想用三四个AI智能体在沙盒世界里当神,让朋友进来互动。这个零代码构想技术上可行吗?本文拆解多智能体模拟的技术门槛、免费资源成本,并给出非技术发起者的务实落地路径。