廉价的OpenAI兼容API:开源大模型云端调用的机会与痛点
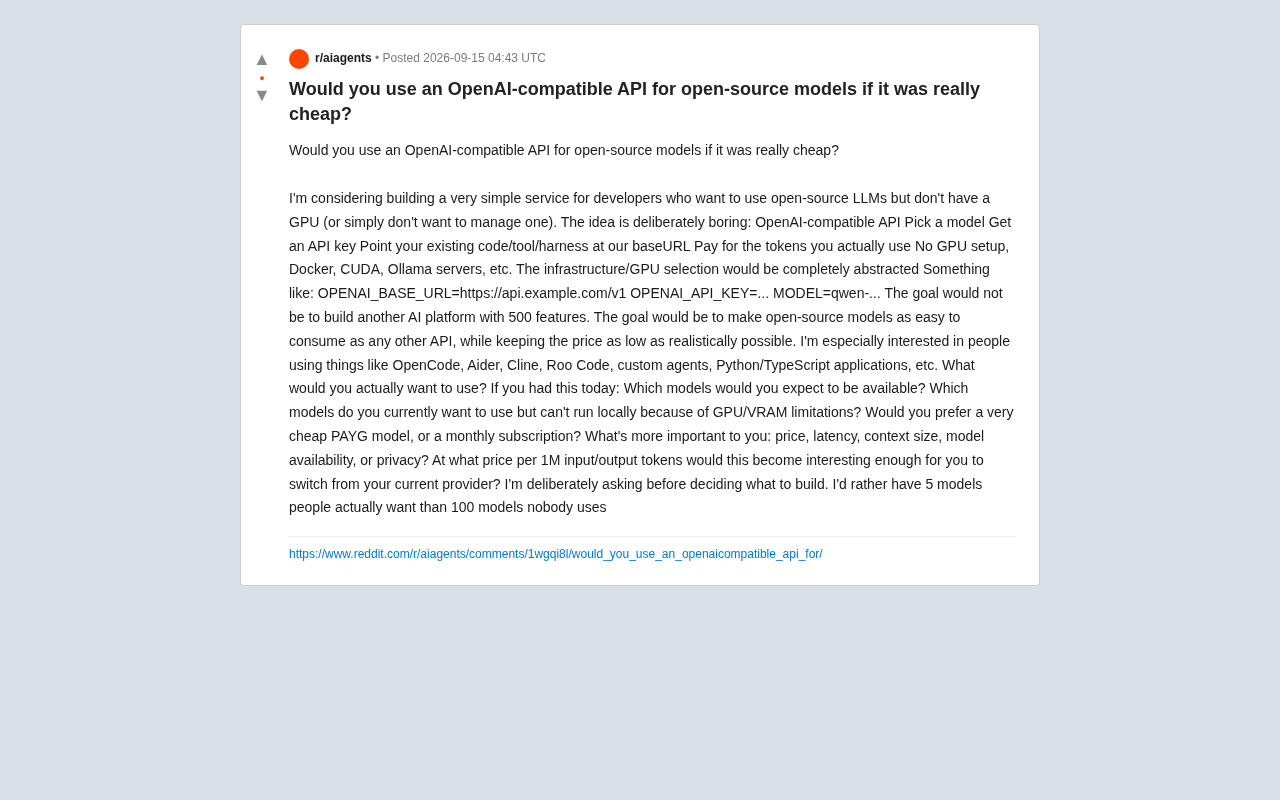
一位开发者构想极简廉价的OpenAI兼容开源模型API,并在动手前先做市场需求验证。
一位开发者在Reddit提出了一个「无聊但实用」的产品设想:构建一个兼容OpenAI接口、真正低价的开源模型托管API,让开发者无需自备GPU、配置CUDA或维护Ollama服务器,仅替换三个环境变量即可切换模型后端。目标用户是Aider、Cline等AI编程工具的使用者及自建Agent的开发者,核心卖点是零迁移成本。作者没有急于动手,而是先向社区征集需求:哪些模型最值得上线、偏好按量付费还是订阅、最看重价格/延迟/隐私中的哪项,以及愿意迁移的价格临界点。该赛道面临薄利、GPU优化和「简单与低价难以兼顾」等挑战,但随着Qwen、Llama等开源模型能力持续逼近闭源产品,这一需求的真实性不容忽视。
一个「无聊但实用」的产品设想
一位开发者在 Reddit 上抛出了一个值得琢磨的问题:如果有一个真正便宜、且兼容 OpenAI 接口的开源模型 API 服务,你会用吗?
这个设想被作者刻意描述为「无聊」——因为它不打算成为又一个功能堆砌的 AI 平台,而是专注做好一件事:让开源大模型(LLM)像调用任何普通 API 一样简单。整套流程被压缩到极致:
- 兼容 OpenAI 的 API 接口
- 选择一个模型
- 拿到 API Key
- 把现有代码或工具指向新的
baseURL - 按实际消耗的 token 付费
用户无需再折腾 GPU、Docker、CUDA 或自建 Ollama 服务器,底层基础设施与显卡选型全部被抽象掉。配置简单到只需替换三个环境变量:
OPENAI_BASE_URL=https://api.example.com/v1
OPENAI_API_KEY=...
MODEL=qwen-...
为什么这个方向击中了真实痛点
本地跑开源模型的门槛,远比许多人想象的高。想运行 Qwen、Llama 这类稍大参数的模型,往往需要足够的 VRAM 和一块像样的显卡,而这恰恰是大量开发者所缺乏的。即便硬件到位,安装 CUDA、维护 Ollama 或 vLLM 服务、处理版本兼容问题,都是持续的运维负担。
作者精准地锁定了目标人群:使用 OpenCode、Aider、Cline、Roo Code 这类 AI 编程工具的开发者,以及构建自定义 Agent、Python/TypeScript 应用的技术人员。这些用户的共同特征是——已经习惯了 OpenAI 风格的接口,只想换个更便宜的后端,而不想改动一行现有代码。
「OpenAI 兼容」这四个字是整个设想的关键。它意味着零迁移成本:任何已经接入 OpenAI SDK 的项目,只要改个 URL 就能切换到开源模型。这种即插即用的体验,正是许多开源模型托管服务缺失的部分。
这里提到的几个工具代表了当前 AI 辅助编程的主流生态:Aider 是一款基于终端的 AI 结对编程工具,直接与 Git 仓库交互;Cline(前身为 Claude Dev)和 Roo Code 是 VS Code 插件,能自主读写文件、执行命令;OpenCode 则是面向终端的 AI 编程助手。这些工具的共同点是通过标准的 OpenAI 兼容接口调用模型,因此只需更换 baseURL 和 API Key,无需修改工具本身即可切换到任意兼容后端。Ollama 是目前最流行的本地模型运行框架,支持一键拉取并运行开源模型;vLLM 则是专为生产环境设计的高性能推理引擎,支持连续批处理(continuous batching)以提升 GPU 利用率,但两者都需要用户自备硬件并承担运维工作。
作者真正想搞清楚的几个问题
值得肯定的是,这位开发者选择在动手之前先做需求验证,而不是闭门造车。他的原话是:「我宁愿有 5 个大家真正想用的模型,也不要 100 个没人用的模型。」为此他抛出了一连串问题,试图搞清市场的真实偏好:
模型选择
用户期望上线哪些模型?尤其是那些「想用但因 GPU/VRAM 限制跑不动」的模型——这类需求往往指向 70B 甚至更大参数级别的开源模型,恰恰是个人硬件最难承载的部分。
计费模式
是偏好极低价的按量付费(PAYG),还是包月订阅?这背后其实是使用频率与成本可预测性之间的权衡。重度用户可能更看重订阅的确定性,而偶尔调用的开发者则倾向于用多少付多少。
核心取舍
价格、延迟、上下文长度、模型可用性、隐私——哪个最重要?这是一道没有标准答案的题。做 Agent 的用户对上下文和延迟敏感,处理敏感数据的团队则把隐私放在首位,而个人开发者往往对价格最为在意。
价格临界点
每百万 input/output token 定价到多少,才足以让你从现有服务商迁移过来?这是最实际的问题,也是这类服务能否立足的生死线。
这个赛道的现实挑战
把想法拆开看,理想很美好,但落地并不轻松。开源模型托管本质上是一门薄利的基础设施生意,直接与已有的成熟玩家正面竞争。要把价格压到「真正便宜」,服务方需要在 GPU 利用率、批处理调度、模型量化等环节做到极致优化,否则很难在保证低价的同时不亏本。
同时,「简单」与「低价」之间存在张力。抽象掉所有基础设施细节意味着服务方要承担全部运维复杂度,而这部分成本最终仍要摊入 token 单价。如何在极简体验和可持续定价之间找到平衡,是这类产品最大的考验。
不过,需求本身是真实存在的。随着 Qwen、Llama 等开源模型能力逼近闭源模型,「用得起、用得爽」的开源模型 API 确实有市场空间。对于关注成本、又不愿被单一闭源厂商锁定的开发者而言,这种服务提供了一个有吸引力的中间选项。
文中提到的模型量化是降低部署成本的核心技术手段:通过将模型权重从 FP16(16位浮点)压缩到 INT8 或 INT4 精度,可在显著降低 VRAM 占用和推理成本的同时,将精度损失控制在可接受范围内。批处理调度(batching)则是提升 GPU 利用率的关键——推理服务会将多个并发请求合并为一批同时处理,避免 GPU 在等待单个请求时空转。现有的成熟竞争对手包括 Together AI、Fireworks AI、OpenRouter 等,它们已在这一赛道深耕多年,形成了规模效应。新进入者若要在价格上形成差异化,通常需要在特定模型或区域上集中优化,而非全线铺开,否则边际成本很难低于头部玩家。
对开发者的启示
抛开这个具体产品能否成功,作者的做法本身值得借鉴:先验证需求,再决定构建。与其一次性堆砌上百个功能,不如聚焦少数几个用户真正需要的模型和场景。
如果你正好是 Aider、Cline 这类工具的用户,或者在自建 Agent 时受困于本地 GPU 的算力天花板,不妨思考一下自己的答案:你最想要哪几个模型?你能接受的价格底线在哪里?这些朴素的问题,恰恰决定了开源模型能否真正走向大众化消费。
相关推荐
AI验证系统降本困局:如何少读证据又不漏掉关键信息
AI验证系统的真正成本不在检索而在阅读证据量。本文剖析一个RAG验证流水线的降本实践:提前停止、跳过切片、去重为何收效甚微,以及如何在保持高召回率的同时不漏掉少数派证据这一核心难题。
开发者微调AI模型实现视频字幕与水印去除
一位开发者微调开源模型,实现视频字幕与水印去除功能,支持图片处理,已部署在Hugging Face上开放试用。本文解析其实现思路、性能表现与应用争议。
Salesforce联手英伟达推Koa模型:企业AI的开源突围
Salesforce与英伟达联合推出基于开放权重模型Nemotron的推理模型Koa,专注销售、营销和客服场景。本文分析这一垂直化AI策略为何值得通用大模型实验室警惕,以及它对行业格局的启示。