LightOn OCR-3 上线 OpenDocRouter:开源 OCR 的性价比新标杆

LightOn OCR-3 以每千页$3.19的价格登陆OpenDocRouter,性能接近Gemini 3.8 flash low但便宜45%。
开源权重OCR模型LightOn OCR-3正式在OpenDocRouter平台上线,定价为$0.28/百万输入token、$1.40/百万输出token,折算页级成本约$3.19/千页。官方基准测试显示,该模型位于开源权重OCR领域的帕累托前沿,在性能与成本的权衡曲线上优势明显,与Gemini 3.8 flash low性能相当但价格低约45%。能力上,其文本定位(grounding)表现突出,表格处理尚可,图表理解相对薄弱。对开发者而言,这一方案的价值在于:无需自建推理基础设施即可按量调用,同时保留了在自有环境部署同套权重的灵活性,兼顾了成本与数据合规需求。
LightOn OCR-3 正式登陆 OpenDocRouter
开源 OCR 模型 LightOn OCR-3 现已在 OpenDocRouter 平台上线,定价为每百万输入 token $0.28、每百万输出 token $1.40,换算下来处理每千页文档约为 $3.19(基于 ParseBench 的测算)。对于需要大规模处理扫描件、PDF 和表格文档的团队来说,这个价格区间颇具吸引力。
这次上线的意义不只是多了一个可调用的模型。OCR(光学字符识别)长期以来是文档智能化的入口环节,而把一款开源权重(open-weight)模型以极具竞争力的价格托管到路由平台上,意味着开发者可以在不自建推理基础设施的前提下,直接按量调用一个性能接近闭源方案的工具。
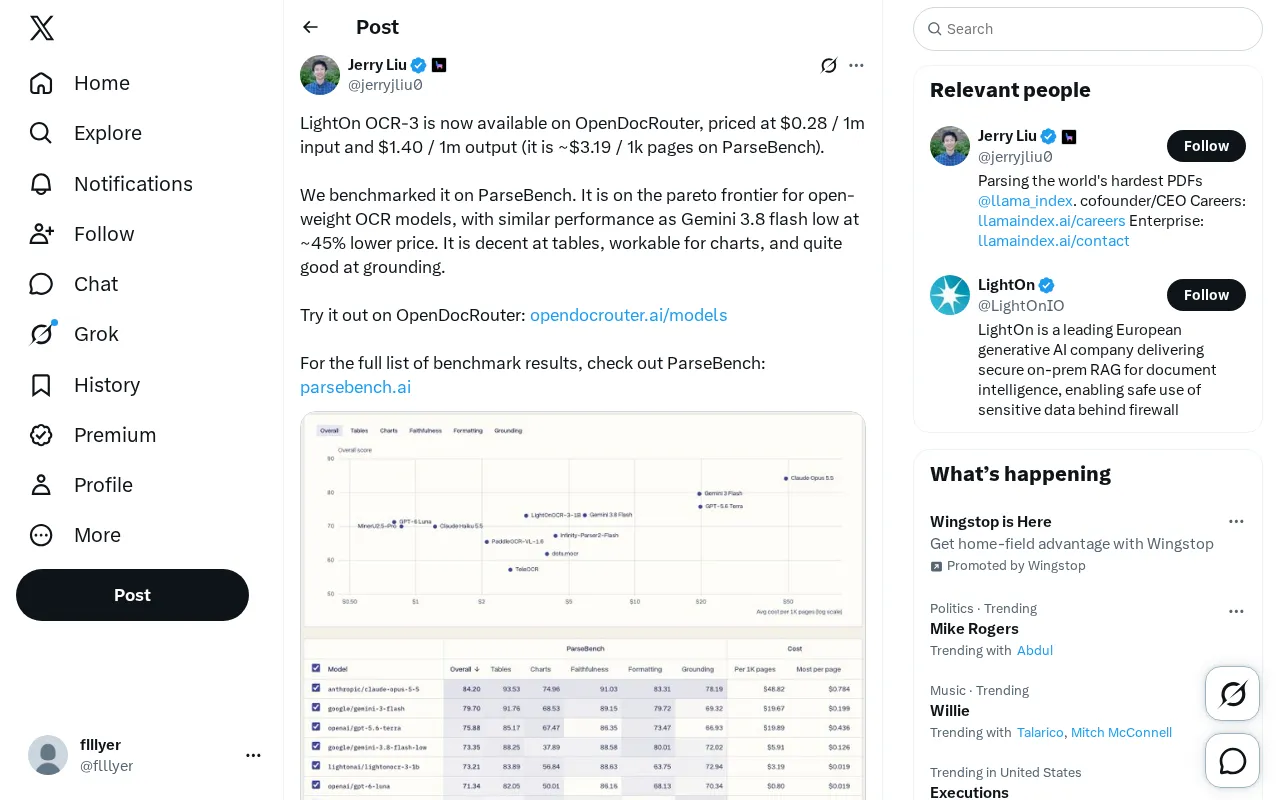
ParseBench 基准测试:踩在帕累托前沿上
根据官方在 ParseBench 上的基准测试结果,LightOn OCR-3 位于开源权重 OCR 模型的帕累托前沿(Pareto frontier)上。这个表述很关键——它意味着在性能与成本的权衡曲线上,很难找到既更便宜又更强的替代方案。
官方给出的对标对象是 Gemini 3.8 flash low,测试结论是二者性能相近,但 LightOn OCR-3 的价格要低约 45%。对于预算敏感、调用量大的文档处理场景,这种近似性能下的显著降价,往往比单纯堆叠精度更有实际意义。
不同文档类型的表现差异
官方对模型能力做了比较坦诚的分层描述,这一点值得关注:
- 表格(tables):表现尚可(decent),能够应对常见结构化数据的提取;
- 图表(charts):可用(workable),但显然不是强项,复杂图表仍可能需要人工复核;
- 定位/grounding:表现相当不错(quite good),即对文本在页面中的空间位置识别较为准确。
这种“强于定位、尚可处理表格、图表勉强够用”的能力画像,决定了它更适合以版面还原、文本抽取和位置标注为核心的工作流,而对图表语义理解要求极高的任务则需谨慎评估。
帕累托前沿(Pareto frontier)源自经济学与多目标优化领域,指在两个或多个相互竞争的指标中,无法在不损害其中一项的前提下改善另一项的解集合。放到 OCR 模型的性能-成本坐标系里,"处于帕累托前沿"意味着:在同等成本预算下找不到更高精度的模型,或在同等精度要求下找不到更低价格的模型。这个说法比单纯的"性价比高"更严格——它描述的是整条权衡曲线上的最优边界,而非某一单一维度的领先。ParseBench 是专为文档解析模型设计的标准化评测集,覆盖扫描件、PDF、表格等多种文档形态,提供统一的精度与速度指标,是目前开源社区中较为通行的 OCR/文档理解模型横评基准。
价格与性能的现实取舍
把成本拆开看会更清楚:$0.28 / 1M 输入与 $1.40 / 1M 输出的定价结构,输出端明显更贵,这符合生成类模型的普遍规律。而 $3.19 / 千页的页级成本,是衡量 OCR 项目实际开销最直观的指标——在批量归档、合同解析、票据数字化等场景中,页数往往是最终账单的决定变量。
相比动辄绑定闭源 API 的方案,开源权重模型的另一层价值在于可迁移性:虽然当前通过 OpenDocRouter 按量调用最为省心,但理论上团队也能在自有环境中部署同一套权重,从而在合规、数据隐私和长期成本上获得更多主动权。
开源权重(open-weight)模型与完全开源(open-source)模型存在微妙但重要的区别:开源权重模型公开了训练好的模型参数,允许下载和部署,但训练代码、数据集或商业使用条款可能受到限制。对比之下,完全开源模型通常连训练流程和数据也一并公开。LightOn OCR-3 属于前者,这意味着开发者可以获取权重文件在私有环境中运行,满足数据不出域的合规需求,但若需要对模型进行深度定制或二次训练,则可能受到许可证条款的约束。在评估任何开源权重模型时,提前核查其具体许可协议(如 Apache 2.0、CC BY-NC 等)是生产环境落地前的必要步骤。
对开发者意味着什么
对于正在搭建文档处理管线的开发者,LightOn OCR-3 提供了一个“先用再说”的低门槛选项。可以直接在 OpenDocRouter 上试用接口,并参照 ParseBench 的完整榜单对比各模型在不同维度的得分,再决定是否纳入生产环境。
一个合理的落地策略是:把 OCR-3 用于定位要求高、成本敏感的主体文本抽取,而在图表密集或精度要求极端的环节保留人工校验或更高阶模型的兜底。随着开源 OCR 在性价比曲线上持续推进,文档智能化的单位成本还有进一步下探的空间。
相关推荐

本周AI新品背后的三大趋势:多模型路由、低价竞争与生成式UI
本周AI行业密集发布新品,马斯克让Grok接入第三方最优模型、Anthropic推出低价高性能Claude Haiku、OpenAI发布Intelligent UI。本文梳理这三大发布背后的多模型路由、低价竞争与生成式UI三大趋势。

用 n8n 搭建你的 AI 团队:多智能体系统实战指南
本文详解如何用 n8n 和 Gemini 搭建多智能体系统(Multi-Agent System),通过 Supervisor Agent 调度 General、Tool、RAG 三个专职智能体,并结合 Pinecone 向量库实现 RAG 检索,是一份可落地的 AI 团队搭建实战指南。
CUTLASS Python:NVIDIA加速GPU内核开发的新利器
NVIDIA 工程师介绍 CUTLASS for Python 最新进展:面向最新 GPU 编写光速级内核的技术栈,新增 Qt 扩展、CUTLASS 原语、编译器诊断等特性,为开发者与 AI 智能体提供高性能内核开发与静态检查工具。