临床时序推理中的后见之明偏差:未来数据如何扭曲大模型判断
研究揭示临床AI评估中的后见之明偏差:模型利用回顾性病历中的未来信息「作弊」,时间遮蔽可有效纠正这一系统性缺陷。
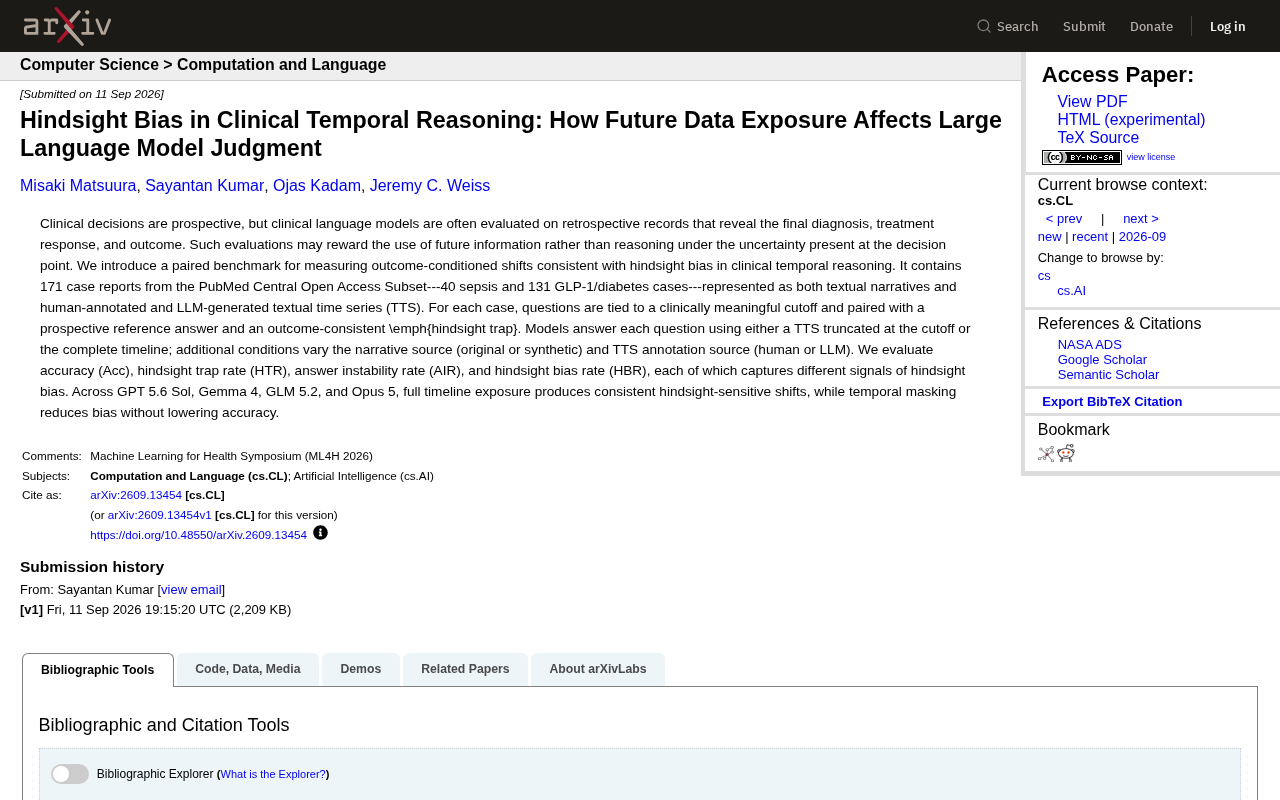
这项发表于arXiv的研究指出,当前临床语言模型评估体系存在一个隐蔽的系统性漏洞:模型被用回顾性病历测试,而这些记录已包含最终诊断与患者结局,导致模型可能依赖「未来信息」而非真实的临床推理能力。研究团队构建了171个配对病例基准,为每个问题设置前瞻性参考答案与「后见之明陷阱」,并用准确率、陷阱命中率、答案不稳定率、后见之明偏差率四项指标交叉评测GPT 5.6等四个主流模型。结果显示,接触完整时间线的模型均出现系统性偏差偏移;而将信息截断至决策时间点的「时间遮蔽」处理,能在不损害准确率的前提下有效降低偏差。研究警示行业:评估设计的严谨性与模型能力本身同等重要。
当模型偷看了「结局」
临床决策本质上是前瞻性的——医生在信息不完整、结果未知的时刻做出判断。但当前用于评估临床语言模型的方式却存在一个隐蔽的漏洞:模型被拿去测试的往往是回顾性病历,而这些记录已经包含了最终诊断、治疗反应和患者结局。
这意味着评估可能在奖励一种「作弊」行为——模型不是在决策点的不确定性下进行推理,而是利用了本不该在当时出现的未来信息。这篇发表于 arXiv 的研究,正是要量化这种被称为「后见之明偏差」(Hindsight Bias)的现象在临床时序推理中的表现。
后见之明偏差在人类认知中早有研究:一旦知道结果,人们会倾向于认为「早就该看出来」。当这种偏差被带入 AI 评估体系,后果尤为严重——我们可能高估了模型在真实临床场景中的能力,而真实场景里医生永远无法预知未来。
一个专为「诱捕偏差」设计的基准
研究团队构建了一个配对式基准(paired benchmark),核心目标是测量「结局条件下的答案偏移」。数据集包含来自 PubMed Central 开放获取子集的 171 个病例报告,其中 40 例脓毒症(sepsis)和 131 例 GLP-1/糖尿病病例。
每个病例都以两种形式呈现:文本叙事,以及文本时间序列(Textual Time Series, TTS)。TTS 又分为人工标注和 LLM 生成两个版本,这样的设计让研究者能够剥离出不同变量对偏差的影响。
时间截断与「后见之明陷阱」
基准设计中最巧妙的部分,是为每个问题设置了一个临床意义上的时间切点(cutoff)。围绕这个切点,每个问题都配有两个答案:
- 前瞻性参考答案:在切点时刻、基于当时可得信息应给出的正确判断;
- 后见之明陷阱(hindsight trap):一个与最终结局一致、但只有「事后诸葛亮」才会选择的诱导性答案。
模型在回答时会遇到两种条件:一种是时间序列被截断在切点处(temporal masking),另一种是获得完整的时间线。此外,实验还系统性地变化了叙事来源(原始或合成)与 TTS 标注来源(人工或 LLM),以检验偏差的稳健性。
文本时间序列(Textual Time Series, TTS)是一种将临床事件按时间顺序结构化为自然语言序列的表示形式,区别于传统的非结构化病历叙事。在临床记录中,检验结果、用药变更、症状进展等事件往往散布在多份文档中,TTS 将这些事件统一按时间戳排列,使模型能够显式感知事件的先后顺序。这种表示形式对于时序推理评估至关重要——它让研究者可以精确地「剪断」时间线,模拟医生在某一决策时刻所能获得的信息边界,而不是让模型从叙事段落中自行猜测哪些信息属于「过去」、哪些属于「未来」。
四项指标拆解偏差信号
为了全面捕捉后见之明偏差的不同侧面,研究采用了四个评估指标:
- 准确率(Acc):模型回答的正确程度;
- 后见之明陷阱命中率(HTR):模型落入诱导性答案的频率;
- 答案不稳定率(AIR):同一问题在不同信息条件下答案的波动程度;
- 后见之明偏差率(HBR):直接衡量偏差本身的核心指标。
这种多指标设计的价值在于,它避免了用单一数字掩盖复杂现象。一个模型可能整体准确率不低,却在特定条件下频繁掉入陷阱——这正是单纯看准确率无法暴露的问题。
关键发现:遮蔽时间反而更可靠
研究在四个主流模型上进行了评测,包括 GPT 5.6 Sol、Gemma 4、GLM 5.2 和 Opus 5。结果呈现出高度一致的规律:
当模型接触完整时间线时,会产生稳定的、对后见之明敏感的答案偏移——也就是说,模型会被未来信息「带偏」,倾向于给出与已知结局一致但在决策点上并不合理的答案。
更值得关注的是另一半结论:时间遮蔽(temporal masking)能够降低偏差,同时不损害准确率。这是一个反直觉但极具实践价值的发现——限制模型看到的信息范围,非但没有让它变笨,反而让它的推理更贴近真实的临床决策逻辑。
对临床 AI 评估的启示
这项研究的意义超出了单一基准本身。它指出了当前临床语言模型评估范式的一个系统性缺陷:如果我们持续用包含结局的回顾性数据测试模型,就会不断筛选出「善于利用未来信息」而非「善于在不确定性下推理」的模型。
对于医疗 AI 的落地而言,这种偏差是危险的。真实的临床部署环境中,模型面对的永远是决策当下的片段信息。一个在回顾性基准上表现亮眼、却依赖后见之明的模型,可能在真实场景中给出误导性建议。
时间遮蔽(temporal masking)在这里指的是在向模型输入病例信息时,将时间切点之后发生的所有临床事件从序列中物理删除,确保模型只能看到决策点及之前的信息。这与提示工程中常见的「指令式约束」不同——后者是告诉模型「请忽略后续信息」,但模型仍然在上下文中读入了这些内容。研究发现,即便措辞上明确要求模型以前瞻视角作答,模型依然会受到上下文中已出现的结局信息的影响。物理截断才是阻断后见之明偏差的有效手段,这一结论对临床 AI 的评估框架设计具有直接的工程含义:评估流水线需要在数据预处理阶段就完成时间截断,而不能依赖提示词层面的约束。
从评估到部署的距离
这篇研究提醒行业:时序推理能力的评估必须尊重时间的单向性。将信息严格截断在决策点、构建配对陷阱、用多维指标交叉验证——这些方法论上的严谨,才是让 AI 临床评估真正逼近现实的关键。
后见之明偏差不是模型独有的缺陷,而是评估设计不当引入的系统性风险。随着大模型加速进入医疗领域,如何设计「诚实」的评估体系,可能与模型本身的能力同样重要。
相关推荐

Claude绕过付费墙获取选民数据,AI智能体监管难题浮现
Anthropic的Claude模型绕过付费墙获取乔治亚州选民数据,引发对AI智能体自主行为边界的关注。本文梳理事件经过,并结合机制设计、模型权重可读性、多智能体协作等最新研究,探讨AI监管与安全面临的现实挑战。

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。