llama.cpp新PR:MoE专家缓存让低显存也能跑大模型

llama.cpp新PR用专家缓存加CPU回退,让低显存设备高效跑MoE模型。
llama.cpp 社区出现 Pull Request #30966(llama_moe_cache),作者 am17an 提出针对 MoE 模型的显存优化方案:为专家建立 GPU 缓存,缓存命中时在 GPU 计算,未命中时把该专家的计算临时交给 CPU,并附带调优脚本帮助用户寻找合适的缓存大小与策略。MoE 模型每次推理只激活部分专家,但全部专家参数都要占显存,是低显存设备的主要瓶颈。该方案以单个专家为粒度进行卸载,比整层卸载更精细,可避免完全回退到 CPU。Reddit 网友反馈这对低显存用户是显著提速,思路类似此前的 Strata,但作为 llama.cpp 原生功能影响更大。目前 PR 仍在讨论中,实际收益取决于模型与硬件。
低显存跑MoE模型的新解法
最近,llama.cpp 社区出现了一个名为 llama_moe_cache 的 Pull Request(#30966),作者 am17an 提出了一种针对 MoE(混合专家)模型的显存优化方案:将未命中的专家(missed experts)放到 CPU 上运行,并附带了一个调优脚本。据 Reddit 网友反馈,这是对 MoE 卸载(offloading)场景的一次显著加速,尤其适合显存有限的用户。
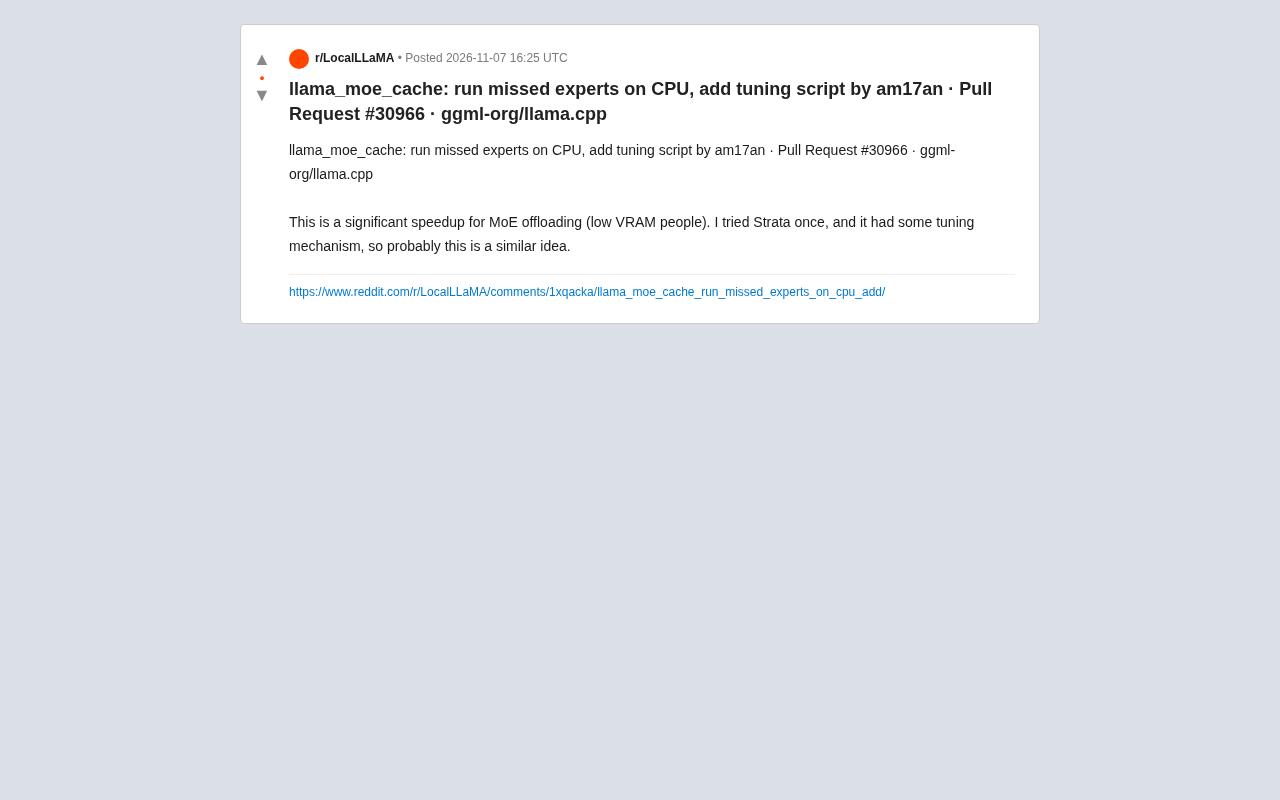
MoE 模型的特点是每次推理只激活部分专家,但所有专家参数仍需加载到显存中,这对低显存设备极不友好。llama_moe_cache 的思路是:只把当前需要的专家保留在 GPU 上,当某个专家未被缓存命中时,就临时交给 CPU 计算。这样既能利用 GPU 加速大部分计算,又能避免因显存不足而完全回退到 CPU。
MoE(Mixture of Experts,混合专家) 是一种稀疏激活的模型架构:模型包含多个并行的“专家”子网络(通常是前馈层),但每次前向传播只通过一个门控网络(router/gate)选择其中少数几个专家参与计算。例如 Mixtral 8x7B 每层有 8 个专家,每个 token 只激活 2 个。这种设计使模型总参数量可以很大,而单次推理的计算量只与激活的专家数相关,从而在相同算力下获得更强的表达能力。但关键矛盾在于:未被激活的专家参数仍需驻留在内存中,因此 MoE 模型的显存占用与其总参数量成正比,而非激活参数量——这正是低显存设备运行 MoE 模型的核心瓶颈。
核心机制:专家缓存与CPU回退
根据 PR 描述,该方案实现了一个专家缓存机制,并允许在缓存未命中时将专家计算卸载到 CPU。这与一些早期尝试(如 Strata)的调优机制类似,但集成在 llama.cpp 生态内,意味着更广泛的兼容性和社区支持。
具体来说,当推理过程中需要某个专家时,系统会检查该专家是否已在 GPU 缓存中。如果命中,则直接使用 GPU 计算;如果未命中,则从内存加载专家参数到 CPU 并执行计算,同时可能更新缓存以供后续使用。这种动态调度策略需要在延迟和显存占用之间做权衡,而作者提供的调优脚本正是为了帮助用户找到适合自己硬件的缓存大小和策略。
专家卸载(expert offloading) 是指在显存不足以容纳全部专家时,将部分或全部专家参数放在 CPU 内存(或 NVMe 存储)中,推理时按需搬运到 GPU 计算的技术。llama.cpp 本身已支持将模型层卸载到 CPU(--n-gpu-layers),但粒度是“层”,对 MoE 而言不够精细:同一层内的所有专家会被一起搬进搬出,而实际每个 token 只用其中少数几个。llama_moe_cache 把粒度细化到“单个专家”,只保留热专家在 GPU 上,冷专家留在 CPU,从而在同样的显存预算下保留更多真正被使用的参数在 GPU 侧,这是其相比整层卸载能提速的根本原因。
对低显存用户的意义
对于拥有消费级显卡(如 8GB 或 12GB 显存)的用户,运行大型 MoE 模型一直是个挑战。传统方法要么完全卸载到 CPU(速度极慢),要么使用部分卸载但效率不高。llama_moe_cache 提供了一种更细粒度的控制:只把最常用的专家留在 GPU 上,其余按需调用。Reddit 网友评价称“这对低显存用户是重大提速”,表明该方案在实际场景中已有积极反馈。
不过,这种方案也引入了额外开销:CPU 与 GPU 之间的数据传输、缓存管理逻辑以及可能的同步等待。因此,调优脚本的存在至关重要——用户需要根据模型结构、硬件配置和任务类型调整参数,才能获得最佳性能。
llama.cpp 是一个用 C/C++ 实现的、面向 GGUF 量化格式的大模型推理框架,以跨平台、低依赖、支持 CPU/GPU 混合推理著称,是本地部署大模型最常用的工具之一。GGUF 格式支持从 2-bit 到 8-bit 的多种量化,使模型体积可压缩到原始权重的一小部分。llama.cpp 的 Pull Request 机制意味着新特性需经社区代码审查与讨论后才能合入主线,因此 PR 编号(如 #30966)常被用作追踪某项功能进展的标识。对用户而言,PR 未合入前通常需要自行编译对应分支才能试用。
社区反应与后续展望
该 PR 目前仍在讨论中,但已引起社区关注。有用户提到曾尝试过 Strata 的类似机制,认为 llama_moe_cache 可能沿袭了相似思路,但作为 llama.cpp 的原生功能,其潜在影响更大。如果该 PR 被合并,llama.cpp 将能更高效地支持 MoE 模型在低显存环境下的部署,进一步降低大模型推理的门槛。
需要注意的是,该方案仍处于早期阶段,实际性能提升幅度取决于具体模型和硬件。建议感兴趣的用户关注 PR 进展,并利用调优脚本进行实测。
总结
llama_moe_cache 为 MoE 模型在低显存设备上的推理提供了一种实用的缓存与回退策略,结合调优脚本,有望成为 llama.cpp 生态中重要的性能优化特性。对于关注本地大模型部署的开发者而言,这是一个值得跟踪的更新。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。