LLM 0.37 发布:新模型与 AI 辅助 PR 的启示

LLM 0.37 新增模型与端点命令、支持多模态嵌入,并分享 AI 辅助 PR 的治理经验。
Simon Willison 的 LLM CLI 工具与 Python 库发布 0.37 版本,积累约两个月的开发成果。该版本新增 gpt-6.1-sol 与 gpt-6.1-terra 两个模型,并引入 llm openai endpoint add 命令,使用户无需手动编辑配置文件即可接入 OpenAI 兼容的第三方服务。默认模型切换为 gpt-6-luna,价格为此前默认模型 gpt-5.6-luna 的一半,直接降低频繁调用 API 的成本。嵌入接口现在支持为不同二进制内容指定不同 content-type,以适配 Gemini Embedding 2 这类可嵌入文本、音频、图像和视频的多模态模型。Simon 还专门回应了 AI 辅助 PR 的争议,称 LLM 是他受影响最大的项目,但他用 Opus 5.5 或 GPT-6 Astra 辅助分类 PR,实际审查负担低于预期。
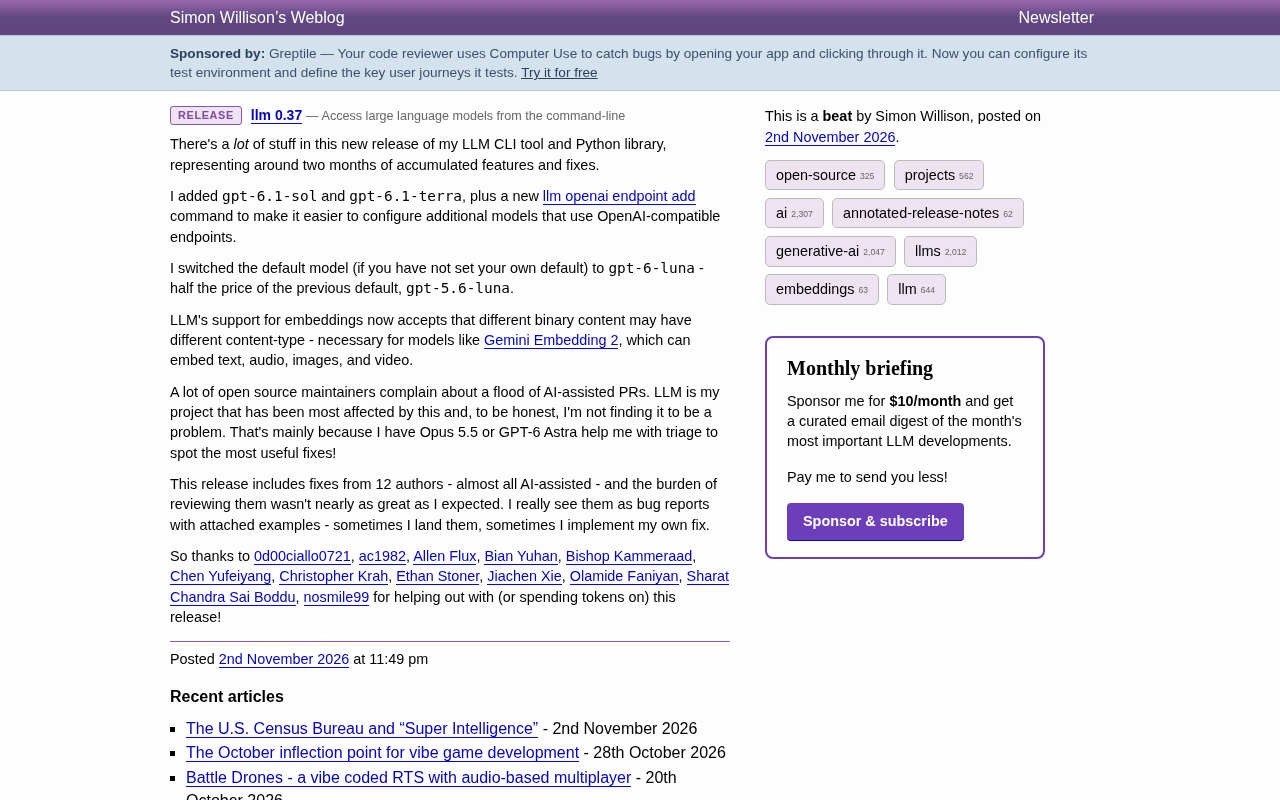
Simon Willison 的 LLM CLI 工具与 Python 库迎来 0.37 版本,这是约两个月开发成果的集中发布。除了新增模型支持和命令行工具,这个版本还折射出开源项目如何应对 AI 辅助代码贡献的浪潮。
新模型与配置工具
LLM 0.37 新增了 gpt-6.1-sol 和 gpt-6.1-terra 两个模型选项。同时,llm openai endpoint add 命令的加入让配置 OpenAI 兼容端点变得更简单——用户不再需要手动编辑配置文件,就能接入更多第三方模型服务。
另一个实用变化是默认模型的调整:如果你没有设置自己的默认模型,LLM 现在会使用 gpt-6-luna。据 Simon 介绍,它的价格是之前默认模型 gpt-5.6-luna 的一半。对于频繁调用 API 的用户来说,这直接降低了使用成本。
OpenAI 兼容端点 指第三方推理服务(如本地部署的 vLLM、Ollama,或各类云厂商的托管服务)实现与 OpenAI Chat Completions API 相同或相近的请求与响应格式,从而使现有客户端无需改动代码即可切换后端。此前接入这类服务通常需要手写 YAML 配置,声明 base URL、API key 环境变量和模型列表,容易出错且难以发现拼写问题;llm openai endpoint add 把这一流程命令化,降低了接入门槛,也让同一台机器上并存多个端点、按模型名路由成为常规操作。
嵌入支持多模态内容
LLM 对 embeddings 的支持在此版本中有所扩展,现在可以接受不同二进制内容对应不同 content-type。这一改动是为了适配 Gemini Embedding 2 这类能够嵌入文本、音频、图像和视频的模型。
此前嵌入接口可能假设输入都是纯文本,而多模态模型的出现要求上层工具能够区分内容类型。LLM 的这次调整让开发者可以在同一个工作流中处理多种格式的嵌入请求。
Embeddings(嵌入) 是把文本、图像、音频等原始内容映射为高维稠密向量的过程,向量之间的距离可用于语义检索、聚类、去重和推荐。传统嵌入模型只处理单一模态,因此调用层通常可以假定输入为纯文本;而多模态嵌入模型(如文中提到的 Gemini Embedding 2)对同一接口接受多种媒体类型,要求调用方显式声明 content-type,否则服务端无法正确解码。LLM 的这次改动本质上是把「内容 + 类型」作为一个整体单元传递,使不同格式的嵌入请求能在同一批次或工作流中复用相同的抽象接口。
AI 辅助 PR:负担还是助力?
Simon 在发布说明中专门谈到一个开源社区的热门话题:AI 辅助生成的 Pull Request 是否给维护者带来了过重负担。他坦言 LLM 是自己受影响最大的项目,但实际体验并不像许多同行描述的那样糟糕。
他的做法是用 Opus 5.5 或 GPT-6 Astra 协助分类 PR,快速识别出最有用的修复。这个版本包含了来自 12 位作者的修复,几乎全部有 AI 辅助参与。Simon 认为审查负担远低于预期,他把这些 PR 视为附带示例的 bug 报告——有时直接合并,有时参考后自己实现修复。
这一经验提供了不同于主流叙事的视角:AI 辅助贡献的治理问题,可能更多取决于维护者是否愿意引入同等的 AI 工具来辅助筛选,而非简单地关闭大门。
Pull Request(PR) 是 GitHub 等平台上的代码合并请求机制:贡献者从自己的分支提交改动,维护者进行代码审查(review)、讨论并决定是否合入主线。开源项目长期面临审查资源不足的问题,而 AI 生成的 PR 往往能做到格式规范、描述详尽,却可能包含看似合理实则错误的改动,反而增加了甄别成本——这正是「AI slop PR」争议的来源。文中 Simon 的做法是把 PR 降格为「附带示例的 bug 报告」,即不把作者提交的补丁本身视为最终产物,而是把它当作问题定位和修复思路的线索,由维护者决定直接合并还是重写,这一处理方式绕开了逐行审查 AI 代码的成本问题。
发布节奏与社区协作
0.37 版本积累了两个月的功能和修复,说明 LLM 项目在保持稳定迭代的同时,也在逐步吸收社区反馈。从新增模型、端点配置命令到嵌入接口的兼容性调整,这些改动都指向同一个方向:让 LLM 作为多模型、多模态的调用层更加顺手。
对于使用 LLM 的开发者,升级后值得关注默认模型的变化是否影响现有工作流,以及新端点命令能否简化自己的模型接入配置。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。