LLM WIKI实战:让智能体真正理解企业业务

企业AI落地瓶颈在于业务知识未文字化,需以LLM WIKI先行沉淀再由Agent执行。
文章基于B站UP主老肖的实战分享指出,企业用大模型降本增效的真正瓶颈不是模型选型或RAG、工具调用等技术模块,而是智能体不理解业务。业务规则未记录、流程无文档、业务方配合意愿低,导致技术栈搭起来后Agent只是“看起来能跑”。解法是搭建LLM WIKI企业私有知识库,把散落在人脑和口头传授中的隐性知识结构化为业务事实来源,供Agent推理时调用。文章同时引入FDE工程师概念,将其定位为把具体业务线翻译成智能体可理解执行形式的角色,并给出三点落地启示:知识库建设先行于Agent开发、优先选无文档业务线做试点、业务方配合本质是机制与工具问题。
企业想用大模型降本增效,真正的难点不在模型选型,也不在RAG、工具调用这些技术模块,而在于一个更底层的问题:智能体根本不理解你的业务。
这个判断来自B站UP主老肖(马式教育大模型主讲老师)的一场实战分享。他用一个模拟的订单客服业务线做案例,展示了从零搭建LLM WIKI私有知识库、让Agent跑通企业业务的完整思路。
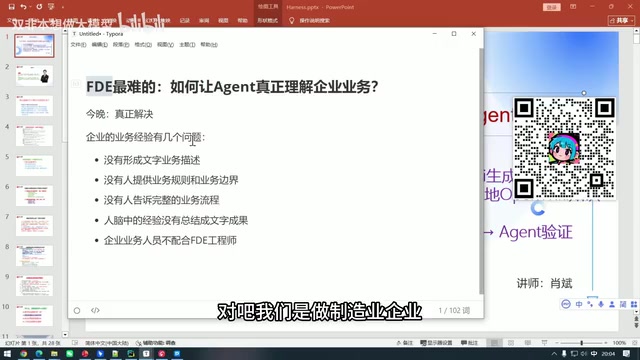
企业业务落地的真正瓶颈:知识没有形成文字
老肖把企业AI落地的最难环节归结为一句话:如何让智能体理解企业的业务。他列举了企业业务知识普遍存在的几种缺失状态:
- 业务规则和业务边界没有被记录。一个客服经理带两个助手手把手教,教会就完事,没有人把"看到什么情况要怎么处理"写成文字。
- 业务描述没有形成文档。流程只存在于老员工的脑子里,新人靠观摩学习,完整的业务流程无人系统性整理。
- 业务人员配合意愿低。做落地的工程师去了解业务线时,业务方往往觉得"事不关己",缺乏主动输出知识的动力。
这三点叠加的结果是:工程师即便把RAG、工具调用、短期记忆、长期记忆、MCP这一整套技术栈都搭起来,做出来的智能体依然只是"看起来能跑",并不真正理解订单客服该做什么、边界在哪。
这个问题在行业内并不新鲜,但老肖强调它恰恰是所有智能体项目落地的第一道坎,也是他这场分享要解决的核心问题。
用LLM WIKI把隐性知识显性化
老肖的解法思路是搭建一个LLM WIKI——面向大模型的企业私有知识库。他的做法值得注意的地方在于:案例中的订单客服业务线本身"没有形成任何文字",也就是说他刻意还原了企业知识零散、无文档的真实状态,然后让智能体自己去把这套业务跑起来。
从方法论上看,LLM WIKI承担的角色不只是"存文档",而是把原本散落在人脑、口头传授、碎片经验中的业务规则沉淀为结构化知识,供Agent在推理时调用。这比单纯堆一个向量库更进一步:知识库的结构和内容质量,直接决定了智能体能理解业务到什么程度。
结合他提到的技术组件(工具定义、上下文、短期与长期记忆、MCP等),可以推断LLM WIKI在整个架构中扮演的是"业务事实来源"的角色——Agent通过它查询业务规则,再结合工具调用完成具体动作。
隐性知识(Tacit Knowledge) 是知识管理领域的核心概念,由哲学家波兰尼提出,指那些难以用语言、文字或符号清晰表达的知识,比如老员工凭直觉判断异常订单、师傅带徒弟式的手感经验。与之相对的显性知识则可以被编码、记录和传递。企业AI落地之所以卡在知识环节,本质上就是隐性知识占比过高:业务规则藏在人脑里,Agent无法读取。LLM WIKI这类知识库的价值,就是通过访谈、流程梳理、案例归纳等手段把隐性知识转化为结构化文本,使其成为模型可检索、可推理的显性知识。这个过程无法完全自动化,往往需要FDE工程师与业务方反复协作才能完成。
FDE工程师的定位:业务与模型的翻译层
老肖在分享中引入了FDE工程师这个概念。他给的定义很直接:FDE工程师解决的是企业里每一条具体业务线如何结合大模型、结合智能体完成真正落地的问题。无论行业是制造业、互联网、银行还是物流,职责本质相同——把某条业务线翻译成智能体能理解和执行的形式。
这也解释了为什么他把"让智能体理解企业业务"视为FDE最难的部分。技术组件的学习和组合是可复制的,但业务知识的获取、梳理和结构化,高度依赖与业务方的协作,而这恰恰是当前企业环境中最欠缺的一环。
FDE(Forward Deployed Engineer,前置部署工程师) 这一角色最早由Palantir等数据智能公司规模化采用,指的是被派驻到客户现场、直接嵌入业务团队工作的工程师。与只负责交付代码的传统工程师不同,FDE既要懂技术栈,又要深入理解客户的业务逻辑和行业约束,充当产品能力与客户场景之间的桥梁。在生成式AI落地场景中,FDE的职责进一步扩展为:梳理业务线知识、设计Agent的提示词与工具、搭建知识库、评估效果并持续迭代。这一角色之所以在大模型时代重新受到关注,是因为通用模型能力越强,最后一公里的业务适配反而越依赖人对场景的深度理解。
MCP(Model Context Protocol,模型上下文协议) 是由Anthropic提出并逐步被行业采纳的开放协议,用于标准化大模型应用与外部数据源、工具之间的连接方式。可以把它理解为Agent世界的“USB接口”:无论是数据库、CRM系统还是企业内部API,只要按MCP规范封装成服务端,Agent就能以统一方式发现和调用这些能力,而不必为每个系统单独写适配代码。在企业智能体架构中,MCP通常与知识库、记忆模块配合使用——知识库负责提供业务事实,MCP负责让Agent安全地执行查询、下单、工单流转等具体动作,二者共同支撑起从“理解业务”到“完成业务”的闭环。
对落地实践的三点启示
知识库建设要先行于Agent开发。 如果企业业务规则本身没有文字化,直接上智能体只会得到一个空转的系统。先把业务边界、处理规则、完整流程沉淀进LLM WIKI,Agent才有可依据的判断基础。
选择无文档的业务线做试点更能验证方案。 老肖刻意选择"没有形成任何文字"的订单客服场景,本质上是在压力测试LLM WIKI方法论的成色。企业在选试点时,不妨优先挑那些知识最隐性、最依赖老员工经验的业务线。
业务方的配合是工程问题,不是态度问题。 业务人员不配合的根源在于知识输出缺少机制和工具支撑。LLM WIKI这类方案如果能把知识沉淀的成本降下来,配合意愿的问题也会随之缓解。
这场分享的具体操作细节(知识库搭建步骤、Agent配置流程)在原始内容中尚未展开,但从问题定义和方法框架来看,它指向了一个明确的结论:企业AI落地的竞争,最终会落在业务知识结构化的能力上,而不是模型参数或框架选择。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。