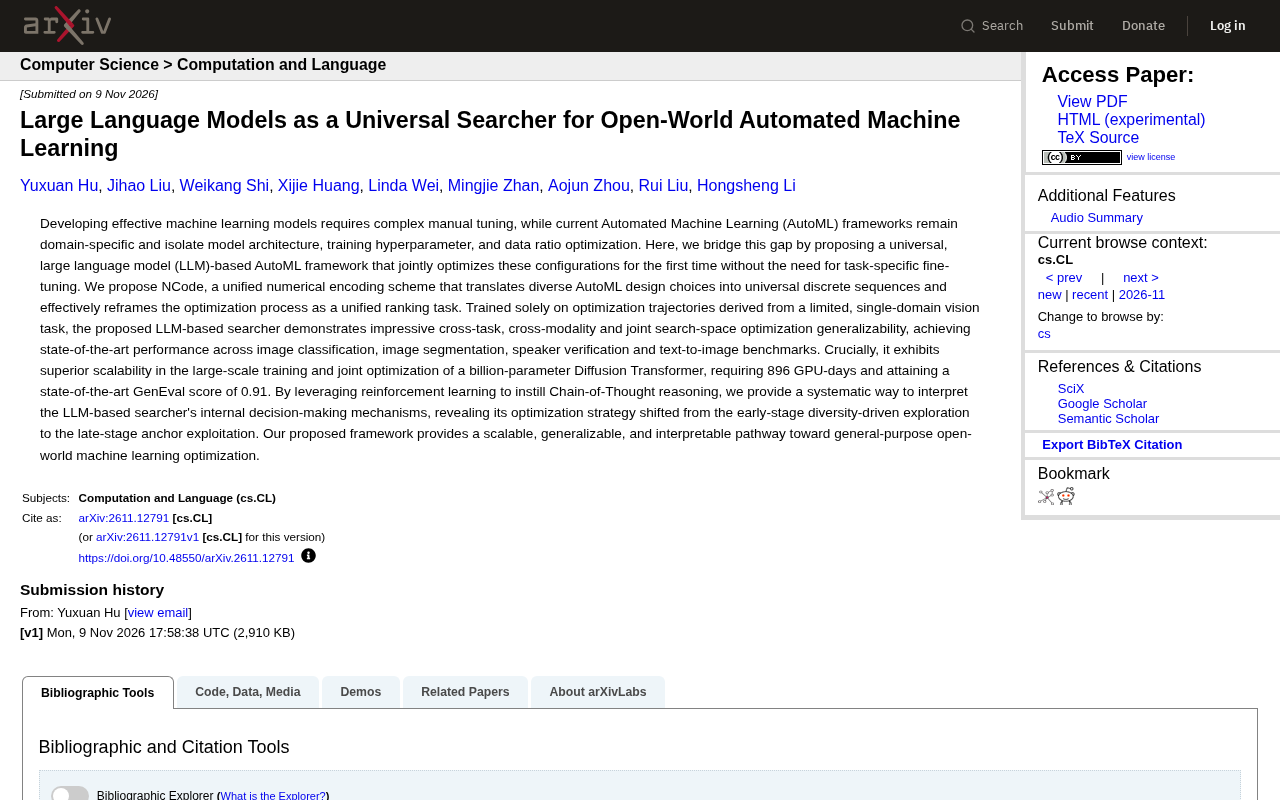
LLM 作为通用搜索器:无需微调的开放世界 AutoML

LLM 作通用搜索器,统一编码实现 AutoML 跨任务跨模态联合优化。
该研究提出 NCode 框架,用大型语言模型充当通用搜索器,通过统一的数值编码把模型架构、训练超参数和数据配比等异构设计选择转化为离散序列,并将 AutoML 优化重构为统一的排序任务,首次实现三者的联合优化。搜索器仅在单一视觉任务的优化轨迹上训练,却能在图像分类、图像分割、说话人验证和文本到图像等跨任务、跨模态基准上达到 SOTA,无需任务特定微调。研究还在十亿参数级 Diffusion Transformer 上完成大规模验证,消耗 896 GPU-days,GenEval 得分 0.91。通过强化学习注入思维链推理,作者揭示了搜索策略从早期多样性探索转向后期锚点利用的轨迹,为 AutoML 的碎片化问题提供了可扩展、可泛化且可解释的通用方案。
从领域专用到通用搜索:AutoML 的范式转变
传统 AutoML 框架长期受困于领域专用性——模型架构、训练超参数和数据配比往往被割裂优化,难以联合调优。近期一项研究提出以大型语言模型(LLM)作为通用搜索器,首次实现三者的联合优化,且无需针对特定任务微调。该方法名为 NCode,通过统一的数值编码将多样化的 AutoML 设计选择转化为离散序列,并把优化过程重构为统一的排序任务。
这一思路的核心价值在于:用一个在单一视觉任务优化轨迹上训练过的 LLM 搜索器,去应对图像分类、图像分割、说话人验证和文本到图像等跨任务、跨模态场景,并迁移到联合搜索空间。这打破了以往 AutoML 每换一个任务就要重新设计搜索空间和训练流程的惯例。
AutoML(Automated Machine Learning,自动化机器学习) 旨在将模型设计、超参数调优等需要人工反复试错的过程自动化。传统 AutoML 通常把问题拆成几个子问题分别处理:神经架构搜索(NAS)专注网络结构,超参数优化(HPO)专注学习率、批大小等训练参数,数据配比则另立一套流程。这种割裂带来两个后果:一是各子空间的搜索彼此独立,难以找到跨维度的最优组合;二是每换一个任务(如图像分类换成语音任务),搜索空间和搜索算法往往要重新设计,通用性差。该领域的早期方法依赖进化算法、贝叶斯优化或强化学习,搜索成本高且迁移能力有限。近年来,研究者开始尝试用预训练语言模型充当“通用搜索器”,把不同设计选择编码成同一序列,从而在单一框架内完成联合搜索,这正是文中 NCode 所代表的范式转变背景。
Diffusion Transformer(DiT) 是将 Transformer 架构引入扩散模型的生成模型结构,常用于文本到图像等任务:扩散过程负责从噪声逐步去噪生成图像,Transformer 则作为去噪网络的主干,替代了早期扩散模型常用的 U-Net。DiT 的参数量、层数、注意力配置等对生成质量影响显著,因此成为 AutoML 联合搜索的理想对象。文中提到的“十亿参数级”意味着搜索器要在极大的配置空间中做出决策,单次训练代价高昂,这也解释了为何 896 GPU-days 的搜索开销是评估该方法实用性的重要参照。
跨任务与跨模态的泛化能力
研究团队仅使用来自有限、单领域视觉任务的优化轨迹训练 LLM 搜索器。结果显示,该搜索器在图像分类、图像分割、说话人验证和文本到图像基准上均达到当前最优性能。这意味着搜索器学到的不是某个任务的特定技巧,而是一种可迁移的优化策略。
跨模态泛化尤其值得关注。说话人验证属于音频领域,文本到图像属于多模态生成领域,二者与训练所用的视觉任务差异显著。搜索器仍能有效工作,说明 NCode 的离散编码方案具备足够的通用性,能够将不同模态的设计选择映射到同一表示空间。
据原论文,该框架在多个基准上取得 state-of-the-art 性能,验证了其跨任务、跨模态和联合搜索空间优化的泛化能力。
十亿参数扩散 Transformer 的规模化验证
规模化能力是检验 AutoML 框架实用价值的关键。该研究将 LLM 搜索器应用于十亿参数级 Diffusion Transformer 的大规模训练与联合优化,消耗 896 GPU-days,最终在 GenEval 基准上取得 0.91 的最优分数。
这一结果的意义在于:搜索器不仅能处理小规模基准任务,还能在真实的大规模训练场景中做出有效的配置决策。896 GPU-days 的搜索成本本身也提示,通用搜索器的价值需要放在“替代人工调参”和“找到更优配置”的收益框架下衡量。
GenEval 是评估文本到图像生成模型指令遵循能力的基准,它把“生成是否符合文本描述”拆解为物体数量、颜色、空间关系、属性绑定等细粒度子任务,用自动化检测器打分而非依赖人工主观评价。因此 GenEval 分数能较客观地反映模型对复杂提示的忠实程度。文中 0.91 的分数是在该基准上取得的最优结果,说明通过 AutoML 联合优化得到的配置在生成质量与指令遵循上均有提升。理解这一指标有助于判断:搜索器带来的收益不仅是训练效率,也体现在下游生成任务的实质质量上。
强化学习与思维链带来的可解释性
AutoML 系统常被诟病为黑箱。该研究通过强化学习为搜索器注入思维链(Chain-of-Thought)推理能力,提供了系统化解读 LLM 搜索器内部决策机制的方式。
分析揭示了一条清晰的策略迁移轨迹:早期阶段以多样性驱动的探索为主,后期转向锚点利用(anchor exploitation)。这种从探索到利用的转变,符合优化搜索的一般直觉,但此前缺乏在 LLM 搜索器内部被显式观察和解释的证据。可解释性不仅增强信任,也为后续改进搜索策略提供了抓手。
思维链(Chain-of-Thought, CoT) 指让语言模型在给出结论前先输出中间推理步骤,从而提升复杂任务表现并暴露决策依据。在 AutoML 场景中,把 CoT 与强化学习结合,意味着搜索器每提出一个配置建议时,会先生成一段“为什么这样选”的推理文本,再据此排序候选方案。强化学习则通过最终性能反馈来优化这些推理与选择策略,使模型逐步学会更有效的搜索逻辑。文中观察到的“早期多样性探索、后期锚点利用”轨迹,正是从这些推理文本中被识别出来的,这也是该方法区别于传统黑箱 AutoML 的关键所在。
对开放世界机器学习的意义
该框架指向一条可扩展、可泛化且可解释的通用机器学习优化路径。其关键贡献可归纳为三点:
- 统一编码:NCode 将架构、超参数、数据配比等异构设计选择统一为离散序列,支持联合搜索。
- 零微调迁移:在单领域轨迹上训练的 LLM 搜索器,跨任务、跨模态直接生效。
- 可解释决策:强化学习加思维链,让搜索器的优化策略变得可观察。
当然,该方法目前仍处于研究阶段,896 GPU-days 的搜索开销、对 LLM 推理能力的依赖,以及更大规模任务上的表现边界,都是走向生产落地前需要回答的问题。但方向上,它为解决 AutoML 的碎片化问题提供了一个有说服力的通用方案。
相关推荐
Cursor、Devin、TRAE、Copilot价格怎么比?先算额度再比月费
横向对比Cursor、Devin Desktop、TRAE、Copilot四家AI编程工具的个人与团队定价,拆解额度规则、第三方模型是否含在月费、超额计费方式,并给出付费前测消耗、设支出上限和选型的实操方法。
Copilot下架三款模型:Pro用户替代选择只剩一个
GitHub Copilot 自 11 月 16 日起下架 Claude Opus 4.8、Claude Opus 5、GPT-5.6 Tera 三款模型,覆盖 Chat、代码补全与 Agent 模式。Pro 用户三个替代中仅剩 GPT-6 Luna 可用,年付 Legacy 计划拿不到 Opus 5.5,管理员需手动开启替代模型。

Gemini 4 Carbon登场:大模型竞赛进入百万上下文与万亿开源时代
谷歌发布Gemini 4 Carbon并推出多智能体工具Swarm,Anthropic推出百万上下文Fable 5.2与Mythos 5.2,OpenAI发布安全专版GPT-6 Cyber,Mistral与Kimi同步开源万亿参数模型,大模型竞赛全面提速。