LLM大模型零基础入门:从原理到实战的完整学习路径

一套LLM入门课程的学习地图:从五项基础到原理、训练与工程落地。
文章基于一套完整的LLM入门实战课程,梳理出从预备知识到工程部署的学习路径。首先强调学习前需补齐Python、数学、机器学习、PyTorch和深度学习五项基础;接着回顾大模型演进,拆解BERT编码器、GPT解码器与T5编码解码三条技术路线,说明2021年后行业因scaling law和生成范式统一性转向GPT;随后指出大模型本质是概率模型,涉及Tokenizer、嵌入层、Transformer与softmax;再详述预训练、SFT、奖励模型、RLHF四阶段训练,并解析Top-k、Top-p、Temperature等解码参数;最后介绍二期LangChain、Agent与面试实战内容,强调先补基础再落工程的执行路线。
大模型技术门槛高、知识体系庞杂,很多初学者面对Transformer、RLHF、LangChain等概念时不知从何下手。一套体系化的学习路径,能把零散的知识点串成可落地的能力。本文基于一套完整的LLM入门实战课程内容,梳理从预备知识、模型原理到应用部署的核心脉络,帮助读者建立清晰的学习地图。
课前预备:五块必须补齐的基础
课程明确列出了学习大模型前需要具备的五项基础。Python是首要条件——大模型研发、GitHub上的多数项目以及Transformer组件都用Python编写,无法读写代码几乎寸步难行。数学基础同样不可回避,课程提到会涉及softmax函数以及数学方面的内容,大模型本质上是统计模型,概率论是理解其运作的底层语言。
机器学习基础用于理解分类模型、生成式模型以及评估指标的计算方式。PyTorch则是实操层面的硬要求——虽然很多模型封装得很好,但一旦需要修改结构或理解网络细节,就必须能用PyTorch搭建Tensor和网络。最后是深度学习基础,与机器学习基础互补,偏重神经网络方向。课程建议学员根据自身情况针对性补齐,第三章和第四章会集中讲解理论部分。
大模型演进:从BERT到GPT的两条路线
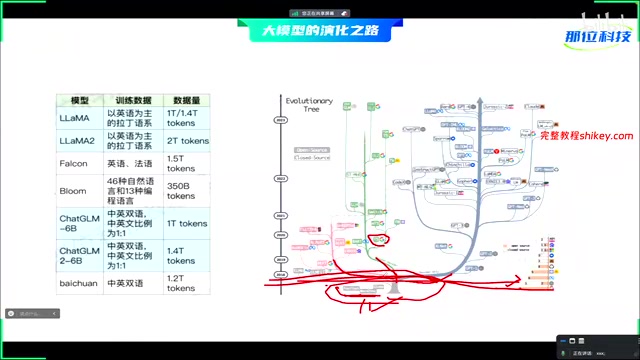
理解大模型的发展脉络,是面试和实战都绕不开的基础。课程将当前格局分为商业大模型与开源大模型两大阵营:商业侧有ChatGPT、Claude以及国内的千问、文心一言、讯飞星火、MiniMax等;开源侧则从早期的T5、Bloom,到Llama引发的开源浪潮,再到百川等后续模型。
更具洞察力的是对技术路线的拆解。2018年Transformer出现后,行业走出三条线:只用编码器的BERT路线、只用解码器的GPT路线,以及编码解码一起用的T5路线。BERT擅长自然语言理解(NLU),能双向看到上下文,在语义编码、搜索推荐等任务上表现出色,但每个任务都需要特定的下游网络设计,迁移成本高。GPT走解码器路线,早期在同等参数量下不如BERT,直到GPT-3参数量大幅提升后,scaling law开始显现威力,生成式方式的统一性优势凸显——任何任务都可以用生成范式解决。
课程用一张图概括了这个转折:2021年之前行业普遍选择BERT,2021年之后迅速转向GPT路线。当被问及为何走向两条不同路线时,可以从应用背景回答:参数量小时BERT更吃香,算力上来后GPT的解码器方式契合自回归生成场景,生态也更丰富。
编码器与解码器架构的差异
Transformer 原始结构由编码器和解码器两部分组成。编码器通过自注意力机制让每个位置同时看到序列中所有其他位置(双向上下文),擅长把输入压缩成富含语义的表示,因此适合分类、抽取、语义匹配等理解型任务。解码器则采用掩码自注意力,每个位置只能看到自己和之前的 token,天然适合从左到右逐词生成,这正是自回归语言模型的运行方式。BERT 只保留编码器,通过掩码语言建模(随机遮住部分词让模型猜)学习表示;GPT 只保留解码器,通过预测下一个词学习生成。T5 同时使用编码器和解码器,把各类任务统一成“文本到文本”的形式。理解这一结构差异,就能明白为什么 BERT 强于 NLU、GPT 强于生成,以及为什么下游任务需要为 BERT 单独设计分类头。
大模型的本质:一个概率模型
课程反复强调一个核心认知:大模型本质上是概率模型。给定一个词序列,模型计算的是这段文本出现的概率。概率高说明符合语言规律,概率低则说明生成质量差。这个目标函数可以写成条件概率的连乘形式,通过最大化似然估计来优化模型参数。
为了让这个概率可计算,大模型采用嵌入层将token映射为向量,叠加位置编码后输入Transformer块,经过多层隐藏层变换,最后通过softmax层输出词表上的概率分布。训练时用梯度下降更新权重,让模型输出的概率分布逼近真实语言的分布。
课程还解释了token的概念:它是分词后的子词单元,不同模型使用不同的Tokenizer(如BPE、SentencePiece),切分方式不同,词表大小也从数万到十几万不等。因此比较模型时,公平的角度是看它使用的Tokenizer而非单纯比词表大小。参数量与显存的关系也有实用公式:全精度下参数量乘以4,FP16下乘以2,例如6B模型全精度约需24GB显存,FP16则约12GB。
最大似然估计与交叉熵损失
文中提到的“最大化似然估计”是训练语言模型的核心目标。给定真实语料中的一个词序列,模型为每个位置输出词表上的概率分布,整段文本的概率就是各位置条件概率的连乘。最大似然估计就是调整参数,使训练语料中真实出现的序列概率尽可能高。由于连乘容易数值下溢,实践中取对数变成对数似然求和,再取负号就得到交叉熵损失——这也是 PyTorch 中 CrossEntropyLoss 直接计算的对象。因此在语言模型训练里,“最小化交叉熵”与“最大化似然”是同一件事的两种说法。理解了这一点,再看 SFT 只对输出部分计算 loss,就能明白它本质上是在只对答案 token 计算对数似然而已。
训练四阶段:预训练、SFT、奖励模型与强化学习
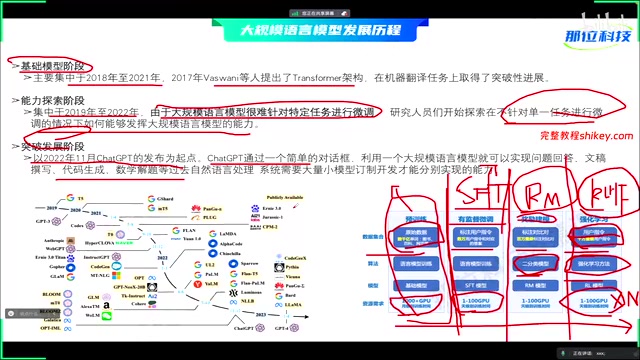
现代大模型的研发流程已从早期的“预训练+微调”演变为四个阶段。预训练阶段用海量数据训练基础模型,课程提到GPT-3使用了45TB数据(清洗后约700多GB)、1750亿参数,训练需要大规模GPU集群和数月时间。
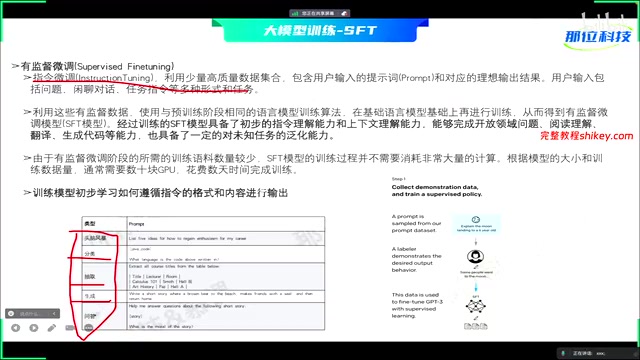
SFT(有监督微调)阶段让模型学会遵循指令。课程给出一个关键面试点:SFT训练时只计算输出部分的loss,输入部分不计入,目标是让答案尽可能符合规范。SFT数据常见类型包括头脑风暴、分类、抽取、生成和问答。另一个高频问题是灾难性遗忘——微调会覆盖预训练学到的知识,缓解方法包括混合预训练数据训练、以及将预训练loss与下游loss加权叠加。
奖励模型(RM)阶段解决“生成的东西好不好”的问题。对同一个问题生成多个答案,人工排序后训练奖励模型学习人类偏好。课程指出RM的数据构造方式包括打分和两两排序,其质量直接影响后续强化学习的效果,但排序偏好过强也会削弱模型的创造性。
RLHF/PPO阶段将SFT模型与奖励模型整合,用奖励模型的打分通过PPO优化SFT参数,同时加入KL散度约束防止模型偏离太远。课程坦言强化学习训练难度大,但PPO、TRL等工具已封装得较好,可以较快上手。
KL 散度约束的作用
RLHF 阶段提到的 KL 散度是衡量两个概率分布差异的指标,取值范围从 0 开始,完全相同时为 0。在 PPO 训练中,优化目标是让模型获得更高奖励,但奖励模型只是人类偏好的近似,模型可能找到“刷高分”的捷径,生成奖励高却怪异、重复或偏离语言常理的文本,这就是奖励黑客(reward hacking)。加入 KL 惩罚项,就是约束当前策略模型与 SFT 参考模型的输出分布不要偏离太远,相当于给优化加了一条“别跑偏”的缰绳。KL 系数越大越保守、越接近 SFT 模型,越小则越激进、越容易迎合奖励模型。理解这一项,就能解释为什么 RLHF 后的模型既能提升有用性,又不至于丧失原有的语言能力。
解码策略:Top-k、Top-p与Temperature
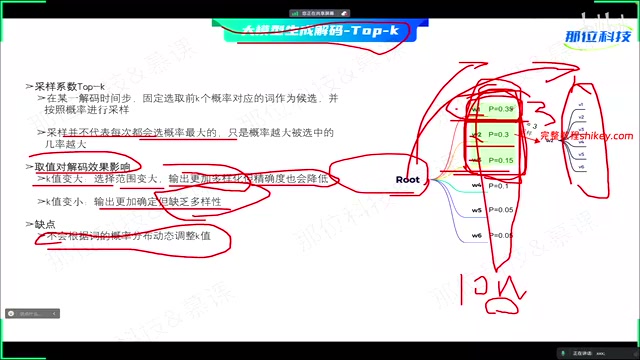
模型输出概率分布后,如何选择下一个词是部署和面试中的高频考点。Top-k限制候选词为概率最高的k个,k越小输出越确定但缺乏多样性,k越大越多样但可能引入低概率词;缺点是k值固定,不能根据概率分布动态调整。Top-p(核采样)按累积概率划定候选范围,每一步动态选择,解决了Top-k固定的问题。实际代码中通常先应用Top-k再应用Top-p。
Temperature则改变概率分布的缩放:温度接近0时模型趋于选择最高概率词,输出保守但容易重复;温度升高则分布更平坦,多样性提升但可能牺牲连贯性。课程给出的经验是应用场景中普遍取值在0.2到1左右,需要多样性时可适当调高。
贪心搜索与束搜索
Top-k、Top-p 和 Temperature 都属于随机采样策略,与它们相对的是确定性搜索方法。贪心搜索每一步直接选概率最高的词,实现简单、速度快,但容易陷入局部最优,生成重复、单调的文本。束搜索(beam search)同时保留若干条候选序列,每一步扩展后按累计概率保留前 beam 条,能在一定程度上找到整体概率更高的输出,常用于机器翻译等对准确性要求高的任务。但束搜索倾向于生成安全、平庸的文本,在开放式对话中反而显得呆板。因此聊天类应用多采用带温度与 Top-p 的采样,而摘要、翻译等任务更常用束搜索。理解这几类方法的取舍,才能解释为什么同一个模型换一种解码方式,输出风格会截然不同。
二期升级:LangChain、Agent与面试实战
课程提到二期内容“加量不加价”,一期学员可免费学习。二期重点补充PyTorch算子基础、LangChain在Agent和行业问答中的实战应用,以及大模型面试经验分享。实战部分覆盖数据采集与清洗、切片与向量化召回、Prompt拼接、项目部署上线与日志监控,使用Flask等工具完成模型上线和运维。对转行或求职的学员来说,这条从理论到项目的链路是接触大模型行业最直接的路径。
整体来看,这套课程的价值在于把碎片化的知识点组织成一条可执行的学习路线:先补基础,再理解原理,最后落到工程实践。对零基础学习者而言,耐住性子啃完前两章的基础储备,后面的代码实战才会真正顺理成章。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。