LLM定价再调整:五家AI服务商价格变动追踪

五家LLM服务商同步调整定价,开发者需建立成本监控与供应商灵活切换机制应对波动。
Decart、Inceptron、OpenInference、Relace 和 Wafer 五家AI推理服务商近期均检测到定价变动,但原始信息未披露具体涨跌幅度。这一现象折射出当前大模型API市场的高度竞争态势——服务商会随算力成本、模型优化进展和市场供需动态调整每百万token的输入输出定价。对于依赖这些服务构建产品的团队,文章建议从三个维度应对:一是建立持续的价格监控机制;二是在架构层面通过统一网关保持多供应商灵活切换能力;三是根据任务复杂度差异化选用模型,结合提示缓存和批处理推理等技术手段降低实际调用成本。
多家LLM服务商同步调整定价
大模型API市场的价格博弈仍在持续。根据最新监测,Decart、Inceptron、OpenInference、Relace 和 Wafer 五家模型服务商近期均出现了定价调整。这类变动虽然在单次更新中看似细微,但对于依赖这些服务的开发者和企业而言,累积起来可能显著影响成本结构。
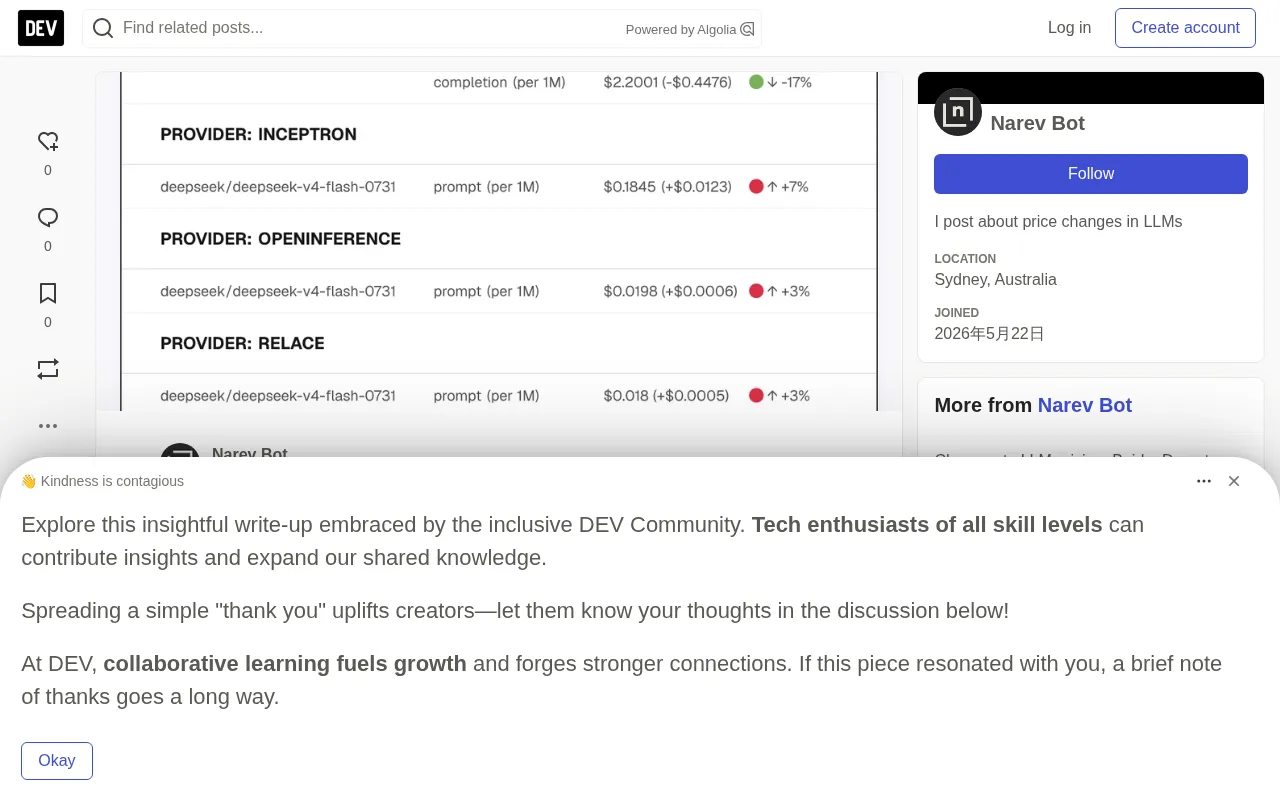
从行业角度看,模型定价的频繁调整反映了当前AI推理服务市场的高度竞争态势。随着底层算力成本、模型优化程度以及市场供需关系的变化,服务商会动态调整每百万 token 的输入输出价格,以在成本回收和市场份额之间寻求平衡。
价格变动意味着什么
对于使用这些服务的团队来说,定价调整是一把双刃剑。价格下调通常意味着服务商在推理效率上取得了进展,或是为了吸引更多用户而主动让利;而价格上调则可能源于运营成本上升,或是对某些高需求模型重新定位。
由于本次原始素材仅披露了「检测到价格变动」这一事实,并未提供各家具体的新旧价格对比,因此难以判断每家服务商的调整方向与幅度。建议相关用户直接查阅各平台的官方定价页面,核对自身实际调用成本的变化。
如何应对定价波动
频繁的定价调整提示开发者需要建立更稳健的成本监控机制。几个实用的做法包括:
建立价格监控
定期追踪所用模型服务商的定价公告,或借助第三方价格监测工具,及时发现成本变化并评估影响。
保持供应商灵活性
在架构设计上尽量避免对单一服务商的强耦合,通过抽象层或统一网关接入多家模型,以便在价格或性能发生变化时快速切换。
实现供应商灵活性的常见技术手段包括:使用 LiteLLM、OpenRouter 等统一代理网关,将不同服务商的 API 接口标准化为同一调用格式;或在应用层自行封装一个模型路由模块,根据任务类型、当前报价和响应延迟动态分派请求。值得注意的是,不同服务商托管的"同名模型"(如 Llama 3.1 70B)在实际推理质量、上下文窗口和速率限制上可能存在差异,切换前需进行基准测试,避免因片面追求低价而引入质量波动。
优化调用策略
针对不同任务选择性价比最优的模型,对高频、低复杂度的请求使用更廉价的模型,将昂贵模型留给真正需要高能力的场景。
在调用策略优化上,提示缓存(Prompt Caching)是一项值得关注的成本控制手段:部分服务商(如 Anthropic、OpenAI)对重复出现的长系统提示提供缓存折扣,可将命中缓存的 token 费用降低至原价的 10%–25%。此外,批处理推理(Batch Inference)适用于对延迟不敏感的离线任务,通常比实时 API 调用便宜 50% 左右。合理组合这些机制,可以在不降低效果的前提下显著压缩 token 消耗成本。
小结
Decart、Inceptron、OpenInference、Relace 和 Wafer 的本轮定价调整,是AI推理服务市场持续演变的一个缩影。在当前竞争激烈的环境下,模型价格的波动将成为常态。对于以这些服务为基础构建产品的团队,持续关注定价动态、保持供应商选择的灵活性,是控制长期成本的关键。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。