LLM评审结果为何反复横跳?拆解LLM-as-Judge的稳定性陷阱
LLM评审结果天然不稳定,多条标准串联会指数级放大噪声,需通过任务拆分与多次采样来系统性压制。
本文以一个真实案例为切入点:开发者用LLM对同一批数据重复评审,结果却每次不同。文章系统分析了根本原因:temperature=0加固定seed并不能保证输出确定性,推理后端的浮点并行与批处理调度会引入不可消除的随机性;主观模糊的评审标准本质上接近随机判断;单提示词内多条标准共享注意力上下文,会相互干扰;而「全部通过」的汇总逻辑会把多个略带噪声的检查通过概率连乘,将整体正确率从95%级别压缩到60%级别。针对这些问题,文章提出了拆分任务、多次采样投票、客观化标准定义、重新设计汇总逻辑等改进方向,并指出LLM输出本质是概率分布而非确定性布尔值,这一张力是评审管线设计的核心挑战。
问题现场:同样的输入,分数却在跳动
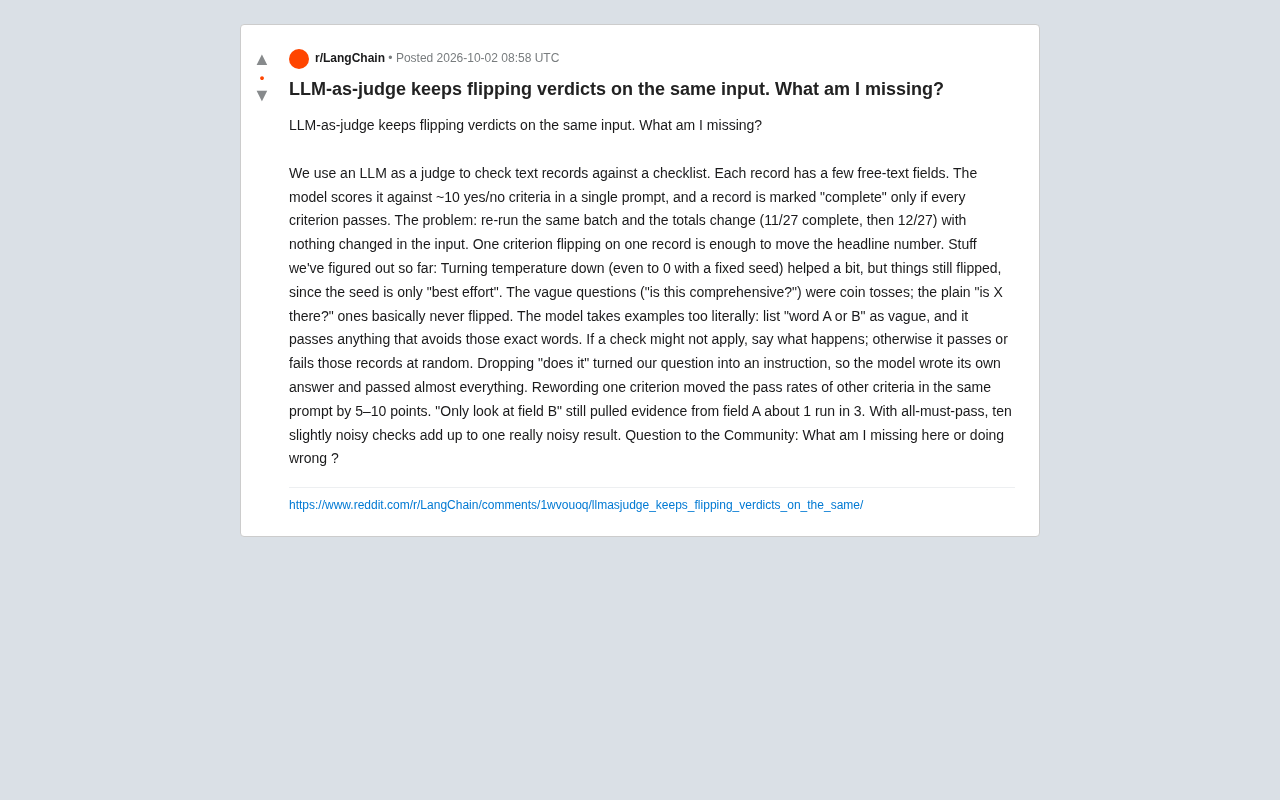
一位开发者在 Reddit 上抛出了许多 LLM-as-judge(用大模型充当评审官)实践者都会遇到的头疼问题:用 LLM 对照一份清单检查文本记录,每条记录包含若干自由文本字段,模型在一个提示词里针对约 10 条 yes/no 标准打分,只有全部通过才标记为「完成」。
结果是,重新跑一遍同一批数据,总数就变了——第一次 11/27 通过,第二次变成 12/27,输入没有任何改动。只要某一条记录上的某一项标准翻转,头部指标就会跟着变动。这个案例几乎是 LLM 评审落地中「不可复现性」的教科书式样本。
从实践中摸索出的规律
原帖作者已经做了不少排查,这些观察本身就很有价值:
温度与随机种子只能缓解,无法根治。 把 temperature 调到 0 并固定 seed 确实改善了一些,但结果依然会翻转。原因在于很多推理后端的 seed 只是「尽力而为」(best effort),浮点运算顺序、批处理调度、硬件差异都可能引入非确定性。换句话说,temperature=0 并不等于确定性输出。
模糊的问题就是在掷硬币。 像「这段内容是否全面(comprehensive)?」这类主观判断几乎是随机的,而「X 是否存在?」这种事实性检查基本不翻转。这揭示了一个核心矛盾:评审标准的客观性决定了结果的稳定性。
模型会过度字面化地理解示例。 作者把「word A or B」作为模糊措辞的例子列出,结果模型只要文本避开了这两个确切词,就一律判为通过。示例在提示词里会被当成硬规则,而不是参考语义。
提示词措辞的连锁反应
更微妙的发现是,措辞的细节会产生意想不到的后果:
- 把疑问句里的「does it」去掉,问题就变成了指令,模型干脆自己写答案,然后几乎全部判为通过。
- 重写其中一条标准,竟然让同一提示词里其他标准的通过率波动了 5–10 个百分点。
- 明明写了「只看字段 B」,模型仍有大约三分之一的概率从字段 A 里抽取证据。
这些现象说明,单个提示词内的多项任务会相互干扰——模型并非独立评估每一条标准,而是在一个共享的注意力上下文里做整体判断。
温度参数与确定性的关系值得深入理解。 temperature 控制的是模型采样时概率分布的「平坦程度」:设为 0 意味着每次都选取概率最高的 token(贪心解码),理论上应产生完全相同的输出。然而实际推理系统中存在多个非确定性来源:GPU 浮点运算的并行规约顺序、CUDA 内核的非确定性、动态批处理(dynamic batching)将多个请求合并计算时改变的数值精度,以及某些服务商在负载均衡时将请求路由至不同硬件节点。seed 参数只能固定模型侧的随机数生成器,无法控制这些底层因素。这也是为什么 OpenAI、Anthropic 等主流服务商在文档中明确标注 seed 的确定性保证为「best effort」而非严格保证——即便参数完全一致,跨调用的输出仍可能在边界概率的 token 处产生分歧。
为什么「全部通过」会放大噪声
原帖最后点出的那句话值得所有做评审管线的人记住:「十个略带噪声的检查叠加起来,就是一个噪声极大的结果。」
这是一个概率问题。假设每条标准单独判断的准确率是 95%,看起来已经很高。但在「全部必须通过」(all-must-pass)的逻辑下,一条记录整体正确的概率约为 0.95 的 10 次方,大约只有 60%。噪声在串联时会被成倍放大,而「完成率」这个头部指标恰恰是最脆弱的汇总形式。
这也解释了为什么作者看到的翻转总是发生在临界边缘:只要有一两条记录卡在 9/10 和 10/10 之间来回摇摆,总数就会跳动。
这一现象在可靠性工程中有对应的概念:串联系统的可靠性。当 n 个独立组件必须全部正常工作时,系统整体可靠性等于各组件可靠性的连乘积。这与软件测试中「测试套件的脆弱性随用例数量增加而指数上升」是同一规律。在 LLM 评审场景下,问题还会被进一步放大——各条标准并非真正独立(它们共享同一上下文窗口,存在注意力层面的耦合),意味着实际噪声往往比独立假设下的理论值更高。统计上,这类评估结果更适合用置信区间而非点估计来表达:报告「通过率在 38%–52% 之间(95% 置信区间)」远比报告「11/27」更诚实,也更有助于下游决策者判断结论是否可信。
可行的改进方向
结合原帖的观察,这类问题通常有几条值得尝试的路径:
拆分而非合并。 把 10 条标准拆成独立的提示词调用,消除标准之间的相互干扰。虽然成本更高,但能显著降低交叉污染。
只保留可客观验证的标准。 把「是否全面」这类主观题要么重新定义为可量化的事实检查,要么单独标注为低置信度维度,不让它拖累整体判定。
用多次采样做投票。 既然单次输出不稳定,那就对同一记录跑 3–5 次,用多数投票(majority voting)决定结果。这是对抗 LLM 评审噪声最实用的工程手段之一。
重新设计汇总逻辑。 「全部通过」过于严苛且脆弱。可以考虑加权评分、允许少量未通过,或者给出置信区间而非一个硬性的完成数。
示例要给语义而非字面。 在提示词中说明示例是「这类问题的代表」,并提供正反两面样本,避免模型把示例词当成唯一判据。
多次采样投票(majority voting)的工程实现有几个值得注意的细节。首先,采样次数通常取奇数(3、5、7),以避免平票;其次,每次调用应独立发起(而非复用同一会话上下文),以确保采样独立性。更进一步的做法是自洽性提示(self-consistency prompting):让模型在给出判断前先输出推理链(chain-of-thought),再从多条推理路径中汇总最终答案——研究表明这比直接多数投票在边界案例上的稳定性更高。对于成本敏感的场景,也可以采用级联策略:先用单次调用过滤掉置信度极高的明确通过/明确失败案例,只对落在不确定区间的记录执行多次采样,从而在精度和成本之间取得平衡。
写在最后
这个案例的价值在于,它并不是某个 bug,而是 LLM 作为评审工具的固有特性:语言模型的输出本质上是概率分布,而评审任务却期望得到确定性的布尔结果。 这两者之间的张力无法靠单一参数消除,只能通过任务拆解、多次采样、客观化标准和稳健的汇总设计来系统性地压制噪声。
对于任何正在搭建自动化评估管线的团队,这都是一个清醒的提醒:在相信 LLM 评审的数字之前,先测一测它对同一输入的可复现性。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。