LLM为何接受泛化陈述?心理语言学因素揭示模型判断机制

研究发现LLM判断泛化陈述时似人地权衡常见性与区分度,但更依赖事实真实性。
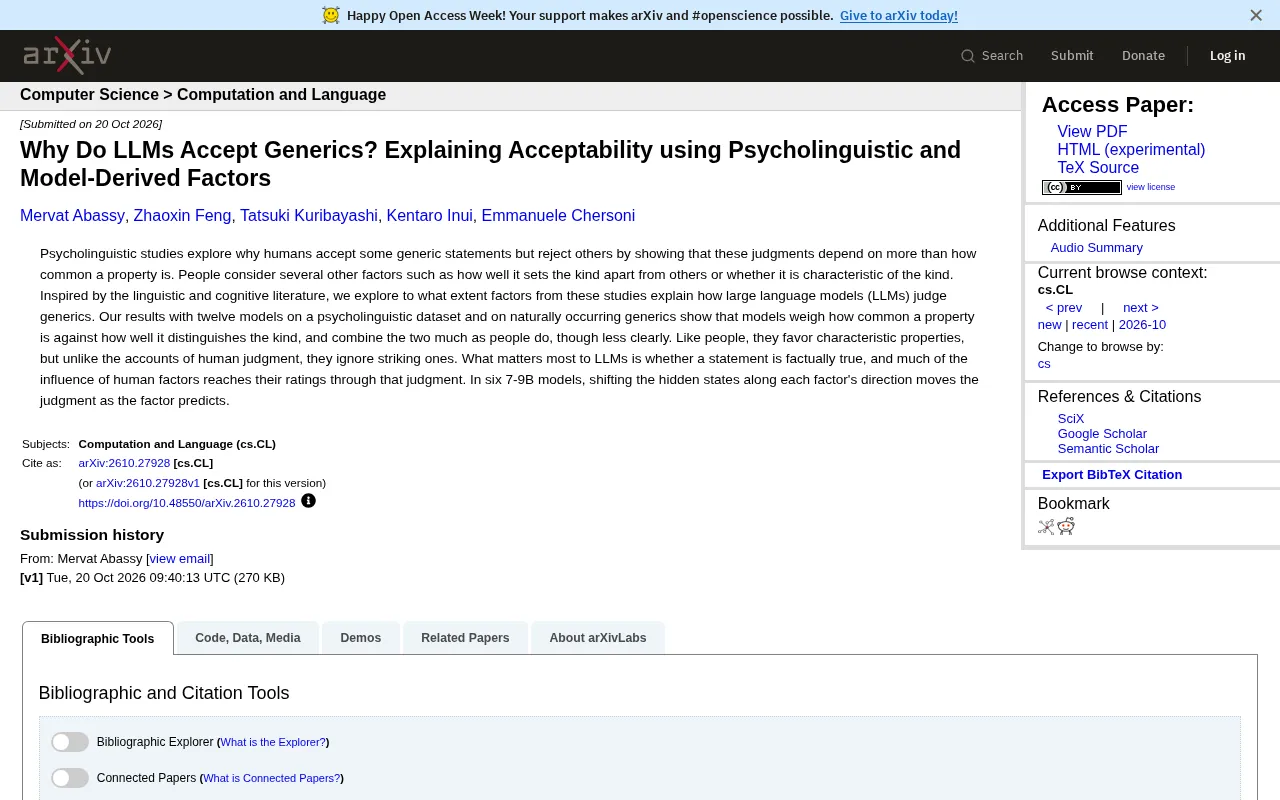
该研究受心理语言学启发,用心理语言学数据集和自然语料中的泛化陈述测试了12个模型,考察LLM如何判断“狗是忠诚的”这类泛化陈述的接受度。结果显示,LLM会权衡属性的常见性与区分度,并以类似人类的方式组合二者,也偏好特征性属性,但组合清晰度低于人类,且忽略了人类判断中的“引人注目”(strikingness)因素。更关键的是,对模型而言最重要的因素是陈述是否事实为真,人类因素的许多影响实际通过这一真值判断间接传导。研究还在六个7-9B模型上通过隐藏状态操控实验提供了因果证据,表明这些因素确实在模型内部被编码并驱动判断。
引言:泛化陈述的接受性谜题
“狗是忠诚的”和“狗是四足的”都是泛化陈述(generic statements),但人们普遍接受前者而质疑后者。心理语言学研究表明,人类对泛化陈述的接受度并非仅取决于属性是否常见——人们还会考虑该属性是否能把一类事物与其他类区分开,以及它是否是该类的特征属性。那么,大型语言模型(LLM)在判断泛化陈述时,是否也遵循类似的认知逻辑?
一篇受语言学和认知文献启发的研究,用心理语言学数据集和自然语料中的泛化陈述测试了12个模型,试图回答这个问题。研究发现,LLM确实会权衡属性的常见程度与区分度,并以类似人类的方式组合二者,尽管这种组合不如人类清晰。
人类判断泛化陈述的三重逻辑
心理语言学领域对泛化陈述的研究揭示了一个关键事实:人们对泛化陈述的接受度,不能简单用“属性有多常见”来解释。例如,“狮子有四条腿”在事实上为真且属性常见,但人们更倾向于接受“狮子是凶猛的”这类能刻画类别本质的陈述。
具体而言,人类判断依赖至少三类因素:
- 常见性(prevalence):该属性在类别成员中出现的频率。
- 区分度(distinctiveness):该属性将此类事物与其他类区分开的程度。
- 特征性(characteristicness):该属性是否被视为该类别的典型特征。
此外,研究还提到“ strikingness ”——属性是否引人注目——也会影响人类判断。这些因素共同作用,使得人类对泛化陈述的接受呈现出超越统计频率的复杂模式。
泛化陈述(generic statements) 是语言学与心理语言学中的核心概念,指不借助“所有”“大多数”等量化词、却表达类属层面规律的句子,如“狗是忠诚的”“鸟会飞”。与全称量化句不同,泛化陈述允许例外(并非每只狗都忠诚),其语义因此难以用真值条件简单刻画。心理语言学由此转向研究接受度:人们为何接受某些泛化陈述而拒斥另一些。经典解释包括基于认知概率的模型(属性在类别中的出现频率)和基于本质主义的模型(属性是否被视为类别本质)。这一议题对LLM研究尤为关键,因为模型没有真实世界经验,只能从语料统计中习得对泛化陈述的“直觉”,比较二者有助于揭示类人语义判断背后的不同计算基础。
LLM的接受性判断:像人但更“务实”
研究团队用心理语言学数据集和自然发生的泛化陈述测试了12个模型。核心发现是:LLM会权衡属性的常见程度与区分度,并将两者结合起来——这与人类的做法相似,但组合的清晰度较低。
与人类一致的是,模型也偏好特征性属性。然而,与人类判断理论不同的是,模型忽略了“引人注目”这一因素。换句话说,一个属性是否足够 striking ,并不影响模型的接受度判断。
更关键的差异在于:对LLM而言,最重要的因素是陈述是否事实为真。人类因素(常见性、区分度、特征性)的许多影响,实际上是通过“事实真实性”这一判断间接传导到模型评分中的。这意味着模型可能先评估陈述的真假,再在此基础上叠加其他考量。
这一发现暗示,LLM的泛化陈述判断机制与人类存在结构性差异:人类可能并行处理多种线索,而模型更依赖一个核心的真值判断作为中介。
因果验证:隐藏状态操控实验
为了验证这些因素是否真的在模型中起因果作用,研究者在六个7-9B参数规模的模型上进行了隐藏状态操控实验。具体做法是:沿着每个因素对应的方向移动隐藏状态,观察模型判断是否如因素所预测的那样发生变化。
结果显示,这种操控确实能改变模型判断,且方向与因素预期一致。这为“模型内部编码了这些心理语言学因素”提供了因果证据,而不仅仅是相关性观察。
这一实验设计的意义在于:它超越了“模型输出与人类评分相关”的表层分析,直接干预模型内部表示,从而更有力地说明哪些因素在驱动判断。
隐藏状态操控(hidden state steering) 是机制可解释性研究中的一类因果干预方法。其基本思路是:先在模型的隐藏表示空间中定位某个概念或因素对应的方向(通常通过对比不同输入得到的表示差异,或训练线性探针来估计),再在推理时沿该方向加上或减去一个向量,从而放大或抑制该因素的编码强度,最后观察模型输出是否随之系统性地变化。与只报告输出与人类评分相关性的观察性分析相比,这种干预能提供因果证据:若沿“常见性”方向移动表示会按预期改变接受度评分,就说明该因素在模型内部被显式编码并参与判断,而不仅是与结果偶然共变。这一范式已被广泛用于情绪、真实性、拒绝行为等概念的研究。
对LLM认知建模的启示
这项研究的意义不止于泛化陈述本身。它展示了一种研究范式:用心理语言学的理论框架和实验方法,去解剖LLM的判断机制,并用因果干预验证因素的作用。
从结果看,LLM并非简单地复制人类判断。它们共享部分因素(常见性、区分度、特征性),但权重分配不同,且缺失某些因素(strikingness)。同时,模型对事实真实性的高度依赖,可能反映了训练目标(如事实性奖励)对判断过程的塑造。
对于关注LLM认知能力的开发者和研究者,这提示我们:模型在语义判断任务上表现出的“类人”行为,可能建立在不同于人类的内部计算基础上。理解这些差异,对于构建更可靠、更可解释的模型挺重要的。
结语
LLM接受泛化陈述的理由,既有与人类相通之处——权衡常见性与区分度、偏好特征属性——也有明显分歧:忽略 strikingness,且以事实真实性作为核心中介。隐藏状态操控实验进一步证实了这些因素的因果作用。这项研究为LLM的认知机制提供了细粒度的心理语言学剖析,也提醒我们,模型的“类人”判断背后可能是一套不同的计算逻辑。
相关推荐
AI工程师的职责变了:从写代码到构建智能体工厂
Arize AI的Aparna Dhinakaran在AI Engineer大会分享AI工程师角色转变:从写功能到构建智能体循环,详解Signal始终在线智能体的触发、沙箱、记忆与评估器评估机制,以及追踪一切的数据飞轮。
CrowdGPT:去中心化协作训练LLM的野心与挑战
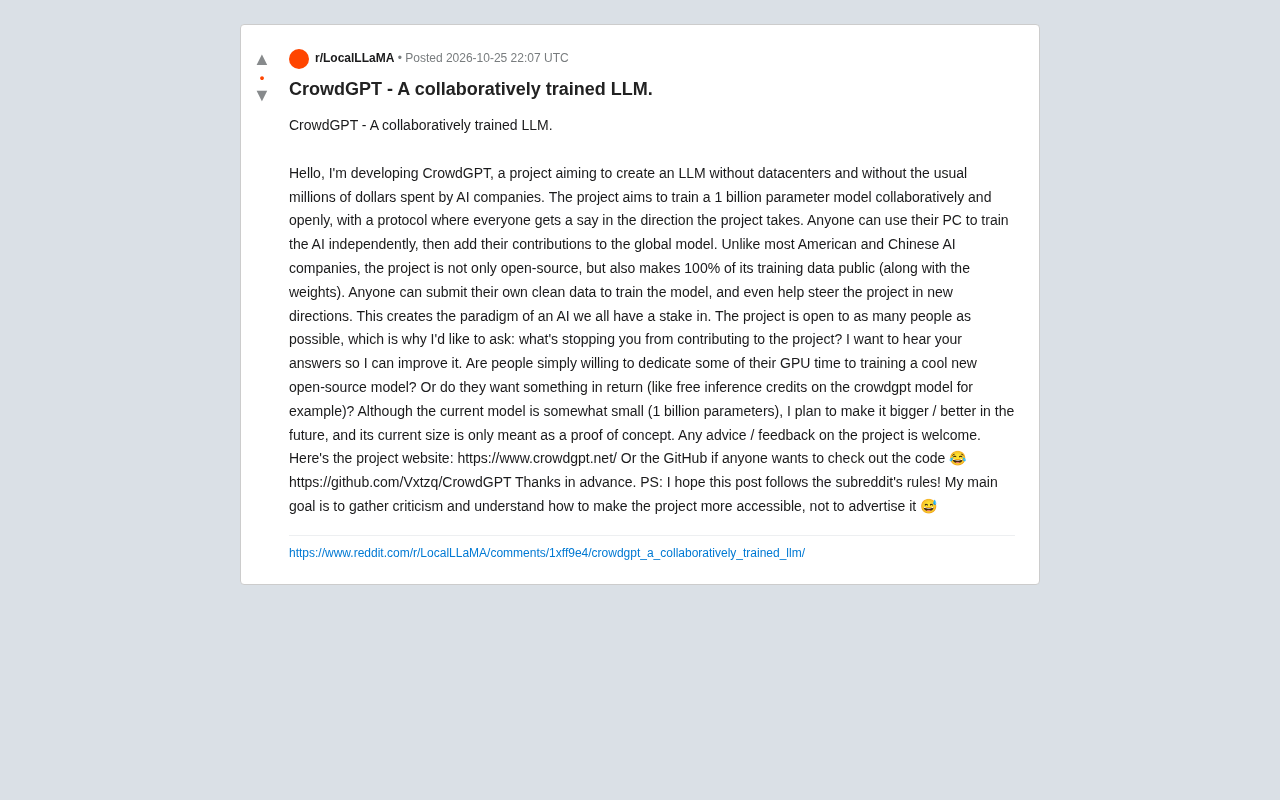
CrowdGPT项目试图通过全球志愿者协作训练10亿参数开源LLM,公开全部训练数据和权重。本文分析其去中心化训练模式的技术挑战、社区激励机制及与主流开源模型的差异。
Apollo报告:AI在科技业外“零财务回报”
Apollo研究指出AI在科技行业之外尚未带来可量化的财务回报。本文分析资本开支与收益错配、组织变革滞后、财务计量盲区三大原因,并探讨对企业和AI从业者的启示。