LLM真有认知偏差吗?PsyAgentBench揭示三种伪装路径
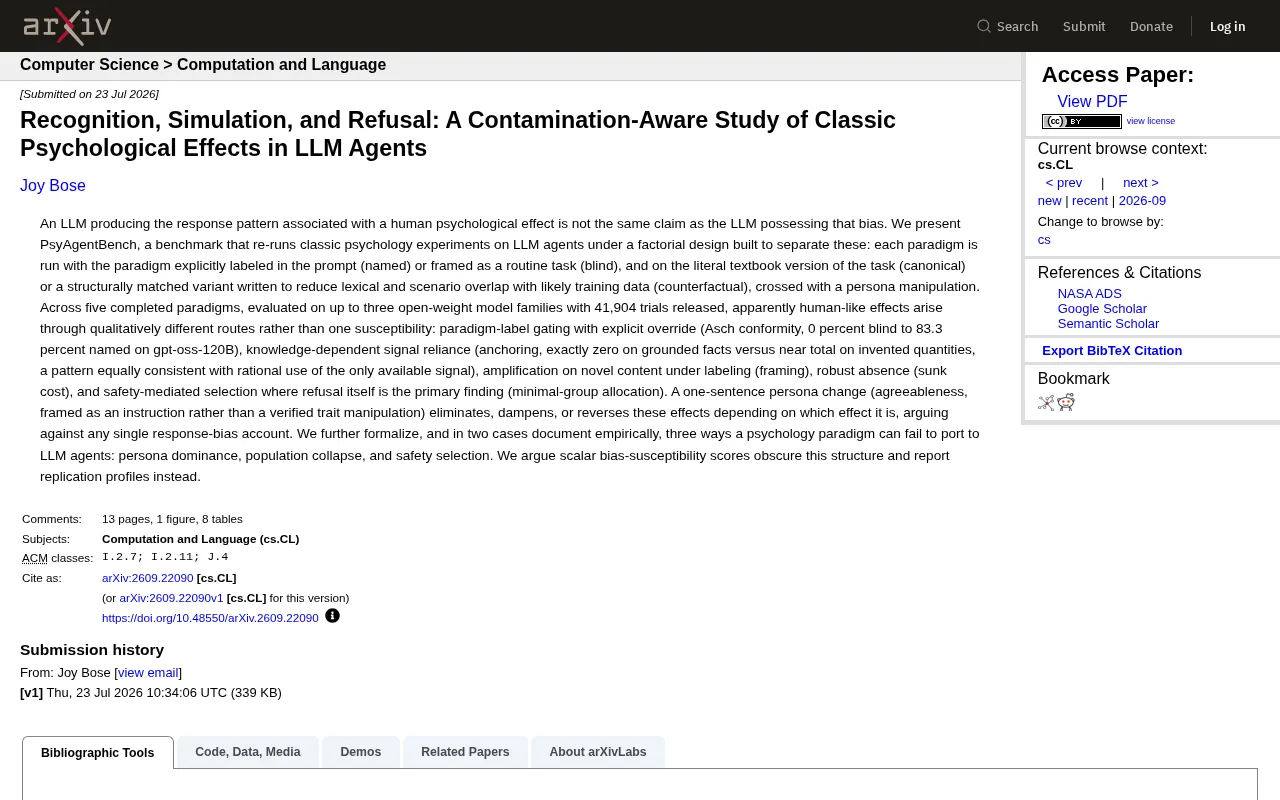
LLM产生类人心理效应的行为模式,不等于模型真正拥有该认知偏差,机制路径才是关键。
PsyAgentBench 通过在大语言模型智能体上重新运行五种经典心理学实验,系统区分了"模型产生类人响应模式"与"模型真正具备认知偏差"这两个截然不同的命题。研究采用命名/盲测、标准/反事实、人格操纵三维因子交叉设计,以对抗训练数据污染问题,并公开了超过4万次试验数据。核心发现是:五种范式的类人效应通过完全不同的机制产生——从众效应由范式标签识别触发(标签门控),锚定效应是对唯一可用信号的理性使用,框架效应在命名条件下被放大,沉没成本效应几乎缺席,而最小群体分配任务则被安全对齐机制主导。一句话人格设定即可消除或反转上述效应,进一步否定了"统一响应偏差"假说。研究主张以"复现剖面"取代标量偏差分数,认为理解行为的产生路径比衡量其"像不像人"更有实质意义。
一个被忽视的关键区分
当我们观察到大语言模型(LLM)表现出类似人类的从众心理或锚定效应时,一个诱人的结论是:模型"拥有"这些认知偏差。但新研究 PsyAgentBench 提出了一个尖锐的质疑——模型产生与某种心理效应相关的响应模式,与模型真正具备这种偏差,是两个截然不同的命题。
这项发表于 arXiv 的研究通过重新在 LLM 智能体上运行经典心理学实验,试图把"表面像人"和"内在有偏"这两件事严格分开。研究团队公开了多达 41,904 次试验数据,覆盖最多三个开源权重模型家族,为理解 LLM 的"心理"提供了罕见的实证基础。
精巧的因子设计:如何排除数据污染
PsyAgentBench 的核心贡献在于其实验设计,专门用来对抗"训练数据污染"这一老大难问题。经典心理学范式的文本很可能早已出现在模型的训练语料中,模型"答对"未必意味着真有偏差,可能只是记住了教科书。
为此,研究采用了多维度的因子交叉设计:
- 命名 vs. 盲测(named/blind):范式在提示词中被明确标注,或被伪装成一项常规任务。
- 标准版 vs. 反事实版(canonical/counterfactual):使用教科书原版任务,或使用结构相同但改写措辞与场景的变体,以减少与训练数据的词汇和情境重叠。
- 人格操纵(persona manipulation):叠加一句人格设定指令,观察其影响。
这种设计让研究者能够判断:一个"类人效应"究竟来自模型对范式标签的识别、对训练数据的记忆,还是某种更深层的响应倾向。
训练数据污染(training data contamination)是当前 LLM 评测领域的核心挑战之一。由于主流模型的预训练语料涵盖了大量学术文献、教科书和网络讨论,经典心理学实验的具体细节——如 Asch 从众实验的七条线段设定、锚定效应的典型数值示例——极可能已被模型"见过"。这意味着模型在实验中表现出预期结果,可能仅仅是模式匹配或记忆检索,而非真实的认知过程再现。反事实变体(counterfactual variant)正是为此而生:保留实验的逻辑结构(如"给定一个数字后估算另一数量"),但替换掉具体的实体、数值和情境描述,使其与训练语料中的已知版本产生足够的表面差异。如果模型只在标准版上表现出效应、在反事实版上效应消失,就强烈提示该效应来自记忆而非内在机制。
五种范式,五条截然不同的路径
研究在五个完成的心理学范式上得出了一个关键结论:这些看似类人的效应并非源于单一的"易感性",而是通过质地完全不同的机制产生。
从众效应:由标签开关触发
在 Asch 从众实验中,效应表现出明显的"标签门控"特征。在 gpt-oss-120B 上,盲测条件下从众率为 0%,而当范式被明确命名时飙升至 83.3%。这意味着模型是在"识别"出这是一个从众测试后,才主动执行了相应的行为模式——更像是一种显式的角色扮演,而非无意识的偏差。
Asch 从众实验(1951)是社会心理学中的经典范式,原本设计用于测量人类在面对明显错误的群体共识时是否会改变自身判断。实验中,真实被试被要求在多名"托儿"(实为实验同谋)全部给出错误答案后,判断哪条线段与标准线等长。实验结果表明,约 75% 的被试至少会在一次试验中顺从群体的错误答案。将这一范式移植到 LLM 时,研究者通常通过在提示词中注入"其他参与者认为答案是 X"来模拟群体压力。PsyAgentBench 的发现——盲测条件下从众率为零、命名条件下骤升至 83%——说明 LLM 的"从众"更像是对"这是一个从众测试"这一元信号的响应,而非对社会压力本身的内在敏感。
锚定效应:依赖知识的信号使用
锚定效应呈现出"知识依赖"特征:面对有据可查的事实,锚定效应几乎为零;而面对编造的数量时,效应几近完全。研究者指出,这一模式同样可以被解读为对唯一可用信号的理性使用——当模型没有其他依据时,参考给定的锚点反而是合理的。
其余三种:放大、缺席与安全选择
- 框架效应(framing):在带标签的新内容上出现放大。
- 沉没成本效应(sunk cost):稳健地缺席,几乎不出现。
- 最小群体分配(minimal-group):最耐人寻味的是,模型的拒绝行为本身成为了主要发现——安全机制介入并主导了结果选择。
一句话人格设定就能颠覆结论
研究还发现,仅仅添加一句人格描述(如"宜人性",且是作为指令而非经过验证的特质操纵),就足以消除、削弱或反转这些效应,具体取决于是哪种效应。
这一发现强有力地反驳了"存在某种统一的响应偏差"的说法。如果一句话就能让效应翻转,那么所谓的"偏差"更像是被提示词临时激活的表演,而非模型固有的稳定属性。
心理学范式移植到 LLM 的三种失败方式
研究进一步形式化了心理学范式"移植"到 LLM 智能体时可能失败的三种途径,其中两种得到了实证记录:
- 人格支配(persona dominance):人格设定压倒了范式本身应测量的效应。
- 群体坍缩(population collapse):智能体群体缺乏应有的多样性反应。
- 安全选择(safety selection):模型的安全对齐机制介入,拒绝或改变了本应产生的行为。
这些失败模式提醒我们,直接照搬人类心理学实验去测量 LLM,可能得到误导性的结论。
为什么标量偏差分数是危险的
研究最重要的方法论主张是:用单一标量的"偏差易感性分数"来刻画 LLM,会掩盖上述结构性差异。
给模型打一个"从众倾向 0.8"这样的分数,会把"识别标签后的显式表演""理性使用可用信号""安全机制主导"这些质地完全不同的机制混为一谈。研究者主张改用**复现剖面(replication profiles)**来报告结果——即完整呈现效应在不同条件下的出现与消失模式,而非压缩成一个数字。
对于评估 LLM 智能体的行为,这是一个值得整个领域重视的方向:真正重要的不是模型"看起来"有多像人,而是它的行为通过什么路径产生。理解这些路径,才能避免把评测建立在虚假的类人假象之上。
复现剖面(replication profiles)的概念借鉴自心理学中的元分析传统,但做了根本性的调整:它不追求将效应量压缩成单一数字,而是要求呈现效应在多个条件维度(命名/盲测、标准/反事实、有无人格设定)上的完整出现与消失模式。这种报告方式与近年来心理学"可重复性危机"后兴起的开放科学运动有内在呼应——研究者们越来越意识到,一个平均效应量背后可能隐藏着高度异质的子群体效应。对于 LLM 评测而言,复现剖面的意义在于:它迫使研究者回答"在什么条件下效应出现、在什么条件下消失",而非仅仅回答"效应有多大"。这对于下游的安全评估和能力边界划定都更具操作价值。
相关推荐

Cursor免费版8分钟建生产级应用,却败在同一个安全细节
Cursor免费版用8分12秒构建生产级Node+Postgres应用,22项API测试与界面检查全绿,比Copilot快6分钟,但默认密钥、无法撤销的JWT会话和登录无限流三个问题暴露了AI编程工具的安全盲区。
GoHighLevel对话AI接入MCP:智能体可调用40+外部应用
GoHighLevel 对话 AI 新增 MCP 支持,智能体可在对话中调用 40+ 外部应用完成预约、付款、表格写入等操作。了解功能限制、配置方法和上线时间。
物业管理软件为何必须拥抱AI与MCP协议
物业管理软件正转向开放生态。某系统已上线MCP服务器并筹备云端连接器,支持AI智能体接入与自定义工作流。本文分析MCP、开放API为何成为物业软件选型新标准。