LLM智能体概率模拟:真与假为何加不到1?

LLM智能体概率报告不满足互补一致性,动摇模拟信念解读的合法性。
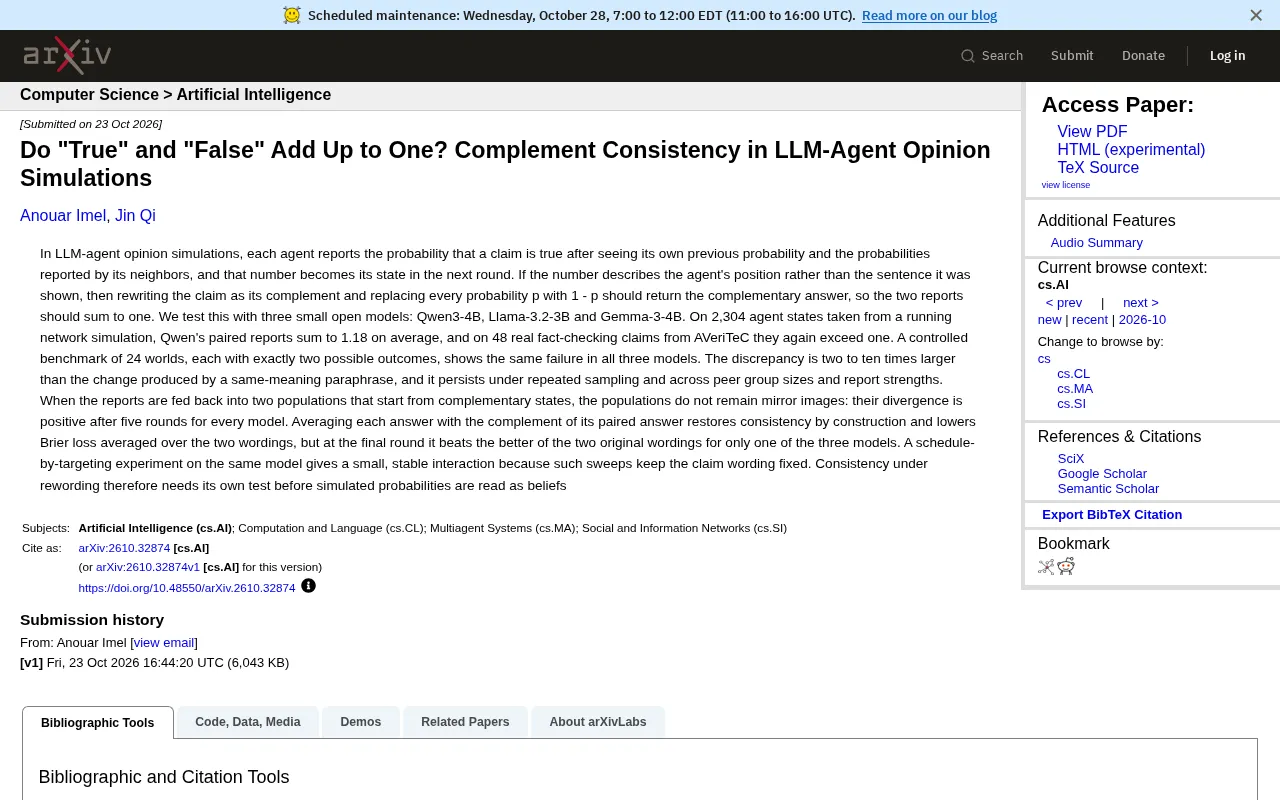
该研究检验了LLM智能体在意见模拟中报告概率时的互补一致性:将陈述改写为否定形式并将概率p替换为1-p后,两份报告之和应为1。然而在Qwen3-4B、Llama-3.2-3B和Gemma-3-4B三个小型开源模型上,该检验普遍失败,平均加和达1.18,偏差幅度是同一含义复述所产生变化的2到10倍,且在重复采样和不同群体规模下持续存在。从互补状态出发的两个模拟群体经五轮后不再保持镜像关系,分歧为正。平均互补答案虽可强制一致性,但仅在一个模型上最终轮Brier损失优于原始较好措辞。调度-靶向实验因固定措辞而交互效应微小,提示固定措辞下的模拟结果不足以证明概率反映稳定信念。研究建议将互补一致性作为LLM智能体意见模拟的标准质控步骤。
当LLM智能体在社交网络中报告概率时,一个看似简单的数学一致性检验——把“真”改写成“假”,并把每个概率p替换为1-p——却揭示出系统性偏差。近期一项针对小规模开源模型的研究发现,智能体对互补问题的回答并不满足加和为1的基本要求,这直接动摇了将模拟概率解读为“信念”的合法性。
核心发现:互补一致性检验失败
研究设计了一个直接的检验:在LLM智能体意见模拟中,每个智能体看到自己上一轮的概率和邻居报告的概率后,输出一个声称“某陈述为真”的概率,这个数字成为下一轮的状态。如果这个数字描述的是智能体的立场而非被展示的句子,那么把陈述改写为其否定形式,并将所有概率p替换为1-p,应该得到互补的答案,两份报告之和应为1。
然而,在三个小型开源模型(Qwen3-4B、Llama-3.2-3B和Gemma-3-4B)上,这一检验普遍失败。从运行中的网络模拟中提取的2,304个智能体状态显示,Qwen的成对报告平均加和为1.18;在AVeriTeC数据集的48个真实事实核查声明上,加和同样超过1。一个包含24个世界的受控基准测试(每个世界恰好有两种可能结果)在所有三个模型上都再现了同样的失败。
这一偏差幅度是同一含义复述所产生变化的2到10倍,并且在重复采样、不同同伴群体规模和报告强度下持续存在。
Brier损失是评估概率预测准确性的经典评分规则,定义为预测概率与真实结果(0或1)之间 squared error 的平均值。对于一个二分类结果,若模型给出的概率为 p,实际结果为 y ∈ {0,1},则单个预测的 Brier 分数为 (p - y)²。其取值越低越好,完全准确的确定性预测得分为 0,而始终输出 0.5 的“无信息”预测在均衡数据上得分为 0.25。Brier 损失同时惩罚过度自信与信心不足,且是严格适当的评分规则——真实概率是唯一的最优策略。本文中研究者用 Brier 损失对比不同措辞及平均化修正后的概率估计质量,正是利用其对校准质量的敏感度来检验互补一致性修复是否带来了真实增益,而不仅是数学上的自洽。
模拟动态中的镜像破缺
当这些报告被反馈到两个从互补状态出发的群体中时,两个群体未能保持镜像关系。对于每个模型,经过五轮后,它们的分歧都是正的。这意味着,即使初始条件完全对称,模拟过程也会自发产生系统性偏离,而非围绕中心对称波动。
这一发现对基于LLM智能体的意见动力学模拟提出了根本性质疑。如果智能体的概率报告在语义互补变换下不一致,那么模拟中涌现的“共识”或“极化”现象,可能部分源于模型的表述偏差,而非所建模的社会过程。
意见动力学模拟是计算社会科学中研究群体态度如何随互动演化的建模框架,常见模型包括有界信任模型(bounded confidence)、 voter 模型和 DeWG 模型等。这类模拟通常让每个智能体持有连续或离散的意见值,并按规则与邻居交换意见、更新自身立场,从而观察共识、极化或碎片化等宏观模式是否涌现。传统上,智能体的更新规则是显式数学函数;而 LLM 智能体模拟用语言模型替代该函数,让模型阅读邻居意见后生成新的概率或立场。这一替换引入了新的有效性前提:模型输出必须稳定地映射到所建模的意见变量上。若模型对语义等价但措辞不同的输入给出系统性不同的数值,则模拟中观察到的宏观动态可能混杂了语言生成偏差,而非纯粹的社会影响机制。
平均互补答案:修复一致性的代价
研究者测试了一种自然的修正方法:将每个答案与其配对答案的补数取平均。这种方法通过构造恢复了互补一致性,并降低了两种措辞上平均的Brier损失。然而,在最终轮次,它仅在三个模型中的一个上优于两种原始措辞中较好的那个。
换言之,强制一致性并不能保证获得更准确的概率估计。平均化在修正一种偏差的同时,可能引入另一种偏差。
为何调度-靶向实验不同?
在同一模型上的调度-靶向实验给出了一个微小但稳定的交互效应,原因在于这类扫描保持声明措辞固定。这提示了一个关键区别:当措辞固定时,模型输出的一致性较好;当措辞变化而语义不变时,不一致性才暴露出来。因此,仅报告在固定措辞下的模拟结果,不足以证明模拟概率反映了稳定的信念结构。
调度-靶向实验(scheduling-targeting experiment)是一种用于分离不同影响因素的控制实验设计。在这类实验中,研究者系统地操纵“调度”变量(如智能体更新顺序、互动轮次安排)与“靶向”变量(如信息针对的对象或传播路径),同时保持其他条件——包括用于描述陈述的措辞——固定不变,以观察特定操纵是否产生稳定的交互效应。由于措辞在扫描过程中不变,模型输出的一致性得以维持,因此观察到的效应相对微小且稳定。这一设计逻辑恰好反衬出互补一致性检验的价值:后者主动改变措辞而保持语义不变,从而暴露出固定措辞实验无法检测的表述敏感性。两者结合才能区分“模型对语义内容敏感”与“模型对语言形式敏感”这两种截然不同的解释。
对LLM智能体模拟的启示
这项研究传达了一个方法论警告:在将模拟概率解读为信念之前,需要单独检验改写一致性。具体建议包括:
- 在智能体模拟中纳入互补一致性作为标准诊断指标;
- 对关键结论进行措辞鲁棒性检验,而非仅依赖单一表述;
- 谨慎解读模拟中涌现的群体动态,区分模型伪影与社会机制;
- 在报告Brier损失等指标时,同时披露不同措辞下的表现差异。
互补一致性检验简单、廉价且信息量大,理应成为LLM智能体意见模拟的标准质控步骤。忽视它,可能导致将模型的语言表述偏差误读为人类信念的模拟。
相关推荐
用十几个Agent搭建黑灯工厂:Lauren Tan的信任阶梯与米其林厨房
Lauren Tan分享用十几个协调Agent每月合并超2500个PR的实战经验:从信任阶梯、米其林厨房隐喻到验证技能与内外循环连接,揭示黑灯工厂背后的环境工程哲学。
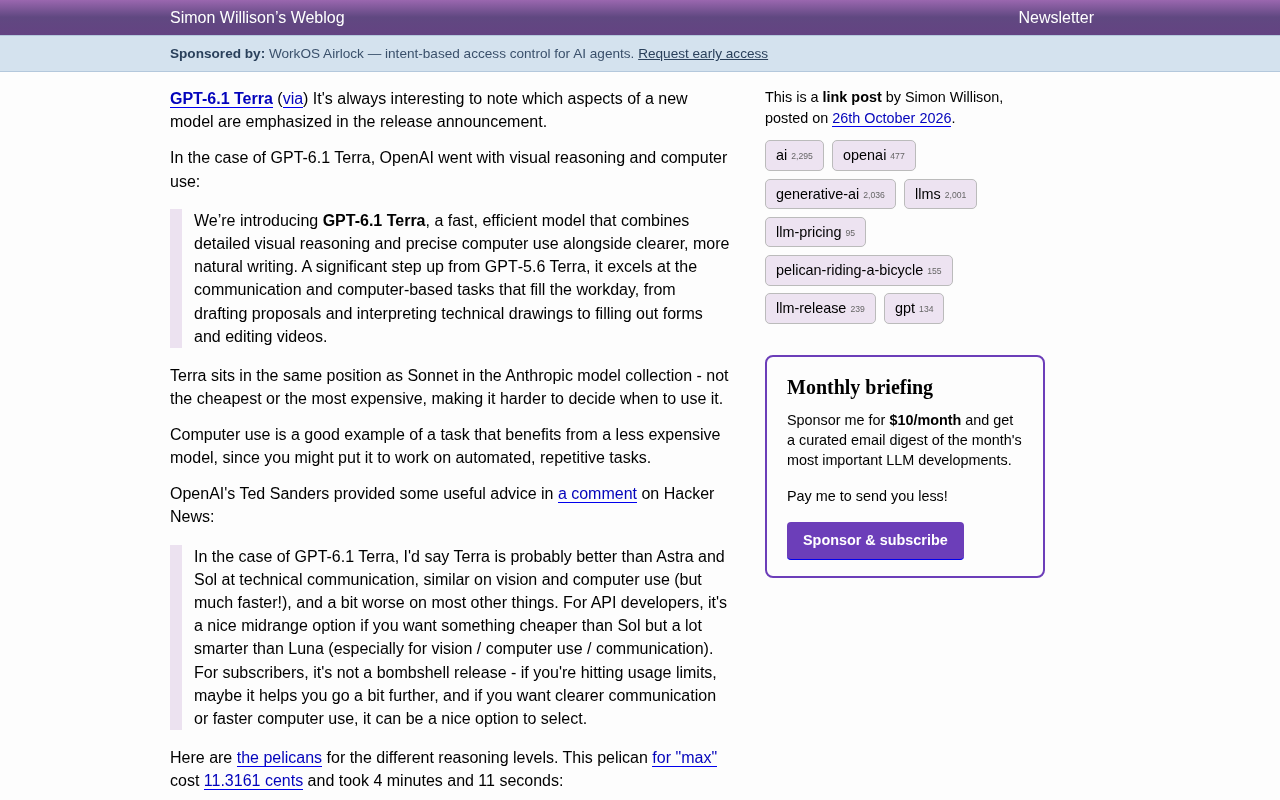
GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。
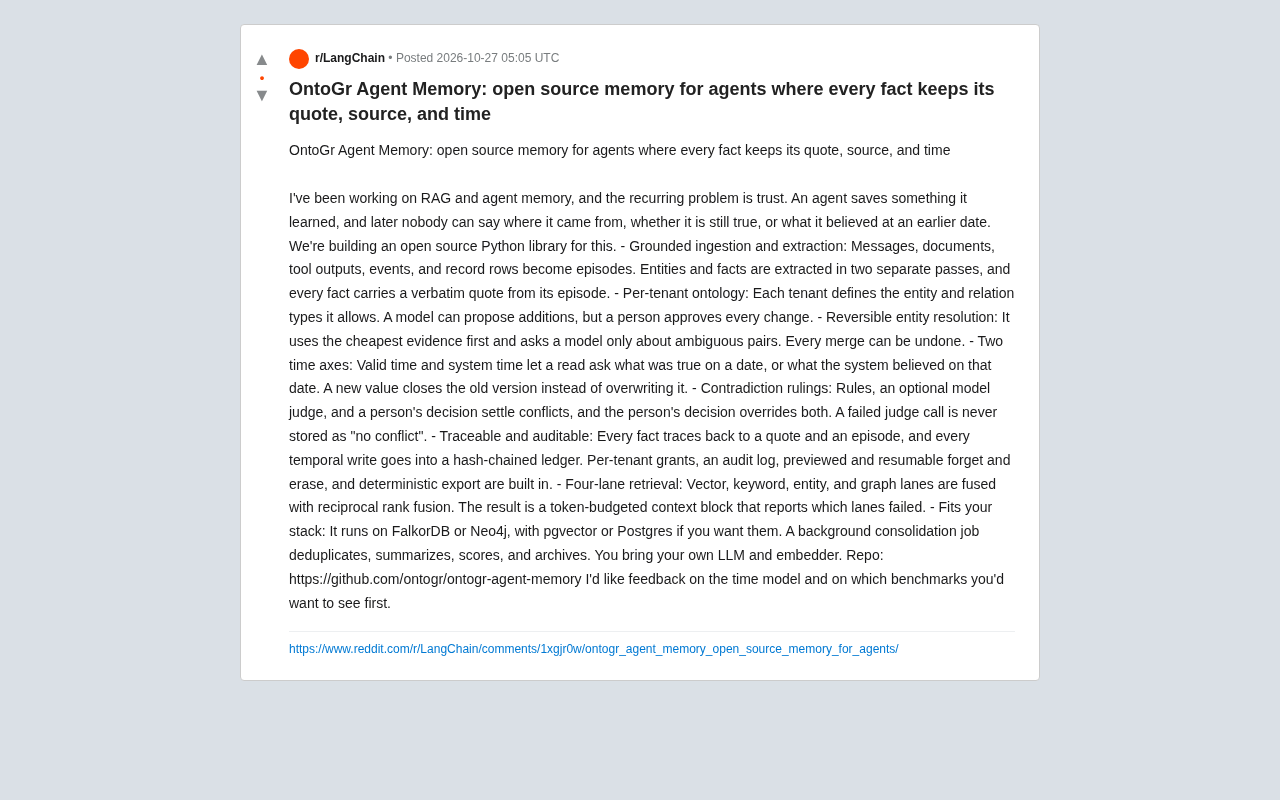
OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。