LM Studio 完全教程:本地运行大模型的最佳方式
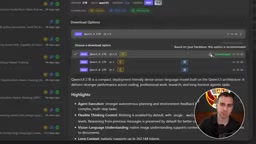
用LM Studio在本地免费运行大模型,并通过兼容OpenAI的API接入VS Code等外部工具。
本文是一份完整的LM Studio本地大模型部署实操指南。核心流程分四步:首先根据显存/统一内存容量选择合适体量的模型,优先选q4量化版以兼顾性能与精度;其次将模型加载到显存,通过KV缓存量化和投机解码优化速度与内存占用,并注意控制上下文长度避免溢出到普通内存;第三步在内置聊天界面验证模型是否正常工作;最后利用LM Studio提供的兼容OpenAI接口的本地API,将模型接入VS Code(Cline扩展)等外部工具,实现本地模型替代云端服务。全程免费、数据不出本机,LM Studio将这套流程的门槛压到了相当低的水平。
为什么选择 LM Studio 运行本地模型
LM Studio 是目前上手门槛最低、功能却相当完整的本地大模型运行工具之一。它提供了友好的图形界面,让你完全掌控本地模型——可以调整模型参数、修改上下文窗口,并通过本地推理服务器把模型暴露出来,供 VS Code 等其他应用调用。换句话说,你能在自己的电脑上免费跑起本地模型,还能把它当作一个兼容 OpenAI 接口的后端服务来用。
这里有个容易踩的坑:官方最近发布了一款名为 LM Studio Bionic 的新软件,但那并不是本教程要用的程序。你需要前往 lmstudio.ai/download 页面,下载带有标准图标的那个普通版 LM Studio。官网首页把它藏得比较深,直接访问下载页更稳妥。安装完成后打开,就能看到主界面。
挑选适合你硬件的模型
选择模型时,最关键的只有一个数字——你的显存(VRAM)或统一内存(Unified Memory)。这个数字直接决定了你能跑多大的模型。
如果你用的是 Windows,想要有效运行本地模型就需要一块独立显卡,最好是 NVIDIA 显卡,关注的是该 GPU 的显存容量。如果你在 Mac、Linux 或 DGX Spark 这类设备上,关注的则是统一内存——现代 Mac 可以让系统内存与 GPU 共享,虽然速度稍慢但容量更灵活。
不知道自己硬件参数?在 LM Studio 里进入「设置 → 硬件」,就能看到普通内存和显存的数值。记住这个数字后,再去选模型。
LM Studio 会根据你的硬件自动排序并推荐最合适的模型,带「大拇指」标记的就是推荐项,直接选它基本不会错。比如 24GB 显存的机器,会看到类似 Qwen 3 27B 这样的推荐。点开选项还能看到不同的量化等级(q4、q6、q8),量化指的是模型存储权重的精度。
一个实用建议:量化等级降到 q4 左右通常是性价比最高的选择——占用空间显著减少,模型能跑得更快、更容易塞进显存,而精度损失很小,结果依然相当不错。如果你只是跟着教程走,可以先下一个 1.2B 这类超小模型(约 1.25GB),用更高精度的 q8 也毫无压力。
量化(Quantization)是将模型权重从高精度浮点数(如 float16/32)压缩为低位整数(如 int8、int4)的技术。以一个 27B 参数模型为例,float16 格式需要约 54GB 显存,而 Q4 量化后仅需约 14GB,体积缩小近 4 倍。代价是模型输出质量略有下降,但实验表明 Q4 级别的精度损失在大多数任务中几乎感知不到。Q8 则介于全精度与 Q4 之间,质量更接近原始模型但体积缩减幅度较小。命名惯例通常是"Q"后接位数,位数越低压缩越激进,比如 Q2 已经相当激进、质量损失明显,Q6 则被认为是质量与体积的较好平衡点。GGUF 是目前 LM Studio 主要使用的量化模型格式,由 llama.cpp 项目推广,支持跨平台 CPU/GPU 混合推理。
加载模型与上下文优化
下载完成的模型只是存在硬盘上,还不能直接用,必须「加载」到显存里才能被调用。在左侧模型标签页选中模型,点击右侧的「Load Model」按钮即可,加载时会弹出设置面板(看不到的话打开底部的「show advanced settings」)。
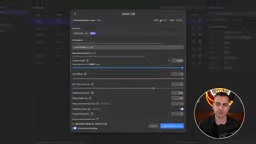
加载时最该关注的是上下文长度(context length)。上下文越大,占用的显存越多,大模型尤其明显。当你把上下文拉到 262K 这种量级时,占用可能从 17GB 飙到 45GB,直接撑爆显存。
解决办法是启用 K cache 和 V cache 量化,把它们设成 Q8 或 Q4。以 Q4 为例,能节省大量内存,让你在不爆显存的前提下用上更大的上下文——这对编程 Agent 这类需要长上下文的场景非常关键。此外还建议开启 speculative decoding(投机解码)的 MTP 模式,它能显著提升模型运行速度。调好后勾选记住设置的选项,下次加载就能复用。
只要显存够用,你可以同时加载多个模型。但要注意:模型真正跑得快,前提是它完全装进了显存(VRAM),而不是溢出到普通内存。一旦溢出,响应会慢得令人崩溃——视频作者自己也演示了因上下文设太高导致 prompt 处理极慢的翻车现场,调低上下文重新加载后才恢复正常。这是实操中非常常见的坑。
KV Cache(Key-Value Cache)是 Transformer 架构推理时的核心加速结构。模型在生成每个新 token 时,需要"回顾"之前所有 token 的注意力键值对,KV Cache 就是把这些中间计算结果缓存在显存中以避免重复计算。上下文越长,缓存越大,显存占用随上下文长度呈近似线性增长。对 KV Cache 本身进行量化(如从 float16 降到 Q8 或 Q4),可以在不影响主要模型权重精度的前提下,大幅减少这部分显存占用。投机解码(Speculative Decoding)则是另一种加速技术:用一个更小的"草稿模型"先快速猜测接下来若干 token,再由主模型批量验证,接受猜对的部分、拒绝猜错的部分重新生成。由于批量验证比逐 token 生成更高效,整体吞吐量可显著提升,尤其在输出较长时效果更明显。MTP(Multi-Token Prediction)是其中一种实现变体,Qwen 等模型原生支持该模式。
在内置界面测试模型
模型加载后,点击 LM Studio 的聊天图标就能新建对话,直接和本地模型交互。这个界面主要用来测试模型是否正常工作,输出区会显示完整的思考过程、生成的 token 数、每秒 token 速度、耗时以及停止原因等信息。
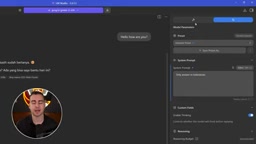
在模型参数里,你可以设置系统提示词(比如让它「只用印尼语回答」),添加自定义字段、切换结构化输出模式,还能把常用配置保存成预设。LM Studio 也支持插件扩展:可以加 RAG 功能上传文件做问答,加入 JS 代码沙盒让模型写代码,甚至接入 MCP 服务器让模型调用工具。如果你想要一个纯本地的聊天界面,这里完全够用。
核心亮点:本地 API 服务器
LM Studio 真正强大的地方,在于它会把你加载的模型通过一个本地 API 服务器暴露出来。这个 API 地址对本机所有应用可见,而且兼容 OpenAI 接口——这意味着任何原本调用 OpenAI 模型的工具,只要把 URL 换成 LM Studio 的地址,就能改用你的本地模型。
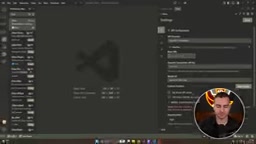
以 VS Code 为例,安装 Cline 这类扩展后,进入设置把 API Provider 改为「OpenAI Compatible」,Base URL 填 LM Studio 提供的地址,API Key 随便填任意字符即可,Model 填你刚加载的模型名(可以直接复制)。配置完成后就能在编辑器里直接和本地模型对话,所有请求的完整日志都能在 LM Studio 里查看。
视频里还演示了一个颇具「套娃」趣味的例子:让本地模型写一段调用本地模型 API 的 Python 脚本。模型顺利生成了引用 localhost:1234/v1 端点的代码,运行后终端成功返回了模型的自我介绍。这直观证明了本地模型完全可以作为后端服务,接入 Cline、Claude Code 或其他任意 Agent 框架,用途远不止编程。
OpenAI 兼容接口(OpenAI-Compatible API)指的是遵循 OpenAI 官方 REST API 规范的服务端点,核心是 /v1/chat/completions 这一路径与请求/响应的 JSON 结构。由于 OpenAI API 已成为事实上的行业标准,大量工具(Cline、Continue、Open WebUI、LangChain 等)都内置了对该格式的支持。LM Studio 在本机的默认地址为 http://localhost:1234,将其填入任意支持"自定义 OpenAI 端点"的客户端,即可无缝替换云端模型。API Key 字段通常是为了身份验证设计的,但本地服务器不需要真实密钥,填任意非空字符串即可绕过客户端的格式校验。这种架构的实际意义在于:你无需修改任何应用代码逻辑,只需切换一个 URL,就能在云端模型与本地模型之间自由切换。
实操要点小结
整个流程可以提炼为几条清晰的原则:先搞清自己的显存/统一内存容量,再按 LM Studio 推荐选择能装下的模型;量化优先选 q4 这类高性价比等级;加载时通过 KV 缓存量化和投机解码优化性能与显存占用;最后善用兼容 OpenAI 的本地 API,把模型接入到各种外部应用中。
需要提醒的是,别把上下文窗口设得过于激进,留一点显存余量给系统和其他应用,否则溢出到普通内存会严重拖慢速度。本地模型的魅力在于免费、隐私可控且可离线运行,而 LM Studio 把这套流程的门槛压到了相当低的水平。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。