LUCQUE:迄今最大的可访问肺癌筛查AI评测数据集

魁北克LUCQUE数据集以模型到数据机制提供最大可访问真实世界肺癌筛查标注基准。
文章介绍了一个名为LUCQUE的肺癌筛查数据集,旨在解决AI评测长期依赖私有或碎片化公开数据、导致可复现性与可比性不足的问题。LUCQUE源自魁北克低剂量CT筛查,包含1678例基线检查、1776个肺结节和60个囊肿的体素级专家分割标注,并附带临床信息与Lung-RADS病灶特征。数据集托管于PARADIM平台,采用“模型到数据”的访问机制——用户提交代码、数据不出本地,从而在保护隐私的同时支持独立、可复现的第三方评测。文章认为,这类数据集为肺结节检测、分割与风险预测工具提供了可比基准,但单一地区来源在人群多样性上仍有局限,跨区域外部验证是后续方向。
肺癌筛查AI评测的数据困境
AI工具在肺癌筛查(LCS)中被寄予厚望,但对其真实性能的评估长期受制于数据瓶颈。据原始论文描述,现有评估往往依赖私有数据集,或使用临床数据与专家结节标注不一致的碎片化公开数据集。这种状况直接导致三个后果:AI工具的可复现性差、不同工具之间难以横向比较、独立第三方评估几乎无法开展。
对于临床落地而言,这个问题比模型结构本身更关键——一个在私有数据上表现优异的模型,若无法在真实世界数据上被独立验证,其临床价值就始终存疑。
LUCQUE:来自魁北克的真实世界筛查数据集
为解决上述缺口,研究团队构建了LUCQUE——一个源自魁北克省LDCT(低剂量计算机断层扫描)肺癌筛查、经过全面标注的大型数据集,专门面向可靠的AI评估。
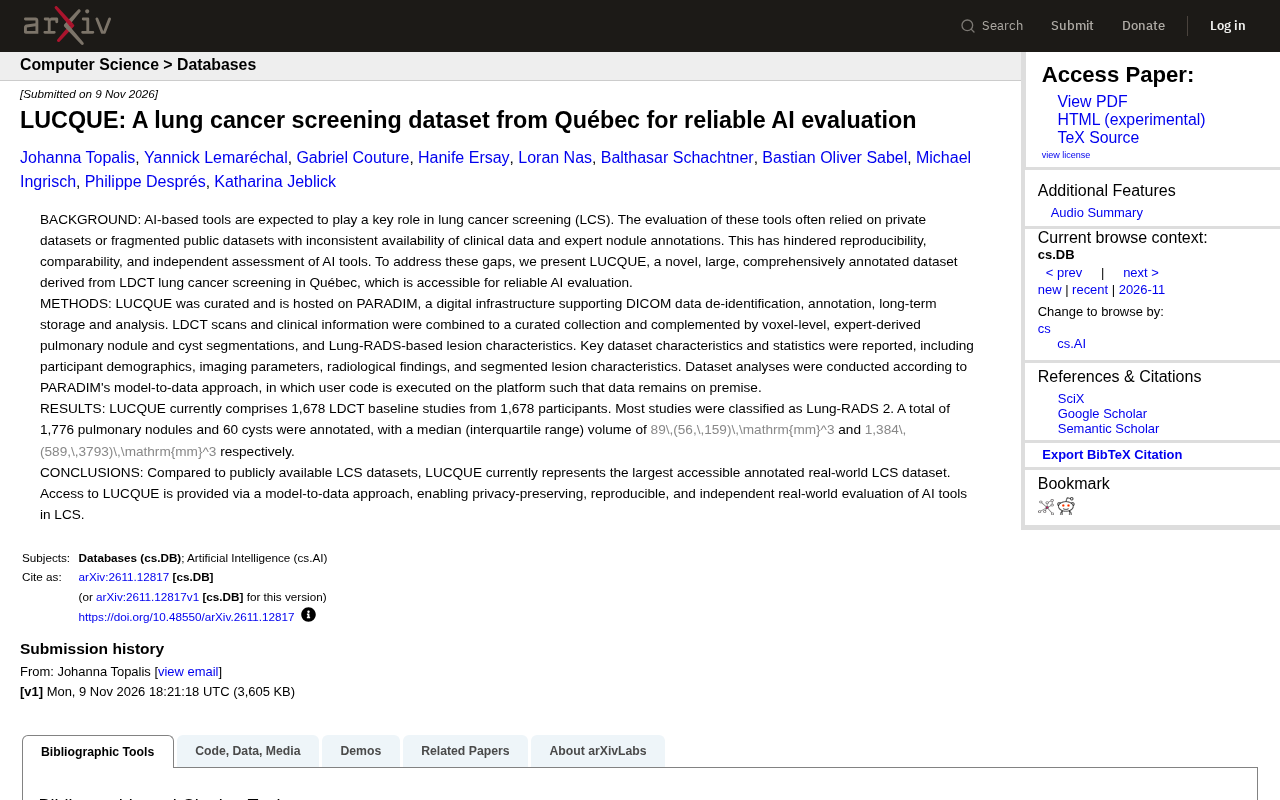
数据集托管于PARADIM数字基础设施之上,该平台支持DICOM数据的去标识化、标注、长期存储与分析。LUCQUE将LDCT扫描与临床信息整合为策展集合,并补充了体素级的专家肺结节与囊肿分割标注,以及基于Lung-RADS的病灶特征描述。
数据集规模与标注细节
根据论文公布的结果,LUCQUE当前包含来自1,678名参与者的1,678例LDCT基线检查。绝大多数检查被归类为Lung-RADS 2。数据集共标注了1,776个肺结节和60个囊肿,其中结节体积的中位数(四分位距)为89(56, 159)mm³,囊肿体积的中位数(四分位距)为1,384(589, 3793)mm³。
有意思的是,体素级分割由专家完成,而非众包或模型预标注,这对训练和评测分割类AI工具具有直接价值。同时,Lung-RADS分级信息让数据集可以支撑风险分层相关的评测任务,而不只是单纯的病灶检测。
Lung-RADS(肺部影像报告和数据系统)是由美国放射学会制定的标准化肺癌筛查CT报告框架,将筛查结果按恶性风险从0到4X分为若干类别。其中Lung-RADS 1代表无结节或良性钙化,2代表良性表现或具有极低恶性概率的结节,通常建议继续年度筛查。该分级直接决定临床随访策略,因此将Lung-RADS标签纳入数据集,使AI工具不仅能被评估“是否检出病灶”,还能被检验“风险分层是否与专家一致”——后者更贴近筛查流程中的实际决策需求。
体素级分割(voxel-level segmentation)指在三维CT体积中对每个体素逐一标注其是否属于病灶区域,而非仅用边界框或中心点标出结节位置。这种标注粒度能精确刻画结节的形状、边界与体积,是训练和评估分割模型(如U-Net类架构)所必需的监督信号。相比矩形框标注,体素级标注成本高得多,通常需要放射科专家逐层勾画,但它是自动体积测量、结节生长率计算等临床任务的基础,也是区分良恶性评估工具性能的关键数据形式。
模型到数据:隐私保护下的评测范式
LUCQUE在访问机制上做出了一个值得关注的设计选择:数据不对外拷贝,而是采用"模型到数据"(model-to-data)的方式。用户提交代码,代码在PARADIM平台上执行,数据始终保留在本地环境中。
这种范式对医疗AI评测具有多重意义。其一,患者隐私风险显著降低,数据不出院、不出平台即可完成外部算法验证。其二,评测过程可复现——研究者提交的代码在同一数据环境上运行,减少了数据版本差异带来的偏差。其三,它为独立评估创造了制度空间:算法开发者不必交出模型权重,评测方也不必交出原始数据,双方可以在合规框架下完成验证。
与公开LCS数据集的对比
论文结论明确指出,与现有公开肺癌筛查数据集相比,LUCQUE是目前最大的可访问、带标注的真实世界LCS数据集。这里的关键词是"可访问"与"真实世界"——前者指向通过模型到数据机制开放使用,后者意味着数据来自实际筛查场景,而非高度筛选的科研队列。
“模型到数据”(model-to-data)是与传统“数据到模型”相对的一种协作范式:后者要求把数据拷贝或传输到算法开发者所在的环境,前者则把算法代码迁移到数据所在的受控平台执行,仅返回聚合后的评估指标而非原始数据。这一思路在医疗影像领域尤为重要,因为患者影像受HIPAA、GDPR及各国隐私法规严格约束,跨机构数据传输往往面临冗长的审批甚至法律障碍。model-to-data使得外部团队无需接触原始DICOM文件即可完成验证,同时平台方可审计代码行为,兼顾开放性与安全性。
LDCT(低剂量计算机断层扫描)是肺癌筛查的标准影像手段,其辐射剂量约为常规胸部CT的1/5至1/10,在保持对肺结节检出敏感性的同时显著降低辐射暴露风险。大型随机对照试验(如美国NLST、荷兰NELSON)已证实LDCT筛查可降低肺癌死亡率,因此LDCT成为各国肺癌筛查指南推荐的首选方式。这也意味着基于LDCT构建的AI评测数据集,其影像特征、层厚与重建参数与真实筛查场景一致,对评估工具能否在临床筛查流程中落地具有直接参考价值。
对AI肺癌筛查研发的启示
LUCQUE的出现回应了医疗AI领域一个反复被提及的结构性矛盾:高质量标注数据稀缺,而隐私法规又限制数据流动。模型到数据的思路绕开了数据共享的法律障碍,同时保留了独立评测所需的严谨性。
对从事肺结节检测、分割或风险预测的团队而言,这类数据集的真正价值在于提供可比基准。当多个AI工具在同一份真实世界数据、同一套专家标注上被评估时,性能差异才具备临床参考意义。当然,单一地区来源的数据在人群多样性上仍有局限,跨区域的外部验证仍是后续需要关注的方向。
相关推荐
Cursor、Devin、TRAE、Copilot价格怎么比?先算额度再比月费
横向对比Cursor、Devin Desktop、TRAE、Copilot四家AI编程工具的个人与团队定价,拆解额度规则、第三方模型是否含在月费、超额计费方式,并给出付费前测消耗、设支出上限和选型的实操方法。
Copilot下架三款模型:Pro用户替代选择只剩一个
GitHub Copilot 自 11 月 16 日起下架 Claude Opus 4.8、Claude Opus 5、GPT-5.6 Tera 三款模型,覆盖 Chat、代码补全与 Agent 模式。Pro 用户三个替代中仅剩 GPT-6 Luna 可用,年付 Legacy 计划拿不到 Opus 5.5,管理员需手动开启替代模型。

Gemini 4 Carbon登场:大模型竞赛进入百万上下文与万亿开源时代
谷歌发布Gemini 4 Carbon并推出多智能体工具Swarm,Anthropic推出百万上下文Fable 5.2与Mythos 5.2,OpenAI发布安全专版GPT-6 Cyber,Mistral与Kimi同步开源万亿参数模型,大模型竞赛全面提速。