M5 Ultra 512GB内存为何跑不快?带宽才是AI性能瓶颈

M5 Ultra 内存容量翻4倍却带宽只涨不到2倍,解决了「装得下」却没解决「跑得快」。
苹果 M5 Ultra 凭借 512GB 统一内存让超大本地模型首次进入个人工作站,但其 1.2TB/s 的内存带宽相较于 M5 Max 仅提升不到两倍,与容量的四倍扩张严重不匹配。大模型推理的 Decode 阶段本质上是内存带宽密集型任务,理论 token 速度约等于带宽除以模型权重大小,这意味着模型越大、带宽瓶颈越突出——恰恰是最需要 512GB 容量的场景,也最容易被 1.2TB/s 卡死。长上下文任务中 KV Cache 膨胀进一步加剧速度衰减,而对比 NVIDIA RTX Pro 6000 的 1.792TB/s 带宽,M5 Ultra 呈现出「巨型仓库配普通高速路」的尴尬局面。作者认为真正配得上 512GB 的带宽应达到 2.4TB/s,现有设计是容量做到了下一代、带宽留在了上一代。
苹果新一代 M5 Ultra 抛出了一个足以让本地 AI 玩家心跳加速的参数——512GB 统一内存。这意味着过去单张显卡根本装不下的 200B、300B 甚至更大的模型,第一次有机会直接塞进一台 Mac Studio。但当你继续往下看另一个参数时,会发现一件相当反常的事:它的内存带宽只有 1.2TB/s。
本文基于 B 站 UP 主对 M5 Ultra 的分析,拆解一个核心矛盾——为什么一台内存大得吓人的机器,在真正跑大模型时却可能慢得让人难受。
512GB 很诱人,但带宽只涨了不到两倍
M5 Ultra 最炸裂的参数不是 CPU,也不是 GPU,而是 512GB 统一内存。对本地 AI 用户来说,这个数字意味着超大模型的本地运行不再是服务器玩家的专属。
问题出在带宽的增长比例上。作为参照,M5 Max 128GB 的内存带宽已经有 614GB/s。而 M5 Ultra 的内存容量从 128GB 暴涨到 512GB,整整 4 倍;带宽却只从 614GB/s 涨到 1.2TB/s,不到两倍。
用一个形象的比喻:苹果给你建了一座大四倍的超级仓库,结果门口的高速公路只拓宽了不到两倍。看起来气势惊人,真正开始搬货时却发现出口堵了。这正是 M5 Ultra 最让人难受的地方。
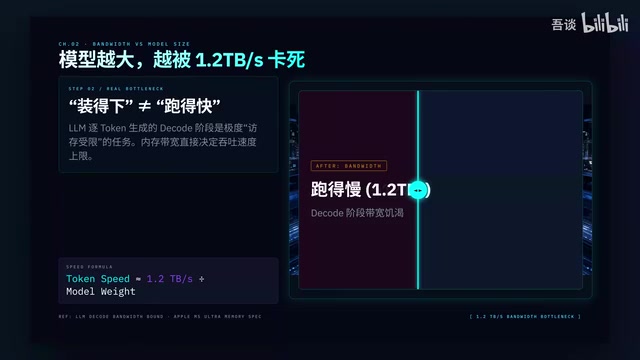
决定大模型体验的,是带宽而非容量
很多人会说,512GB 还不够吗?问题是,本地跑大模型真正决定体验的从来不只是「装不装得下」,而是「装进去之后跑得快不快」。
对于 LLM 的 Token 生成,尤其是大模型的 Decode 阶段,内存带宽往往就是最关键的瓶颈之一。可以用一个粗暴但直观的公式理解:
理论 Token 速度 ≈ 内存带宽 ÷ 模型权重大小
假设一个模型量化后有 100GB,M5 Ultra 的 1.2TB/s 带宽对应的理论速度大约是 12 token/s;如果模型是 200GB,就只剩 6 token/s;300GB 则大约 4 token/s。
真实速度不会完全等于这个公式,因为还有缓存、MTP、Speculative Decoding、KV Cache 和各种 Kernel 优化。但物理规律不会变:模型越大,每生成一个 token 要搬的数据越多,带宽就越重要。
这里涉及到 LLM 推理的两个不同阶段:Prefill(预填充)和 Decode(解码)。Prefill 阶段负责一次性处理输入的所有 token,是计算密集型操作,GPU/NPU 的算力(FLOPS)是主要瓶颈;而 Decode 阶段是逐 token 自回归生成的过程,每生成一个 token 都需要将全部模型权重从内存搬运到计算单元,属于典型的内存带宽密集型操作。在实际对话中,用户感受到的「打字速度」几乎完全取决于 Decode 阶段的效率。由于 M5 Ultra 的神经网络引擎和 GPU 核心数相比算力提升幅度更大,Prefill 速度会有明显提升,但 Decode 速度受制于 1.2TB/s 的带宽天花板,对于超大模型的改善非常有限。这也是为什么「参数量越大,带宽瓶颈越突出」——模型从 30B 涨到 300B,权重搬运量也同步放大了 10 倍。
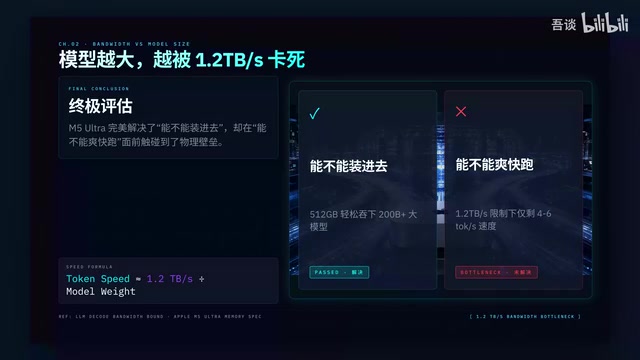
越大的模型,越容易被 1.2TB/s 卡死
这里藏着一个尴尬的闭环。你为什么买 512GB?显然不是为了跑 27B、32B——这些模型 128GB 的 M5 Max 已经能跑得很好。真正买 512GB Ultra 的人,想跑的必然是 100B、200B 甚至几百 B 的大模型。
讽刺的是:模型越大越需要 512GB 的容量,模型越大又越容易被 1.2TB/s 的带宽卡死。也就是说,M5 Ultra 最强的场景,恰恰会把它最大的短板暴露得最彻底。它解决了「能不能装进去」,却没有真正解决「装进去以后能不能爽快地跑」。
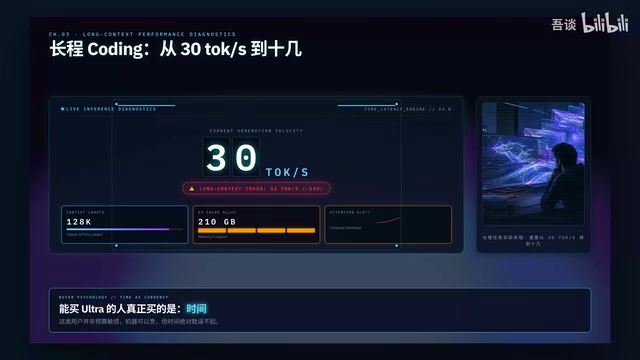
长上下文场景下,速度衰减更明显
更现实的问题在于长上下文。短测试跑 30 token/s 看起来还不错,但真正用 Claude Code、Coding Agent 做复杂项目时完全是另一回事。
随着项目推进,上下文越跑越长、文件越读越多、历史消息越堆越多,KV Cache 不断膨胀,Attention 开销越来越高,工具调用越来越频繁。一个短上下文还能跑 30 token/s 的模型,在长任务里可能直接掉到十几。
那是什么体验?你花巨资买了一台 512GB Ultra,结果真正做复杂项目的时候,AI 还是一个字一个字慢慢往外蹦。这就很荒诞——能买 Ultra 的人往往不是预算敏感用户,他们真正买的是时间。他们可以接受机器贵,但很难接受机器贵了几倍,速度只快不到两倍。
KV Cache(键值缓存)是 Transformer 架构中用于存储注意力机制历史计算结果的缓存结构。每一层的每一个 token 都会产生 Key 和 Value 向量并缓存起来,以避免重复计算。随着上下文长度增长,KV Cache 的体积按 O(n) 线性膨胀——对于一个有 128 层、每层 hidden size 较大的模型,处理 100K token 的上下文时,KV Cache 本身就可能占据数 GB 甚至数十 GB 的内存。更关键的是,生成每个新 token 时都需要读取完整的 KV Cache 来完成 Attention 计算,这意味着长上下文不仅占用内存空间,还在每一步生成时额外消耗带宽。这正是为什么 Claude Code 或 Coding Agent 类长任务会让 token 速度腰斩——模型权重的搬运开销是固定的,但 KV Cache 的读取开销会随上下文持续累加。
对比 NVIDIA:小仓库配超高速公路
把 M5 Ultra 和 NVIDIA RTX Pro 6000 放一起,反差就更明显。Pro 6000 只有 96GB 显存,和 512GB Ultra 比容量简直像小仓库。但它采用 28Gbps 的 GDDR7,显存带宽达到 1.792TB/s。
于是出现了一个极其讽刺的画面:M5 Ultra 的内存容量是 Pro 6000 的五倍多,内存带宽反而只有它的大约三分之二。一边是「小仓库 + 超高速公路」,另一边是「巨型仓库 + 普通高速路」。
如果模型在 96GB 以内,NVIDIA 显然更容易把速度做起来;Apple 的优势只在模型超过 96GB 后才真正显现。但偏偏模型一旦超过 96GB,Apple 自己的带宽压力又开始快速放大——这就形成了那个尴尬的闭环。
真正配得上 512GB 的带宽应该是多少
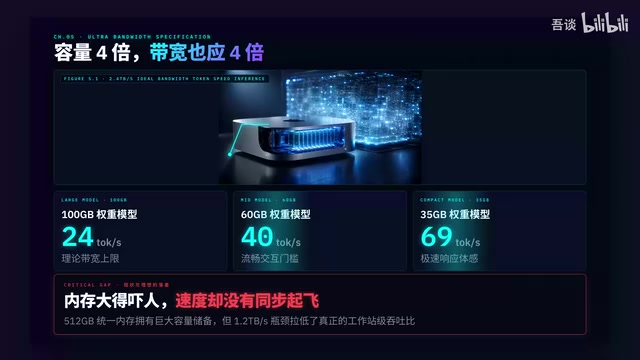
按照 UP 主的推算,真正配得上 512GB 统一内存的 Ultra,带宽不应该是 1.2TB/s,至少应该是 2.4TB/s。
逻辑很简单:M5 Max 是 614GB/s,从 614 到 2400 差不多是 4 倍,而 128GB 到 512GB 同样是 4 倍。容量翻 4 倍,带宽也接近 4 倍,这才叫 Ultra。
如果真能做到 2.4TB/s,一个 100GB 权重模型理论带宽上限可以来到 24 token/s,60GB 模型能到 40 token/s,35GB 模型接近 69 token/s。再叠加 MTP 和推测解码,100B、200B 级模型才真正有机会进入高端工作站该有的交互速度。
MTP(Multi-Token Prediction,多 token 预测)和 Speculative Decoding(推测解码)是两种可以在一定程度上绕开带宽瓶颈的推理加速技术。Speculative Decoding 的核心思路是用一个小草稿模型快速生成候选 token 序列,再由大模型并行验证,通过提高单次内存读取的「产出 token 数」来摊薄带宽成本。MTP 则让模型在一次前向传播中同时预测多个后续 token。这些技术在带宽充足时效果更显著,但当带宽本身已经成为硬性瓶颈时,优化空间会被压缩。对于 200B 以上的模型,每次前向传播的数据搬运量极大,草稿模型的验证开销也相应攀升,投机解码的加速比往往不如在中小模型上理想。这也是为什么单靠软件优化难以从根本上解决 M5 Ultra 带宽不足的问题。
结论:容量做到了下一代,带宽留在了上一代
M5 Ultra 真正的问题不是 512GB 没用——恰恰相反,512GB 非常有价值。问题是苹果把容量做到了下一代,却把带宽留在了上一代半,这才是最让人难受的地方。
对普通用户,它太贵;对专业 AI 用户,它又不够快。真正愿意花这个钱的人看的根本不是「能不能跑」,而是「值不值得」。当一台 512GB 的 Ultra 在核心 AI 推理速度上只比 128GB 的 M5 Max 快不到 2 倍时,这个反差会非常刺眼。
给它下一个最狠的定义:它可能是目前个人电脑里最能装大模型的机器之一,也是最容易让人误以为「大内存等于大性能」的机器之一。真正决定本地 AI 体验的,从来不只是那个震撼的 512GB,而是那个不那么显眼、却真正决定速度的数字——1.2TB/s。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。