M5 Ultra Mac Studio实测:统一内存如何碾压RTX 5090跑大模型
M5 Ultra Mac Studio与RTX 5090 PC全面对比:CPU碾压、大模型推理暴打,游戏被碾压,统一内存是关键变量。
苹果M5 Ultra Mac Studio(不到7000美元整机)与搭载RTX 5090的旗舰PC(整机破万)的横向对比揭示了一个清晰的规律:统一内存架构决定胜负的场景边界。多核CPU性能上M5 Ultra以接近两倍的成绩击败9950X3D,功耗还低25%;本地AI推理中,小模型5090凭借显存带宽领先,但700亿参数模型因超出32GB显存而触发PCIe瓶颈,M5 Ultra反超多达20倍;视频剪辑中Adobe的Apple Silicon优化让Mac Studio在Premiere导出上快一倍;游戏是唯一PC完胜的领域。核心结论是:工作负载越依赖大规模统一内存和CPU算力,M5 Ultra优势越明显;越依赖GPU光栅化和小显存模型,PC越占上风。
苹果发布M5 Ultra版Mac Studio时,很多人第一反应是「这不是给内容创作者准备的」。它的真正定位是那些需要桌面级性能的大规模工作负载——高级3D渲染、大型VFX制作,以及本地运行大语言模型。这正是数据科学家和开发者真正需要的场景。这篇文章基于B站搬运的一段深度实测视频,把M5 Ultra Mac Studio和目前最快的PC配置(Ryzen 9 9950X3D + RTX 5090)放在一起做了全面对比,结果比想象中更有意思。
价格与配置:一台整机 vs 一块显卡
先看价格这个绕不开的话题。追求这种性能的PC用户通常会选择Threadripper或9950X3D搭配RTX 5090,但光是一块RTX 5090就要约5000美元,近期甚至有listing逼近9000美元——这还只是一个零部件。
相比之下,M5 Ultra Mac Studio(36核CPU、80核GPU、96GB统一内存)售价不到7000美元,而且是一台完整可用的整机。PC那边你还得再买CPU、内存、散热、存储、机箱、电源和操作系统,轻松就能逼近甚至超过1万美元。
不过测试用的这台Mac Studio配了256GB统一内存,这个升级项本身就要4000美元,价格同样离谱。视频作者也坦言,即便考虑到全行业内存和SSD价格暴涨,这个配置依然贵得惊人。
CPU性能:M5 Ultra刷新纪录
单核性能上两者接近,M5 Ultra甚至略微领先M5 Max MacBook Pro,并明显超过PC。这些M5芯片在快速突发型单核任务上表现极佳,打开项目、加载文件时速度飞快。
多核才是M5 Ultra真正拉开差距的地方。9950X3D的32线程根本跟不上36核的M5 Ultra,后者跑出了接近两倍的分数,并在Cinebench 2026中保持同样领先。关键是这些成绩是在10分钟持续运行后取得的,不是瞬时爆发值,得益于机身内强大的散热系统,性能能长时间稳定维持。
最让人意外的是功耗表现。满核负载下M5 Ultra约150瓦,而9950X3D约200瓦。换句话说,M5 Ultra在提供两倍性能的同时,功耗还低了25%。这种「既快又省」的组合非常难得。
实际应用同样印证了这一点:Blender中M5 Ultra比9950X3D快70%以上,是M5 Max MacBook Pro的两倍多;Houdini快约60%;HandBrake CPU编码也快约60%。对CPU密集型工作负载来说,M5 Ultra是视频作者测过的最快CPU。
Cinebench是业界广泛使用的CPU渲染基准测试,通过让处理器用光线追踪算法渲染一个复杂3D场景来测量多核及单核性能,得分越高代表算力越强。9950X3D是AMD Ryzen 9000系列的旗舰桌面处理器,16核32线程,其「3D V-Cache」技术通过在芯片顶部堆叠额外的三级缓存(总计128MB)来提升游戏和模拟类负载性能,但在纯多核吞吐量场景并无特殊优势。M5 Ultra本质上是两颗M5 Max芯片通过苹果专有的UltraFusion互联技术拼合而成,实现36个高性能CPU核心,这种设计使其多核规模远超消费级PC芯片,更接近工作站级别的Threadripper定位。文中提到10分钟持续负载后仍保持高分,正是因为Mac Studio紧凑机身内的散热系统按工作站标准设计,而非像笔记本那样降频保温。
GPU与AI:统一内存的胜负手
在GPU加速任务上,PC手握RTX 5090这张王牌。Blender中Mac Studio比5090快约40%,但有个前提——这是对比NVIDIA的CUDA路径。Blender原生支持苹果Metal,却不支持NVIDIA的OptiX光追引擎。一旦在PC上开启OptiX,5090就会反超Mac Studio。两者跑在完全不同的软件栈上,这点必须说清楚。
真正精彩的是本地AI测试。作者在LM Studio里跑了从120亿到700亿参数的六个模型。方法上需要注意:Mac端部分模型(Gemma 12B、GPT OSS 20B、Gemma 31B)用了苹果自家优化的MLX框架,而27B和70B模型在两个平台都用标准GGUF格式。
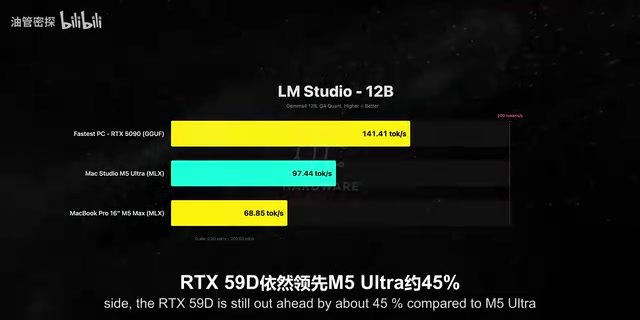
小模型阶段5090占尽优势:Gemma 12B(MLX)快约45%,GPT OSS 20B快超过75%。原因很简单——这些模型能完全塞进5090的32GB显存,加上惊人的显存带宽,raw吞吐量拉满。
转折出现在中大型模型。Qwen 3 27B在Q4量化下5090领先约47%,但升到Q8后领先幅度收窄到约23%。更高质量的量化反而缩小了差距,因为Q8模型更吃内存带宽,这正是Mac Studio统一架构发力的地方。
真正的逆转发生在700亿参数的DeepSeek广告 R1 Llama蒸馏模型。这个模型装不进5090的32GB显存,只能把溢出部分丢到系统内存,数据要来回走PCIe总线,速度远不及GPU自身显存。结果M5 Ultra比5090快了20倍以上,连M5 Max MacBook Pro都赢了5090。
这里苹果的统一内存架构彻底展现价值。测试机的256GB内存由CPU和GPU共享,没有溢出、没有PCIe瓶颈。哪怕是96GB的基础版M5 Ultra,也能完整装下700亿参数模型。更夸张的是功耗:700亿参数负载下5090约275瓦、M5 Ultra约300瓦,几乎持平——功耗相近却快20倍以上,这才是真正的效率碾压。
**统一内存架构(Unified Memory Architecture)**是苹果Apple Silicon的核心设计理念:CPU、GPU和神经网络加速器共享同一物理内存池,数据无需在独立显存和系统内存之间来回搬运。传统PC架构中,GPU拥有独立的VRAM(如5090的32GB GDDR7),CPU使用独立的DDR5系统内存,两者之间通过PCIe总线通信,带宽上限约为64GB/s(PCIe 5.0 x16)。而M5 Ultra的统一内存带宽可达800GB/s以上,且CPU与GPU访问同一地址空间,延迟极低。当大型语言模型参数超出GPU显存容量时,NVIDIA方案必须将溢出部分存入系统内存,每次推理都要反复穿越PCIe总线,这正是70B模型测试中5090速度骤降的根本原因。
MLX框架是苹果专为Apple Silicon设计的机器学习框架,针对统一内存访问模式深度优化,能充分利用GPU和CPU的共享内存带宽。GGUF格式(GPT-Generated Unified Format)则是目前最主流的跨平台量化模型格式,可在不同硬件上通用运行,但不如平台原生框架性能最优。测试中对小模型混用两种格式,使得平台间的直接性能比较存在一定变量。
视频剪辑与游戏:优化决定一切
视频剪辑同样是GPU吃重的场景。DaVinci Resolve Studio中导出10分钟4K H.265时间线,M5 Ultra和5090几乎同时完成,双方硬件编码器(苹果媒体引擎 vs NVIDIA NVENC)打成平手。
但到了Adobe Premiere Pro,情况就有意思了。一段4K项目导出,M5 Ultra用时不到5090+9950X3D的一半。更让作者惊讶的是,他日常剪片用的MacBook Pro导出速度基本追平了那套9000美元的5090配置——足见Adobe在Apple Silicon上的优化有多到位。
游戏是唯一被PC完全碾压的领域。Cyberpunk、博德之门3、全面战争战锤中,5090大幅领先。即便在通过Crossover转译层运行的Pragmata里,Mac也明显落后。但作者也指出,前三款是Apple Silicon原生支持,而转译层运行本身就会损失大量性能。没人会花9000美元买5090只为打游戏,重点是——现在Mac已经能凑合玩游戏了,这在五年前是不可想象的。
Crossover是由CodeWeavers开发的商业软件,基于开源的Wine兼容层,允许macOS运行为Windows编写的应用程序和游戏,无需安装Windows本身。其原理是将Windows API调用实时翻译为对应的macOS系统调用,同时在Apple Silicon上还需额外进行x86指令集到ARM架构的转译(通过Rosetta 2机制),双重翻译带来的性能损耗相当可观,通常在30%至60%之间,这也是Mac版游戏帧率显著低于PC的重要原因之一。相比之下,原生适配Apple Silicon的游戏(如文中提到的全面战争战锤通过Metal API运行)性能损耗要小得多,但即便如此仍与5090有较大差距,主要原因是M5 Ultra的GPU规格按通用计算和内容创作而非游戏光栅化吞吐量设计。
硬件细节与购买建议
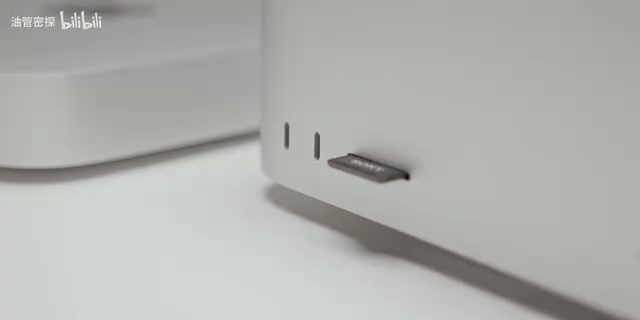
硬件设计上M5 Ultra Mac Studio变化不大,沿用同样的机身和I/O布局:六个Thunderbolt 5接口、HDMI 2.1、10Gb网口,以及全尺寸USB-A口和SDXC读卡器——对需要频繁从相机导素材的创作者来说非常实用。
几点购买提醒值得注意:
- PC当前价格被RTX 5090严重推高,其价格已达MSRP近三倍,但Mac Studio本身也不便宜,256GB配置贵得离谱。
- 大部分测试并未把统一内存推到极限,这份余量对本地AI开发才是真正的差异化优势——普通桌面PC根本无法提供这种规模的统一内存。
- M5 Ultra配置目前面临16到18周的交货延迟,四个月里价格随时可能变动。
- 如果单纯追求CPU算力,PC那边对标的应该是Threadripper而非9950X3D。但一套Threadripper Pro 9975WX(32核64线程)加5090的整机成本会超过1.4万美元,价值对比会更复杂。
结论其实很清晰:如果你是需要本地加载大型前沿模型的AI开发者,Mac Studio是一台非常能打的机器;而在其他大多数场景下,M5 Ultra和PC的性能差距远没有你想象的那么大。最终还是取决于你的工作类型和所用软件——如果你的工作流能吃到Apple Silicon的优化红利,这台机器会飞起来。
相关推荐

Qwen 3.8编程击败Opus,你的Mac能跑吗?
Qwen 3.8开源模型在编程测试中击败Opus 4.6,仅18GB大小,但你的Mac需要多少内存?实测显示24GB会崩溃,32GB才是甜点区,本文详解各档Mac配置的实际表现与上手方法。

Claude Code + Agent:打造AI全自动测试闭环
B站课程解读:测试开发如何用 Claude Code 终端型 Agent 打造 AI 全自动测试闭环。对比终端型与设备型 Agent 的权限边界,讲清企业级项目为何选 Claude Code 而非 Open Claude 类工具,并梳理 Node.js 环境准备与 DeepSeek 模型搭配的落地路径。

与AI智能体共事,你需要钢铁般的神经
AI智能体越自主,使用者的心理负担反而越重。本文从Hacker News讨论出发,分析智能体协作中的黑箱焦虑、行为漂移与监控疲劳,并给出沙箱隔离、权限控制、任务粒度管理等降低认知负荷的实用思路。