Mac本地部署LLM完全指南:Ollama接入AI编程工具实战

在AI编程工具日益普及的今天,如何在Mac上本地部署大语言模型并接入开发工具,成为许多开发者关注的话题。本文将详细介绍在Mac电脑上部署LLM的完整流程,帮助你在无需API Key的情况下实现AI辅助编程。
为什么选择本地部署LLM
本地部署大语言模型的核心优势在于数据隐私和成本控制。当处理敏感代码或私密内容时,本地模型能完全保护数据不外泄——所有推理计算都在本机完成,代码片段和对话内容不会经过任何第三方服务器。同时,对于高频使用场景,本地部署可以避免持续的API调用费用。以OpenAI的GPT-4 API为例,按token计费的模式下,一个活跃开发者每月的API费用可能达到数十甚至上百美元,而本地部署的边际成本仅为电费。虽然性能可能不如GPT-4或Claude 3.5 Sonnet等商业模型,但对于日常编程辅助、文档撰写等场景已经足够。此外,本地部署还具备离线可用的优势,在没有网络连接的环境下(如飞机上、保密场所)依然可以正常使用。
Mac本地部署LLM的四个关键步骤
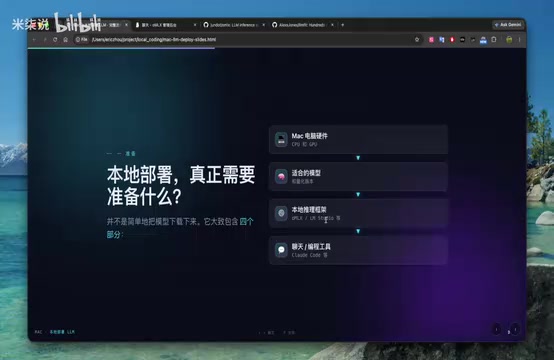
硬件评估:了解你的Mac性能
在部署前,首先需要评估Mac的硬件配置。关键参数包括:
- 内存容量:建议至少16GB,32GB以上更佳
- GPU核心数:M系列芯片的GPU核心数直接影响推理速度
- 存储空间:模型文件通常需要几GB到几十GB空间
以36GB内存、30核GPU的Mac为例,这样的配置可以流畅运行中等规模的量化模型。可以使用LMSYS等工具评估设备适配性,该工具会根据你的硬件配置推荐适合的模型列表。
值得特别说明的是,Apple Silicon(M1/M2/M3/M4系列芯片)采用了统一内存架构(UMA),这与传统PC的分离式架构有本质区别。在传统PC上,运行大语言模型需要将模型权重加载到GPU显存中,而消费级显卡的显存通常只有8-24GB,严重限制了可运行的模型规模。而在Apple Silicon上,CPU和GPU共享同一块物理内存,36GB的统一内存意味着GPU可以直接访问全部内存空间,无需数据拷贝。这一架构优势使得Mac在运行大语言模型时具有独特的性价比。
模型选择:找到适合你的大语言模型
模型选择需要平衡性能、内存占用和实际效果。推荐四类适合Mac部署的模型:
通义千问35B-A3B:这是一个MoE(混合专家)架构模型,虽然总参数35B,但激活参数仅3B。这意味着运行时内存占用相当于3B模型,但保留了大模型的能力。3bit量化版本进一步降低了内存需求。
MoE架构深度解析:MoE(Mixture of Experts)是近年来大语言模型领域最重要的架构创新之一。传统的Dense模型(如LLaMA系列)在推理时会激活所有参数,计算开销与参数量成正比。而MoE模型将参数分散到多个"专家网络"中,每次推理时通过一个"门控网络"(Gating Network)动态选择少量专家参与计算。Google的Switch Transformer和Mistral的Mixtral 8x7B都是这一架构的代表作。核心优势在于:模型可以拥有庞大的参数总量以存储更多知识,但实际计算开销仅取决于被激活的专家数量,从而在能力和效率之间取得最佳平衡。
26B-A4B系列:类似架构,激活参数4B,适合内存稍大的设备。
GPT-OSS 20B:OpenAI开源的专家模型,在代码生成任务上有不错表现。
定制微调模型:在Hugging Face社区可以找到针对特定任务微调的版本,如专注代码推理的4.6bit量化模型。Hugging Face是目前全球最大的开源模型托管平台,拥有超过百万个模型和数据集,开发者可以根据模型卡片(Model Card)中的评测结果和社区反馈来选择最适合自己场景的模型。
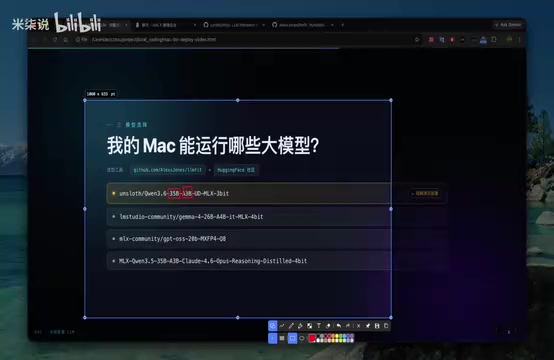
理解MoE架构至关重要:35B-A3B中,35B是总参数规模,A3B表示Active 3B即激活参数。推理时只有3B参数真正工作,其余32B作为「专家库」按需调用。这大幅降低了内存压力,让Mac也能运行看似庞大的模型。
关于量化技术:量化(Quantization)是将模型参数从高精度浮点数(如FP16,每个参数占16bit)压缩为低精度表示(如4bit、3bit)的技术。原始的7B参数模型使用FP16格式需要约14GB内存,通过4bit量化可降至约3.5GB,3bit量化更低至约2.6GB。常见的量化方法包括GPTQ(逐层量化,GPU友好)、AWQ(激活感知量化,保留关键精度)和GGUF(llama.cpp生态的通用格式,CPU/GPU混合推理友好)。一般认为4bit量化是精度和压缩率的最佳平衡点,输出质量与原始模型差异极小;3bit量化虽进一步节省内存,但在复杂推理任务上可能出现明显的质量下降。
Ollama部署框架:M芯片的最佳选择
推理框架的选择直接影响性能。对于M系列芯片的Mac,Ollama是最优选择:
- 原生MLX支持:MLX是苹果官方的AI推理框架,Ollama对其深度优化,能充分发挥硬件加速能力
- 内存管理:支持将非热点数据缓存到SSD,内存不足时自动调度
- 易用性:安装简单,命令行一键启动
- 社区活跃:GitHub上已有18.5K stars,文档完善
MLX框架与Apple Silicon的协同优势:MLX是苹果在2023年底开源的机器学习框架,专为Apple Silicon设计。与NVIDIA GPU生态中的CUDA框架不同,MLX充分利用了统一内存架构的特性,模型权重无需在CPU内存和GPU显存之间来回拷贝,大幅减少了数据搬运的延迟。此外,MLX还针对Apple的Neural Engine(神经网络引擎,专用AI加速单元)和AMX(加速矩阵扩展)进行了优化。这意味着M系列芯片的多个计算单元可以协同工作,而不仅仅依赖GPU核心。Ollama在底层集成了MLX支持,用户无需手动配置复杂的编译环境即可获得硬件加速。
安装命令:
brew install ollama
启动模型:
ollama run qwen:35b-a3b-q3
加载模型后,可在设置界面实时监控运行状态、内存占用和token生成速度。测试显示,在36GB内存的Mac上运行千问35B-A3B模型,内存占用约27-30GB,token生成速度可达53 tokens/秒。
理解Token生成速度:53 tokens/秒是衡量模型推理性能的核心指标。大语言模型将文本分割为token(词元)进行处理——一个英文单词通常对应1-3个token,一个中文字符通常对应1-2个token。因此53 tokens/秒大约相当于每秒输出25-40个英文单词或25-50个中文字符,接近人类快速阅读的速度,在交互式编程辅助中体验良好。作为对比,ChatGPT的云端API通常能达到80-120 tokens/秒。影响生成速度的关键因素包括内存带宽(决定模型权重的读取速度)、模型参数量(越大则每个token计算量越大)以及上下文长度(随对话变长,注意力机制的计算开销会增加)。
接入AI编程工具:打通开发工作流
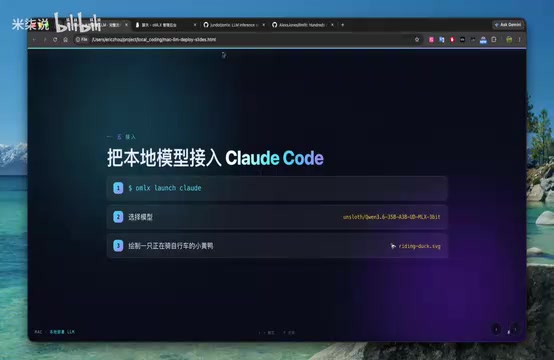
将本地模型接入AI编程工具可大幅提升开发效率。配置步骤:
- 在Ollama中启动模型并启用API服务
- 在编程工具的设置中添加自定义LLM端点
- 指向本地地址(通常是
http://localhost:11434) - 选择已加载的模型名称
Ollama的API兼容性生态:Ollama不仅是一个模型运行工具,它还提供了兼容OpenAI API格式的本地HTTP服务。这意味着几乎所有支持OpenAI API的开发工具——包括VS Code中的Continue插件、Cursor编辑器、Cline、以及各种Copilot替代方案——都可以通过简单修改API端点地址来接入本地模型,无需任何代码改动。Ollama默认在11434端口启动REST API服务,支持
/api/chat和/api/generate等端点,同时也兼容/v1/chat/completions等OpenAI格式端点。开发者还可以通过设置OLLAMA_HOST=0.0.0.0环境变量来允许局域网内其他设备访问,实现团队共享本地模型的效果。
配置完成后,即可在代码编辑器中直接调用本地模型进行代码生成、重构、调试等操作。常见的使用场景包括:在编辑器中选中一段代码后要求模型解释其逻辑、生成对应的单元测试、或将代码重构为更优雅的实现。由于所有请求都在本机处理,响应延迟极低,通常在毫秒级别即可开始返回结果。
实战测试:生成SVG小黄鸭骑车图
为测试模型实际效果,我们让四个不同模型生成同一个任务:画一只骑自行车的小黄鸭SVG图。选择SVG生成作为测试任务是因为它同时考验模型的代码能力(SVG本质上是XML格式的代码)、空间推理能力(需要正确安排各图形元素的位置和比例关系)以及创意表达能力。
千问35B-A3B表现:能生成相对完整的SVG结构,自行车轮廓基本清晰,鸭子形态识别度较高,色调协调。生成耗时约4分钟,token速度53/秒。
26B-A4B表现:细节处理不如35B版本,车把和座椅结构简化,但整体可用。
GPT-OSS 20B表现:在SVG任务上表现较弱,未能完整绘制车体和鸭子。
定制微调模型:图形生成不理想,轮胎和车身结构不清晰。
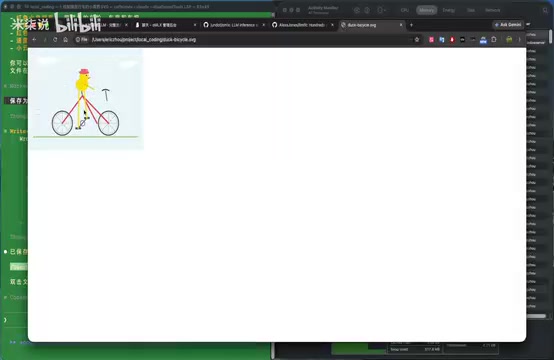
测试结论:千问35B-A3B在综合表现上最优,虽然不及GPT-4或Claude 3.5,但对于本地免费方案已属可用水平。这也印证了MoE架构的优势——在相同的计算资源下,MoE模型通过其更大的参数总量存储了更丰富的知识(包括SVG语法和图形布局的经验),同时保持了较低的推理开销。
性能优化建议
- 关闭后台应用:浏览器和录屏软件会占用大量内存,部署时建议关闭。在macOS的活动监视器中可以查看各进程的内存占用,Chrome浏览器开启多个标签页可能占用数GB内存
- 选择合适量化版本:4bit量化是性能和精度的平衡点,3bit可进一步降低内存。建议先尝试4bit版本评估效果,若内存紧张再降至3bit
- 利用SSD缓存:Ollama的内存溢出自动调度到SSD,确保SSD有足够空间。Apple Silicon Mac的SSD读取速度可达数GB/秒,虽然比内存慢一个数量级,但仍能提供可接受的性能回退
- 首次加载预热:初次运行会较慢,因为需要将模型文件从磁盘加载到内存并进行初始化。二次调用时模型已在内存中驻留,响应速度明显提升
- 调整上下文窗口大小:默认的上下文长度(如4096或8192 tokens)会占用额外内存用于KV Cache。如果任务不需要很长的上下文,适当缩小该参数可以释放内存用于模型本身
适用场景与局限
适合场景:
- 编写文档、注释、测试用例等辅助性代码
- 日常脚本和工具开发
- 代码重构和优化建议
- 隐私敏感项目的开发辅助
- 离线开发环境(如无网络的安全区域或差旅途中)
局限性:
- 复杂算法和架构设计能力不如商业模型。这主要是因为本地可运行的模型参数规模(有效激活参数通常在3B-20B之间)远小于GPT-4(据推测超过1万亿参数的MoE架构)等商业模型
- 生成速度受硬件限制。虽然53 tokens/秒已经可用,但在生成大段代码时仍需等待数分钟
- 上下文窗口通常较小。受内存限制,本地模型的上下文长度通常设置在4K-8K tokens,而商业模型已普遍支持128K甚至更长的上下文,这意味着本地模型难以处理需要理解大量代码文件的复杂任务
总结
在Mac上本地部署LLM并接入AI编程工具,是一个值得尝试的技术实践。虽然效果无法与顶级商业模型媲美,但在数据隐私、成本控制和离线可用性上具有独特优势。通过合理的硬件评估、模型选择和框架配置,即使是36GB内存的Mac也能流畅运行中等规模的大语言模型,满足日常开发需求。
随着开源模型社区的快速发展,本地可运行的模型能力正在不断提升。从2023年的LLaMA 7B到2024年的各种MoE架构模型,开源模型与商业模型的差距正在逐步缩小。未来随着Apple Silicon芯片内存容量的持续增长(Mac Studio已支持最高192GB统一内存)和模型压缩技术的进步,本地AI编程助手的实用性将进一步提升。
对于追求隐私保护或希望降低AI使用成本的开发者,本地部署LLM是一个值得深入探索的方向。
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。