MaxIM:强化学习驱动的最优信息增量摘要框架

MaxIM框架通过信息论奖励塑形解决增量摘要中的信用分配瓶颈,在长视野任务上超越RL等基线。
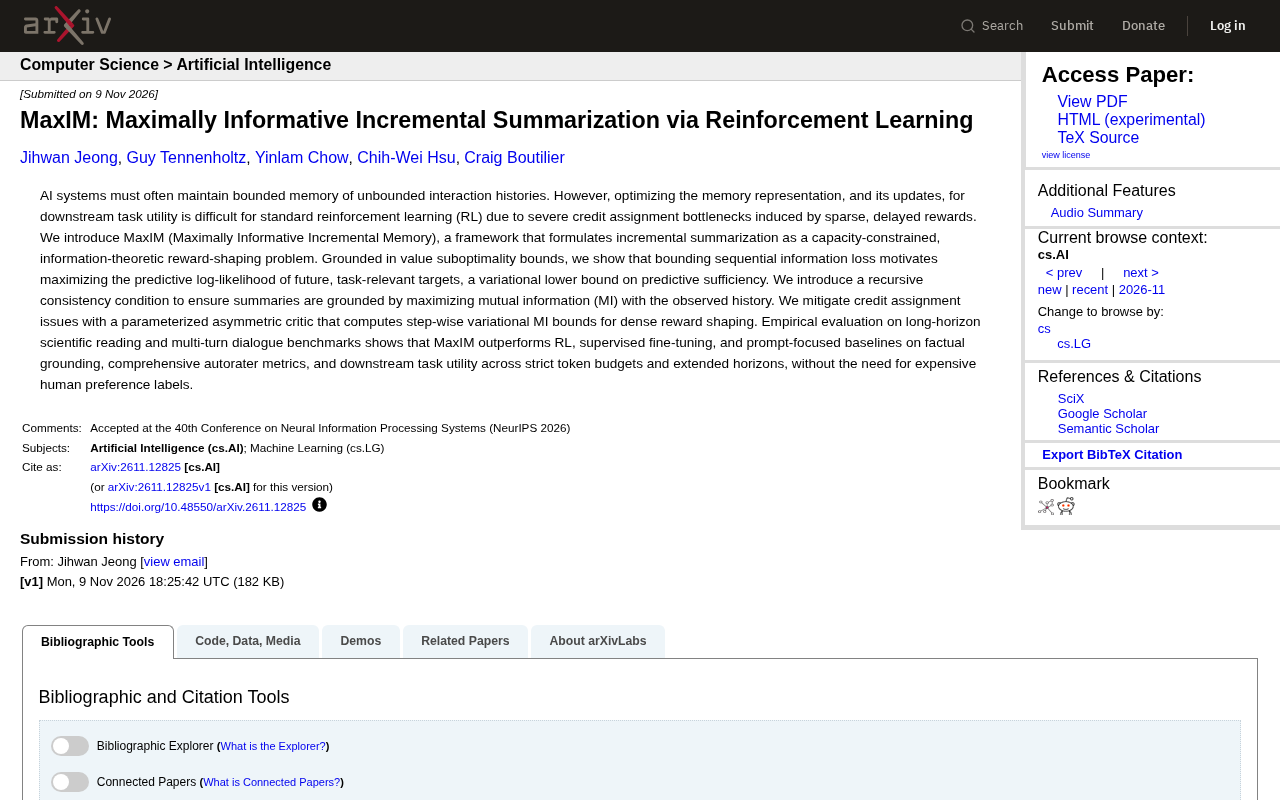
本文提出MaxIM框架,将AI系统的增量摘要形式化为容量约束下的信息论奖励塑形问题。针对标准强化学习因稀疏延迟奖励导致的信用分配瓶颈,MaxIM基于价值次优性界证明限制信息损失可最大化未来任务相关目标的预测对数似然,并引入递归一致性条件确保摘要与历史互信息最大化。同时,参数化非对称评论家计算逐步变分互信息下界,提供密集奖励信号。在长视野科学阅读和多轮对话基准上,MaxIM在事实基础、自动评估指标和下游任务效用上均优于RL、监督微调和提示聚焦基线,且无需人工偏好标签。
引言
AI系统在处理无界交互历史时,往往需要维护有界的内存。然而,如何优化内存表示及其更新以提升下游任务效用,对标准强化学习(RL)而言十分困难,这主要源于稀疏、延迟奖励导致的严重信用分配瓶颈。本文介绍MaxIM(Maximally Informative Incremental Memory)框架,该框架将增量摘要形式化为容量约束下的信息论奖励塑形问题,通过理论分析和实验验证,在多个长视野任务上超越了RL、监督微调等基线方法。
核心问题与挑战
AI系统面临的核心矛盾在于:交互历史无限增长,但内存容量有限。为此,系统需要持续进行增量摘要,将历史压缩为紧凑表示,同时保留对下游任务有用的信息。标准RL方法通过稀疏的延迟奖励优化摘要策略,但存在信用分配难题——难以判断历史中哪些部分对最终奖励有贡献。
MaxIM的提出正是为了解决这一瓶颈。它从信息论角度出发,将摘要过程建模为容量约束下的信息最大化问题,并设计密集奖励塑造机制来缓解信用分配问题。
信用分配问题(Credit Assignment Problem) 是强化学习中的核心难题之一,指当智能体在多个时间步上执行动作后仅获得延迟且稀疏的奖励信号时,难以判断哪些具体动作或状态对最终奖励产生了贡献。在增量摘要场景中,摘要策略在每一步对历史信息进行压缩,但下游任务的奖励往往只在序列末尾出现,导致模型无法有效学习中间步骤的优劣。传统方法如蒙特卡洛回报或时序差分学习在高方差和稀疏奖励下表现不佳,因此需要密集奖励塑形或辅助任务来缓解这一问题。MaxIM通过信息论下界提供逐步奖励信号,正是针对此瓶颈的设计。
方法:信息论奖励塑形与递归一致性
MaxIM的理论基础是价值次优性界(value suboptimality bounds)。作者证明,限制序列信息损失可以促使最大化未来任务相关目标的预测对数似然,这是预测充分性的变分下界。简言之,好的摘要应能准确预测未来任务所需的信息。
为实现这一点,MaxIM引入递归一致性条件,通过最大化摘要与观察历史的互信息(MI)来确保摘要基于历史。具体而言,摘要的更新需满足递归一致性,即新摘要应保留与历史的最大互信息。
信用分配问题通过参数化的非对称评论家(asymmetric critic)缓解。该评论家计算逐步的变分互信息下界,提供密集奖励信号,引导策略学习。这种设计避免了稀疏奖励下的高方差问题,同时无需昂贵的人工偏好标签。
变分下界(Variational Lower Bound) 是信息论和变分推断中的常用工具,用于在难以直接计算互信息或对数似然时提供可优化的下界。具体而言,当真实后验分布不可解时,通过引入参数化的变分分布来近似,并利用Jensen不等式推导出对数似然的下界。MaxIM中提到的“预测对数似然的变分下界”即指:通过最大化该下界,间接最大化未来任务相关目标的预测似然,从而确保摘要保留预测充分性所需的信息。这一技巧使得互信息的计算变得可微且易于通过神经网络优化,是非对称评论家提供密集奖励的理论基础。
互信息(Mutual Information, MI) 衡量两个随机变量之间的统计依赖程度,定义为联合分布与边缘分布乘积之间的KL散度。在MaxIM中,互信息被用于量化摘要与观察历史之间的信息重叠:递归一致性条件要求新摘要与历史之间的互信息最大化,以确保摘要不丢失历史中的关键信息。然而,互信息的精确计算通常涉及高维积分,难以直接处理,因此采用变分下界进行估计。通过最大化该下界,模型能够学习到既紧凑又信息丰富的摘要表示,避免退化为无关或冗余的压缩。
实验评估:长视野任务上的优势
MaxIM在长视野科学阅读和多轮对话基准上进行了实证评估。实验结果显示,在严格令牌预算和扩展视野下,MaxIM在事实基础、综合自动评估指标和下游任务效用上均优于RL、监督微调和提示聚焦基线。
有意思的是,MaxIM无需人工偏好标签,这大大降低了数据标注成本。在科学阅读任务中,模型需要从长文档中提取关键信息并回答后续问题;在多轮对话中,模型需维护对话状态以生成连贯响应。MaxIM在这些场景中均表现出色,验证了其信息论奖励塑形的有效性。
长视野任务(Long-Horizon Tasks) 指决策序列跨度较长、奖励延迟显著的任务场景,如长文档阅读理解和多轮对话。这类任务对记忆管理提出更高要求:模型需要在有限令牌预算下保留跨越多步的历史信息,并利用这些信息进行后续推理。与短视野任务相比,长视野任务中的信用分配问题更为严峻,因为奖励信号与关键决策之间的时间间隔更大,稀疏性更强。MaxIM在科学阅读和多轮对话基准上的评估,正是为了验证其在长视野条件下维持信息充分性和任务效用的能力。
结论与展望
MaxIM通过信息论奖励塑形和递归一致性条件,有效解决了增量摘要中的信用分配瓶颈,在多个基准上取得领先性能。未来工作可探索更复杂的任务场景和更高效的计算实现。该框架为强化学习在记忆管理中的应用提供了新思路。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。