MCP 服务器从单用户到多并发:教程止步之处的生产化难题

MCP教程普遍止步于hello world,多用户并发超时的根源在于阻塞I/O、状态共享与资源池耗尽等通用后端工程问题。
一位开发者在Reddit分享了一个普遍痛点:自建MCP服务器单用户运行正常,第二个用户接入即出现大量超时,而现有教程几乎全部止步于localhost的最简示例,对生产环境的并发问题只字不提。文章分析了"双用户即崩"的三大根源:同步阻塞代码独占事件循环、多客户端之间错误共享会话状态、以及数据库连接池等底层资源耗尽。解决路径并非寻找MCP专属进阶教程,而是回归通用后端工程实践——加可观测性日志、本地脚本模拟并发压测、确保I/O链路完全异步化、显式配置资源池上限、以及为每个客户端会话隔离独立状态。MCP服务器本质上仍是网络服务,面对的扩展性挑战与任何Web后端无异,补齐传统服务端工程能力比追逐MCP专属答案更能解决实际问题。
一个被所有教程忽略的真实痛点
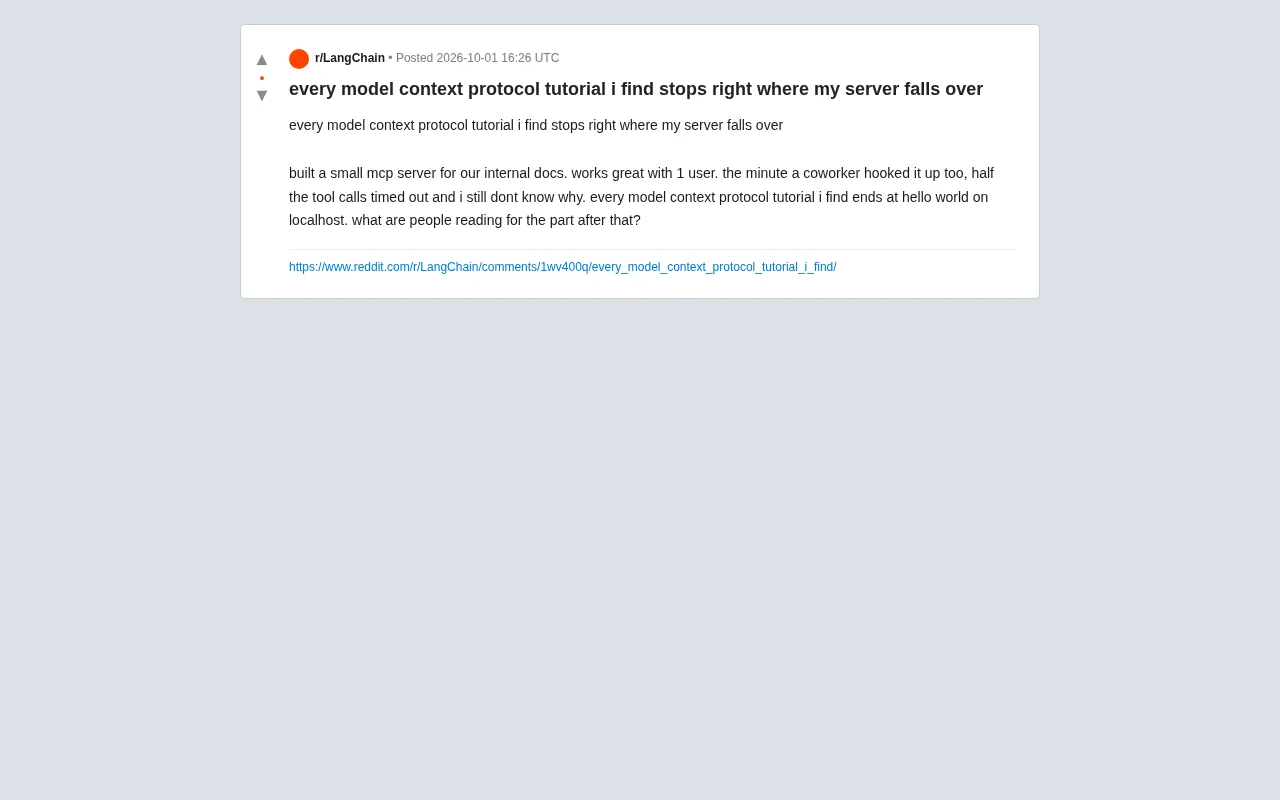
一位开发者在 Reddit 上提出了让许多人共鸣的问题:他为公司内部文档搭建了一个小型 MCP(Model Context Protocol)服务器,单人使用时运行流畅,可一旦同事也接入进来,一半的工具调用就开始超时,而他至今不清楚原因。
他的抱怨一针见血:"每一篇我能找到的 MCP 教程都止步于 localhost 上的 hello world。"这句话点破了当前 MCP 生态的一个结构性缺口——教学内容普遍停留在"跑起来"的阶段,却几乎不触及"扛得住"的生产环境问题。
这并非个例。MCP 作为连接大语言模型与外部工具、数据源的协议,正在快速普及,但多数入门资料聚焦于协议语法和最简示例,对并发、超时、连接管理等工程化细节讳莫如深。当服务器从一个用户扩展到两个用户就崩溃时,开发者往往发现自己手里没有任何可参考的进阶路径。
为什么第二个用户就能压垮服务器
从"1 个用户正常、2 个用户超时"这种现象判断,问题大概率不在 MCP 协议本身,而在服务器的并发处理模型。这类故障有几个常见根源,值得逐一排查。
阻塞式 I/O 与单线程事件循环
许多 MCP 服务器的简易实现采用同步阻塞调用。单用户时,请求串行执行感知不到问题;但当两个用户的工具调用几乎同时到达,一个长耗时操作(比如文档检索或外部 API 请求)会阻塞整个事件循环,导致后续调用排队直至超时。解决方向是确保 I/O 操作真正异步化,避免在事件循环中执行同步阻塞代码。
Node.js 和 Python 的 asyncio 是 MCP 服务器最常用的两种运行时,二者都基于单线程事件循环模型。这意味着任何未被正确异步化的操作——例如用同步文件读取替代异步读取,或在 async 函数中调用了内部含阻塞系统调用的第三方库——都会独占 CPU 或等待队列,让整个进程在此期间无法响应其他请求。Python 中常见的陷阱是在 asyncio 协程里直接调用 requests 库(同步 HTTP)而非 httpx 或 aiohttp;Node.js 中则是误用 fs.readFileSync 或 CPU 密集型的 JSON 解析未经 worker_threads 卸载。识别此类问题可借助事件循环延迟监控工具,如 Node.js 的 clinic.js 或 Python 的 aiomonitor,它们能直接显示事件循环被阻塞的时长与位置。
连接与会话状态管理
MCP 的传输层(无论是 stdio 还是基于 HTTP/SSE 的长连接)在多客户端场景下需要独立维护每个会话的状态。如果服务器错误地在客户端之间共享了某些有状态资源(如单一数据库连接、全局缓存、未隔离的上下文),并发请求就会相互干扰,表现为随机超时或数据错乱。
MCP 支持两种主要传输层:stdio 模式适用于本地单进程场景,客户端与服务器通过标准输入输出通信;HTTP/SSE(Server-Sent Events)模式则面向多客户端网络部署,服务器通过长连接持续向客户端推送消息。在 HTTP/SSE 模式下,每个客户端连接对应一条独立的 SSE 流,服务器必须为每条流维护独立的会话上下文。如果服务器使用全局变量存储"当前会话的工具调用状态",两个并发客户端就会相互覆盖彼此的状态,造成结果错乱或请求挂起。正确的做法是以连接 ID 或会话 ID 为键,将所有会话相关数据存储在隔离的字典或对象中,并在连接断开时显式清理。
资源池耗尽
底层依赖——数据库连接池、HTTP 客户端连接数、文件句柄——往往有默认上限。单用户时远未触及,双用户并发却可能瞬间打满,让新请求无限等待。检查这些池的配置上限和超时设置,通常能定位到问题。
教程止步之后,应该读什么
原帖最核心的诉求是:"hello world 之后,大家都在读什么?"这个问题暴露了学习资源的断层。要跨越从 demo 到生产的鸿沟,需要把视野从"MCP 协议"本身扩展到通用的服务端工程实践。
一方面,官方的 MCP 规范文档会说明传输层机制、会话生命周期和消息格式,这是理解并发行为的基础。另一方面,真正解决崩溃问题的知识大多不在 MCP 语境里,而在通用的异步编程、服务端架构和可观测性领域:如何做并发压力测试、如何配置连接池、如何给工具调用设置合理的超时与重试、如何通过日志和链路追踪定位阻塞点。
换句话说,MCP 服务器本质上仍是一个网络服务,它要面对的所有扩展性挑战,与任何 Web 后端服务并无二致。把它当成普通后端服务来做容量规划和压测,往往比四处寻找"MCP 进阶教程"更有效。
可观测性(Observability)是指通过系统对外暴露的信号——日志、指标、链路追踪——来理解其内部状态的能力。对于 MCP 服务器,最基础的可观测性实践是在每次工具调用的入口记录请求时间戳与参数摘要,在出口记录耗时与结果状态。更进一步可引入分布式追踪,如 OpenTelemetry,为每次调用生成唯一 Trace ID,从而在多步骤工具链中准确定位哪一跳产生了延迟。指标层面则应监控事件循环延迟、连接池利用率、工具调用的 P95/P99 耗时等,这些数据能让"偶发超时"变成可量化、可复现的工程问题,而不是依赖主观感受来猜测根因。
给遇到同样问题的开发者的实用建议
面对"多用户就超时"的具体故障,可以按以下顺序动手排查:
- 先加可观测性:在工具调用的入口和出口打上耗时日志,确认到底是哪个环节超时——是请求排队、是下游 I/O,还是协议握手。没有数据的猜测只会浪费时间。
- 本地复现并发:用脚本模拟多个客户端同时发起调用,而不是等真实同事来触发。能稳定复现,才能稳定修复。
- 检查异步链路:确认从传输层到业务逻辑的调用链没有隐藏的同步阻塞,尤其是文档检索这类 I/O 密集操作。
- 调整资源池配置:显式设置数据库、HTTP 客户端的连接数上限与超时,避免默认值成为瓶颈。
- 隔离会话状态:确保每个客户端会话拥有独立的上下文,不与其他会话共享可变状态。
这位开发者的经历反映了一个新兴技术生态的典型阶段:协议和工具已经成熟到足以构建原型,但围绕生产部署的最佳实践尚未沉淀成易得的教程。在这个阶段,补齐传统服务端工程能力,比继续寻找 MCP 专属答案更能解决实际问题。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。