每个模板一次查询就够?学习型代价模型跨硬件适配

跨硬件迁移学习型代价模型时,分模板校正比全局缩放和神经微调更有效。
本文研究学习型代价模型跨硬件迁移的适配问题。作者在PostgreSQL上对1,162个TPC-H和TPC-DS查询的同一组计划,在六个不同硬件环境中计时,发现没有单一缩放因子能描述性能变化,方差主要来自查询模板。为此提出为串行和并行计划分别拟合直线并为每个已测量模板添加偏移量的校正方法,每个模板仅测量一个查询即可将迁移后误差降至1.10(TPC-H)和1.19(TPC-DS),接近重新训练的效果。神经模型微调最多提升2%,分模板校正更高效。未测量模板的校正效果与速度因子相当,提升有限;在Join Order Benchmark上模型误差达2.36,校正方法效果不佳。研究为实际系统迁移提供了清晰基准。
跨硬件迁移的代价模型难题
学习型代价模型通过预测查询运行时间,已成为数据库查询优化的关键工具。然而,这类模型通常只在单一机器上训练。当数据库迁移到新硬件时,查询计划本身不变,但执行时间会因硬件特性而按不同比例变化。如何用新机器上少量查询的测量结果来适配模型,成为实际部署中的核心问题。一项发表在arXiv上的研究系统性地回答了这个问题:应该测量哪些查询、如何使用它们的运行时间、以及需要多少查询才足够。
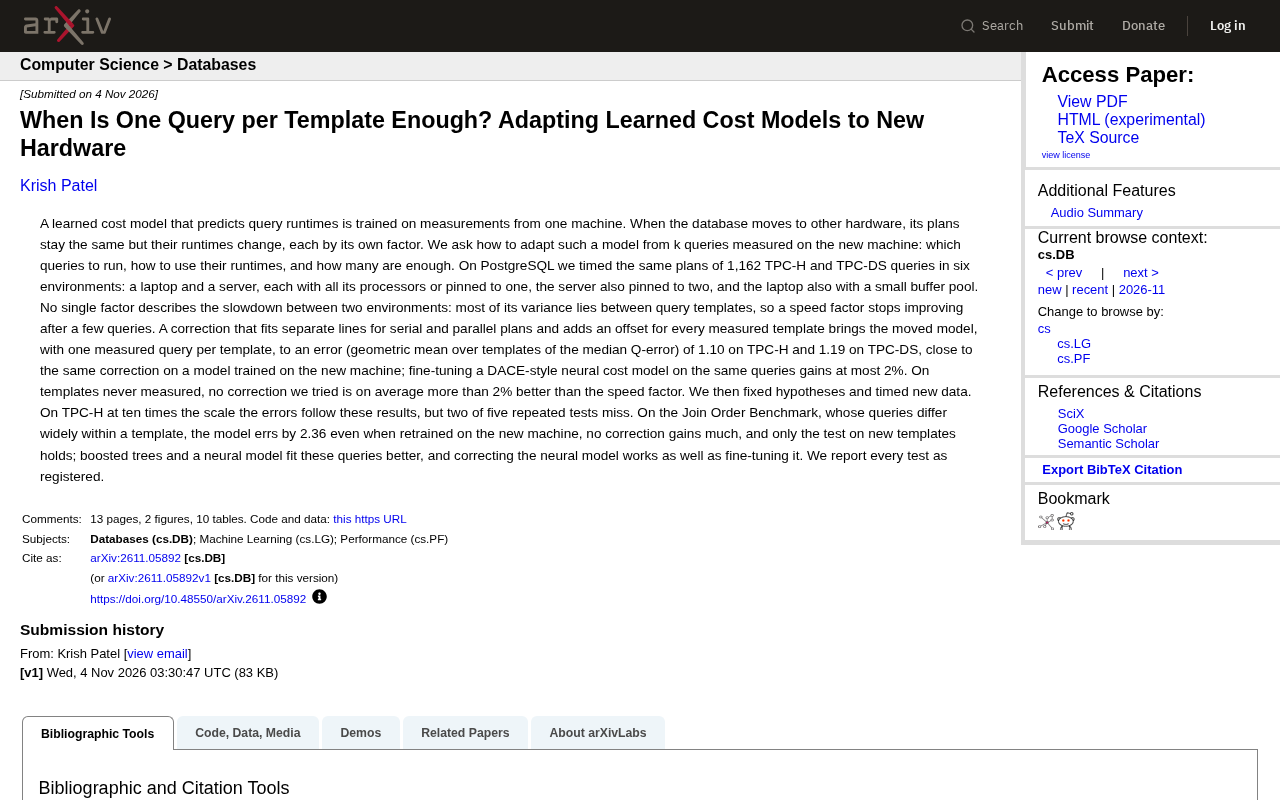
研究团队在PostgreSQL上对1,162个TPC-H和TPC-DS查询的同一组计划,在六个不同环境中进行了计时:笔记本电脑和服务器,各自使用全部处理器或绑定到单个核心,服务器还额外绑定到两个核心,笔记本电脑还配置了较小的缓冲池。这些环境覆盖了从单核到多核、从充足内存到受限内存的典型硬件差异。
学习型代价模型是指用机器学习模型(如神经网络、梯度提升树)替代传统代价模型中的手工公式,通过从大量查询执行数据中学习来预测查询运行时间或代价。传统代价模型依赖简化的成本公式和统计信息,难以捕捉复杂的非线性关系;学习型模型则能自动拟合这些关系,在单一硬件环境下往往精度更高。但其泛化能力受限于训练数据分布,当硬件配置变化时,模型输入(查询计划特征)不变但输出(执行时间)偏移,导致预测误差增大,因此需要适配策略。
没有单一缩放因子能描述性能变化
实验揭示了一个关键发现:没有任何单一因子能描述两个环境之间的减速。大部分方差存在于查询模板之间——不同模板的查询对硬件变化的敏感度差异巨大。这意味着,简单地用一个全局速度因子来缩放所有查询的预测时间,效果有限。速度因子在测量少量查询后就不再改善,因为模板间的差异主导了误差。
这一发现挑战了直觉:人们可能期望硬件性能差异可以用一个统一的倍数来近似,但实际数据表明,查询模板的多样性使得这种近似在模板级别上失效。研究强调,在迁移模型时,必须考虑模板级别的差异。
Q-error 是数据库领域评估基数或代价估计精度的常用指标,定义为估计值与真实值的比值(当估计值大于真实值时)或真实值与估计值的比值(当估计值小于真实值时),即 max(估计/真实, 真实/估计)。Q-error 为 1 表示完美估计,数值越大误差越大。本文使用“模板上中位 Q-error 的几何平均值”作为聚合指标,即先对每个查询模板计算其中位 Q-error,再对所有模板取几何平均,以平衡不同模板的权重。该指标对高估和低估同等惩罚,适合比较不同校正方法的效果。
每个模板一次查询的校正策略
研究提出了一种校正方法:为串行和并行计划分别拟合直线,并为每个已测量模板添加偏移量。使用这种校正,在TPC-H和TPC-DS上,每个模板仅测量一个查询,就能将迁移后的模型误差(模板上中位Q-error的几何平均值)降至1.10和1.19,接近在新机器上重新训练模型的校正效果。
作为对比,对DACE风格的神经代价模型在相同查询上进行微调,最多只能获得2%的提升。这表明,简单的分模板校正比复杂的神经微调更有效。然而,对于从未测量过的模板,任何校正方法平均都不比速度因子好超过2%。这意味着,未测量模板的预测仍然困难,需要额外的策略来应对。
DACE(Data-Aware Cost Estimator)是一种典型的学习型代价模型,它使用神经网络从查询计划中提取特征并预测执行时间,通常在大规模查询日志上训练。DACE 风格模型强调数据感知,即考虑表统计信息和谓词选择性。本文将其作为神经代价模型的代表进行对比:在相同查询上微调 DACE 模型,最多只能获得 2% 的误差提升,而简单的分模板线性校正却能大幅降低误差。这说明对于跨硬件适配,复杂的神经微调未必优于针对模板的轻量校正,可能因为微调容易过拟合少量新样本。
固定假设后的验证测试
为了验证结论的稳健性,研究团队固定了假设,并计时了新的数据。在TPC-H的十倍规模上,误差与之前的结果一致,但五次重复测试中有两次失败。这提示模型在规模扩展时存在一定的脆弱性。
在Join Order Benchmark上,查询在模板内差异很大,模型即使在新机器上重新训练,误差也达到2.36,且没有校正方法能显著改善,只有新模板上的测试成立。对于这类查询,提升树和神经模型拟合得更好,并且校正神经模型的效果与微调相当。研究将所有测试都作为注册报告进行了汇报,增强了结果的可信度。
实践启示与局限
这些发现为实际系统迁移提供了指导:当硬件变化时,测量每个查询模板的一个代表查询,并应用分模板校正,可以显著提升预测精度,且成本可控。然而,对于模板内差异大的负载(如Join Order Benchmark),需要更复杂的模型。未测量模板的预测仍需依赖速度因子,但精度有限。
研究的局限在于,实验仅基于PostgreSQL和特定硬件环境,结论的普适性需要进一步验证。此外,重复测试的失败率提示,在动态或规模化场景中,模型可能需要更频繁的更新。尽管如此,这项工作为学习型代价模型的跨硬件适配提供了清晰的基准和方向。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。