美国RTX 5090炒到9千美元?飞台北抢购反而更划算
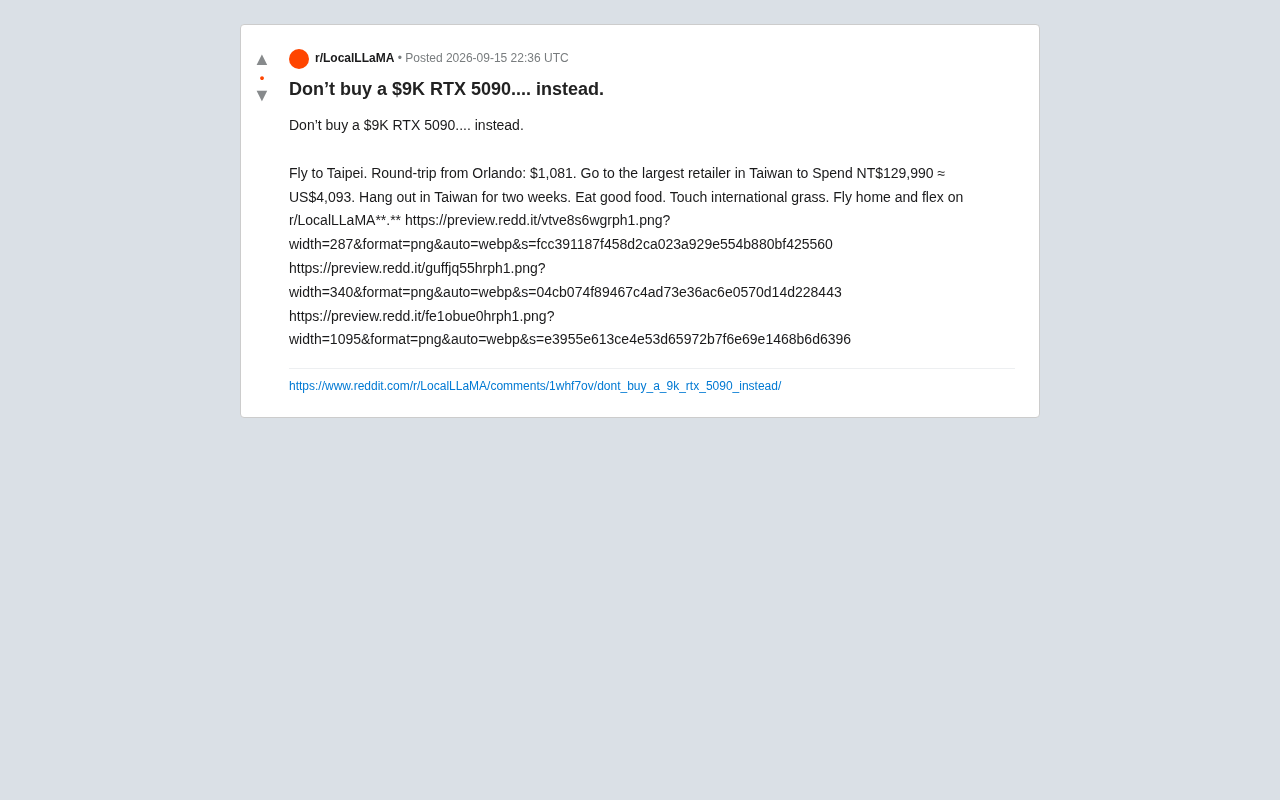
美国RTX 5090被炒至9000美元,Reddit网友算账飞台北买反而更划算,折射本地AI硬件供需严重失衡。
Reddit的LocalLLaMA社区近日流传一个帖子:与其在美国以9000美元黄牛价购买RTX 5090,不如花约5174美元飞一趟台北、以当地零售价买回同款显卡。这一「荒诞方案」背后有真实的市场逻辑——台湾作为半导体产业链核心,官方渠道供货充足,零售价维持在4000美元出头,而美国市场被游戏玩家、AI爱好者和算力囤货者共同推高,价差超过100%。本地部署大语言模型的热潮使RTX 5090的32GB显存成为稀缺资源,因为显存容量直接决定了可运行的模型规模上限。文章同时指出跨国购买存在保修地域限制、关税等隐性成本,并提醒用户:量化后的开源模型在24GB甚至更低显存的显卡上也能流畅运行,理性选型比盲目追逐旗舰卡更务实。
一张显卡引发的价格荒诞剧
近日,Reddit的LocalLLaMA社区里出现了一个颇具戏谑意味的帖子,标题直接开门见山:"别花9000美元买RTX 5090,不如换个思路。"这位网友的"替代方案"是——飞一趟台北。
帖子提供的账目相当具体:从奥兰多往返台北的机票约1081美元;抵达台湾后,到当地最大的零售商花费新台币129,990元(约合4093美元)买下同款显卡;再加上两周的旅行、吃好吃的、"接触一下国际的草坪",最后带着显卡飞回家,在社区里凡尔赛一番。
这套算下来,机票加显卡本体大约5174美元,即便算上两周吃住,也远低于美国本土被炒到9000美元的黄牛价。表面看是段子,实则戳中了当下高端显卡市场的一个真实痛点:区域价差已经大到能覆盖一趟跨太平洋的旅费。
价差背后的市场逻辑
RTX 5090作为面向AI推理和本地大模型部署的旗舰级消费显卡,其32GB显存和强悍算力让它成为本地跑大语言模型(LocalLLaMA正是这一群体的聚集地)的抢手货。当一款硬件同时被游戏玩家、AI爱好者和加密/算力囤货者盯上时,供需失衡几乎是必然结果。
美国市场9000美元的成交价,明显是黄牛与炒卖推高的结果,而非官方定价。相比之下,台湾作为半导体产业链的核心地带,靠近NVIDIA的代工与分销体系,官方渠道供货相对充足,零售价能维持在4000美元出头的合理区间。这种"离源头越近价格越正常"的现象,在半导体行业并不罕见。
帖子虽然是玩笑,但它用一个极端场景把区域套利的可能性摆到了台面上:当本地溢价超过100%时,跨国采购的经济账真的算得过来。
区域价差在半导体产品中有其结构性根源。NVIDIA将显卡委托给台积电(TSMC)代工晶圆,再经由台湾本地封测与板卡厂商(如华硕、技嘉、微星)组装成成品显卡。整条供应链的物理起点在台湾,因此台湾市场往往能获得相对优先的早期分配配额,且渠道层级更少、加价空间更窄。相较而言,显卡运至美国需经历更多中间环节,叠加需求侧的AI算力热潮,以及黄牛使用脚本抢购再高价转卖的行为,零售价被推高至官方建议零售价的两倍乃至更多并不罕见。这种「离产地越近、价格越接近正常」的现象,在过去GPU短缺周期(如2020-2022年的矿卡潮)中也曾反复出现。
从段子看本地AI硬件热潮
这个帖子能在LocalLLaMA社区引发共鸣,本质上反映了本地部署大模型的浪潮正在快速升温。越来越多的开发者和AI爱好者不满足于调用云端API,转而追求在自己的机器上运行开源模型,图的是数据隐私、可控性以及长期成本。
而本地跑模型对显存和算力的渴求,直接把RTX 5090这类高显存显卡推上了神坛。显存容量往往比纯算力更能决定你能加载多大的模型,这也是为什么32GB的5090会被社区如此追捧,甚至愿意为它跨国奔波。
需要理性看待的是,帖子里的方案存在不少现实门槛:跨国购买涉及保修地域限制、电压制式差异、海关申报与关税、以及可能的携带数量限制。真要执行,省下的钱未必能完全覆盖这些隐性成本和风险。
「显存决定模型上限」这一逻辑值得展开说明。大语言模型在推理时需要将模型权重完整加载到GPU显存中,一个70亿参数(7B)的模型以FP16精度存储约需14GB显存,130亿参数(13B)则需约26GB。如果显存不足,模型只能被迫卸载到内存或硬盘,推理速度会下降一到两个数量级,体验几近不可用。量化技术(如GGUF格式的Q4量化)可以将每个参数的存储位数从16位压缩到4位,使同样的显存能运行更大的模型,但会带来一定精度损失。RTX 5090的32GB显存意味着在不量化的情况下可完整加载一个约140亿参数的全精度模型,或经Q4量化后运行700亿参数级别的模型,这正是它对本地部署爱好者极具吸引力的根本原因。
荒诞背后的真问题
段子归段子,它折射出的却是高端AI硬件供需矛盾的严峻程度。当消费级显卡被赋予生产力工具的属性,其价格就不再只由游戏市场决定,而是被更庞大的AI算力需求所裹挟。
对普通用户而言,与其追逐被爆炒的旗舰卡,不如根据实际模型需求做理性选型——很多量化后的开源模型在24GB甚至更低显存的显卡上也能流畅运行。硬件的军备竞赛容易让人忽略:真正的瓶颈往往不在于是否拥有最顶级的卡,而在于如何高效地利用手里的资源。
这场"飞台北买显卡"的讨论,最终留给我们的或许是一个提醒:在AI硬件被炒上天的当下,保持清醒的成本意识,比盲目跟风更重要。
相关推荐
开源AI的真相:你拿到的只是蛋糕,不是配方
海外博主深度揭秘开源AI真相:你下载的只是权重(蛋糕),而非训练数据与代码(配方)。文章拆解开放权重与真正开源的差异,剖析Meta、阿里、DeepSeek的商业策略,以及中美欧三国政府如何用营收门槛与算力上限重画开放边界。
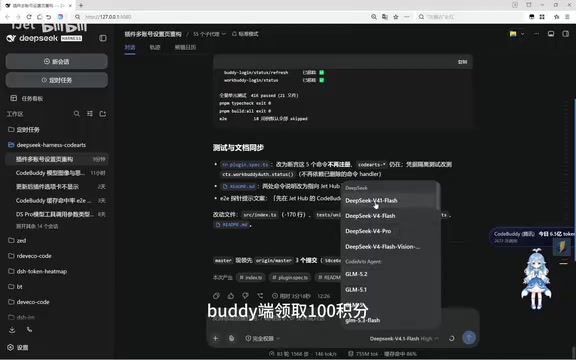
DSH白嫖DeepSeek V4.1 Flash:积分批量领取与国际版WorkBuddy实测
DSH项目最新升级实测:WorkBuddy端可批量领取100积分,限流额度提升、重置时间缩短,国际版WorkBuddy现已支持免费调用混元4与DeepSeek V4.1 Flash,附使用建议与风险提示。
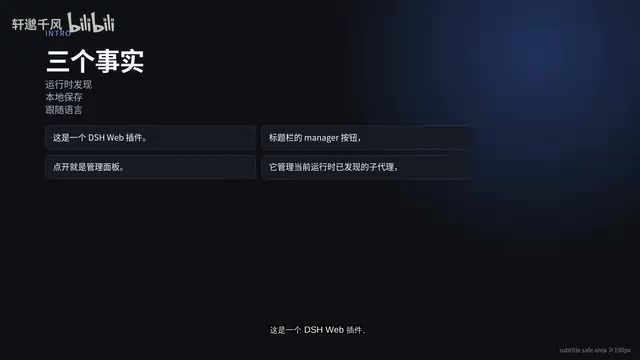
DSH-SUBAGENT-UI插件:DeepSeek Harness子代理管理神器
DSH-SUBAGENT-UI 是 DeepSeek Harness Web 客户端插件,提供子代理总览、搜索、本地分类与完成快照功能,数据存本地不侵入原会话,一条命令即可安装,助力多子代理工作流高效管理。