METIS-Core:纯C++强化学习框架,为生产环境剔除Python开销
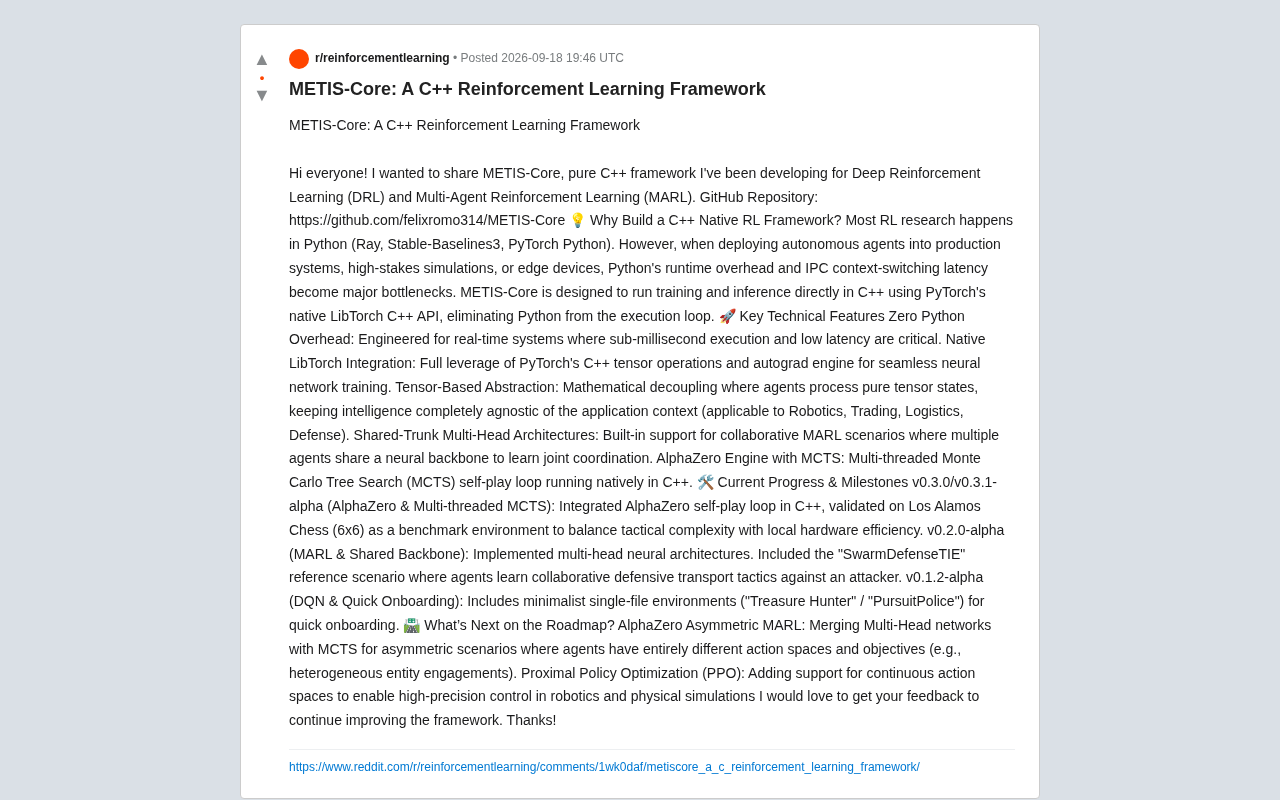
METIS-Core 是一个纯C++深度强化学习框架,基于LibTorch彻底移除Python运行时,专为低延迟生产部署而生。
METIS-Core 是开发者 Felix Romo 开源的纯 C++ 强化学习框架,通过直接调用 PyTorch 的原生 C++ 接口 LibTorch,将 Python 解释器从训练和推理循环中彻底剔除。项目针对机器人、高频交易、边缘设备等要求亚毫秒级延迟的场景,规避了 Python GIL、进程间通信和跨语言数据传输带来的性能损耗。框架已实现 DQN、基于共享主干的多头 MARL 架构,以及多线程 MCTS 驱动的 AlphaZero 自对弈引擎,并采用纯张量抽象层实现智能体逻辑与具体应用场景的解耦。项目目前处于 alpha 阶段,基准验证局限于 6×6 棋盘等小规模环境,路线图计划加入 PPO 以支持连续动作空间,并扩展至非对称 MARL 场景。对于关注 RL 部署工程化的开发者,这是一个值得跟踪的参考实现。
开发者 Felix Romo 在 Reddit 上分享了一个名为 METIS-Core 的开源项目——一个完全用 C++ 编写的深度强化学习(DRL)与多智能体强化学习(MARL)框架。它的核心卖点很直接:把 Python 从训练和推理的执行循环中彻底拿掉,直接调用 PyTorch 的原生 C++ 接口 LibTorch 运行。
对于长期在 Python 生态里做强化学习的研究者和工程师来说,这是一个值得关注的方向。它并不是要取代 Ray 或 Stable-Baselines3,而是瞄准了一个特定痛点:当训练好的智能体需要部署到生产系统、高风险仿真或边缘设备时,Python 的运行时开销究竟有多大代价。
为什么要做一个 C++ 原生的 RL 框架?
绝大多数强化学习研究都发生在 Python 世界——Ray、Stable-Baselines3、PyTorch 的 Python 前端构成了主流工具链。Python 的优势在于开发效率和生态丰富度,但作者指出,一旦把自主智能体推向真实生产环境,Python 的运行时开销和进程间通信(IPC)带来的上下文切换延迟就会成为严重瓶颈。
这个判断在实时控制场景中尤其成立。机器人控制、高频交易、边缘推理这类应用往往要求亚毫秒级的响应延迟,而 Python 解释器的额外开销、GIL 限制以及跨语言数据传输的成本,都可能让一个在实验室里表现良好的模型在部署时掉链子。METIS-Core 的思路是让整个训练和推理都跑在 C++ 里,绕开这些结构性问题。
核心技术特性
METIS-Core 的设计围绕几个关键点展开。
零 Python 开销与原生 LibTorch 集成
框架直接构建在 PyTorch 的 C++ API(LibTorch)之上,完整利用其张量运算和自动求导引擎来训练神经网络。这意味着开发者仍然能享受 PyTorch 生态的成熟能力,但执行时不再需要 Python 解释器介入。作者强调,这套设计专门面向对实时性和低延迟有硬性要求的系统。
LibTorch 是 PyTorch 官方提供的 C++ 前端库,它将 PyTorch 的张量运算、自动微分(autograd)、神经网络模块(nn::Module)以及 CUDA 加速全部封装成纯 C++ API,无需任何 Python 运行时即可使用。开发者可以用它构建、训练和推理神经网络,导出的模型文件(TorchScript 格式)也与 Python 端完全兼容,方便在两套环境之间互操作。LibTorch 的主要使用场景正是游戏引擎、工业控制器和嵌入式系统等对 Python 依赖敏感的环境。值得注意的是,LibTorch 的 C++ API 文档完备度和社区讨论活跃度显著低于 Python 前端,调试体验也更为繁琐——这是选择该技术路线时需要预先评估的工程成本。
基于张量的抽象层
METIS-Core 采用了一种数学层面的解耦设计:智能体只处理纯张量状态,其"智能"部分完全与具体应用场景无关。这种上下文无关(application-agnostic)的抽象让同一套核心逻辑可以适配机器人、交易、物流、国防等差异极大的领域,只需在外层适配状态和动作的张量表示即可。
共享主干的多头架构
针对多智能体协作场景,框架内置了 Shared-Trunk Multi-Head 架构支持——多个智能体共享同一个神经网络主干,从而学习联合协调策略。这是 MARL 研究中常见的参数共享思路,能在协作任务中提升样本效率和策略一致性。
多线程 MCTS 的 AlphaZero 引擎
框架还实现了一个原生运行的 AlphaZero 自对弈循环,其中蒙特卡洛树搜索(MCTS)以多线程方式在 C++ 中执行。把 MCTS 这类计算密集且高度并行的搜索过程放到 C++ 里,理论上能比 Python 实现获得可观的性能收益。
AlphaZero 是 DeepMind 于 2017 年提出的通用棋类博弈算法,核心思路是将深度神经网络(同时输出策略分布和局面价值)与蒙特卡洛树搜索(MCTS)结合,通过纯自对弈迭代提升,无需任何人类先验知识即可达到超人水平。MCTS 在每一步决策时构建一棵模拟搜索树:从当前局面出发,反复进行"选择—扩展—模拟—回传"四阶段,利用神经网络的策略输出指导节点选择,用价值输出替代随机 rollout 来估计局面优劣,从而在有限时间内集中搜索高价值分支。这一过程天然适合并行化——多线程可以同时展开不同路径的模拟,但需要处理树节点的并发写入和虚拟损失(virtual loss)等同步问题,这也是 C++ 实现相对 Python 更具优势的环节之一。
当前进度与里程碑
从版本记录看,项目仍处于 alpha 阶段,但已经有清晰的迭代路径:
- v0.3.0 / v0.3.1-alpha(AlphaZero 与多线程 MCTS):集成了 C++ 版本的 AlphaZero 自对弈循环,并在 Los Alamos Chess(6×6 棋盘)这一基准环境上完成验证。选择这个环境是为了在战术复杂度和本地硬件效率之间取得平衡。
- v0.2.0-alpha(MARL 与共享主干):实现了多头神经网络架构,并提供了名为 "SwarmDefenseTIE" 的参考场景,让多个智能体学习协作式防御运输战术来对抗攻击者。
- v0.1.2-alpha(DQN 与快速上手):包含 "Treasure Hunter" 和 "PursuitPolice" 等极简单文件环境,方便新用户快速入门。
这种从 DQN 到 MARL 再到 AlphaZero 的演进顺序,基本覆盖了强化学习从单智能体到多智能体、从无模型到基于搜索的主要范式。
路线图:PPO 与非对称 MARL
作者列出了两个明确的下一步方向。
第一是 AlphaZero 非对称 MARL,即把多头网络与 MCTS 融合,用于智能体拥有完全不同动作空间和目标的非对称场景,例如异构实体之间的对抗。这类场景在实际的博弈和对抗建模中相当普遍,也是当前 MARL 研究的难点之一。
第二是加入 近端策略优化(PPO),从而支持连续动作空间。这一点对机器人和物理仿真尤为关键——离散动作的 DQN 和 AlphaZero 无法直接处理高精度连续控制,而 PPO 是业界处理连续控制的主流算法之一。
近端策略优化(PPO)由 OpenAI 于 2017 年提出,是目前处理连续动作空间强化学习任务的主流算法之一。它属于策略梯度方法,通过引入"裁剪"机制限制每次策略更新的幅度,在保证训练稳定性的同时避免过大的策略跳变——这正是早期策略梯度方法(如 REINFORCE)的主要缺陷。与 DQN 只能输出离散动作不同,PPO 可以直接对高斯分布等连续分布进行参数化,自然支持机械臂关节角度、推力大小等高维连续控制量。PPO 在 OpenAI Five(Dota 2)、MuJoCo 物理仿真等标志性任务上均取得了强基线表现,因此成为机器人和物理仿真领域的事实标准算法之一。METIS-Core 一旦完成 PPO 集成,其应用场景将从棋盘博弈大幅延伸至连续控制领域。
值得关注的意义与保留判断
METIS-Core 切中了一个真实存在的工程痛点:Python 优先的 RL 生态在部署侧的短板。对于需要把强化学习落地到边缘设备或实时系统的团队,一个原生 C++ 框架能省去大量繁琐的模型导出、序列化和跨语言桥接工作。
不过也要客观看待。项目目前仍是个人开发的 alpha 阶段作品,基准验证局限在 6×6 象棋这样的小规模环境,距离"生产级"还有相当距离。LibTorch 的 C++ 开发体验、文档完备度、社区支持都是需要观察的变量。作者本人也在帖子中主动征求反馈,说明框架仍在积极打磨中。
对于关注 RL 部署工程化的开发者,这个项目至少提供了一个有价值的参考实现,值得在 GitHub 上跟踪其后续进展。
相关推荐
Claude Code 支持读取 AGENTS.md:AI 编程配置走向标准化
Claude Code 现已支持在缺少 CLAUDE.md 时读取 AGENTS.md 配置文件,标志着 AI 编程工具配置走向标准化。本文解析这一改动的意义、生态博弈及对开发者的实际影响。
vLLM v0.30.0rc2 发布:修复NIXL通知请求处理问题
vLLM 发布 v0.30.0rc2 候选版本,核心修复 NIXL 传输层对通知类请求的处理逻辑,避免冗余接收报告。本文解读该更新内容、NIXL 作用及对分离式推理部署的影响。
自托管日历软件怎么选?开源方案与需求要点解析
想要一款开源、自托管、支持 iCal 集成和安卓同步的日历软件?本文拆解自托管日历的核心需求、CalDAV 技术路线与选型权衡维度,帮你在开源方案中找到最适合的组合。